量子生成模型合成医学图像:癌症检测AUC提升至80.2%

量子生成模型合成医学图像,训练分类器AUC-ROC反超真实数据基线。
该研究针对乳腺癌超声图像数据集中恶性样本不足的问题,探索了生成式量子机器学习在数据增强中的应用。研究者在BUSI数据集上使用量子生成模型合成图像,并设计三种训练方案对比:仅真实数据、仅合成数据、混合数据。结果显示,完全使用合成图像训练的CNN在真实测试集上达到0.802的AUC-ROC,超过仅用真实数据训练的0.760基线。这一反直觉发现挑战了真实数据永远优于合成数据的默认假设。论文提出量子模型通过高维希尔伯特空间表示和量子纠缠捕捉特征相关性,为医学图像增强提供了新思路。研究采用量子作为组件的务实路线,但合成图像质量评估和训练成本等关键信息尚未披露。
当癌症图像数据不够用时,量子生成模型能做什么?
医学AI领域有一个长期存在的困境:高质量的恶性样本太少了。在乳腺癌超声图像数据集中,良性样本往往是恶性样本的数倍,这种类别不平衡直接导致分类器对恶性病变的识别能力不足。更棘手的是,医学图像的标注需要专业放射科医生逐张判读,扩充数据集的成本极高。
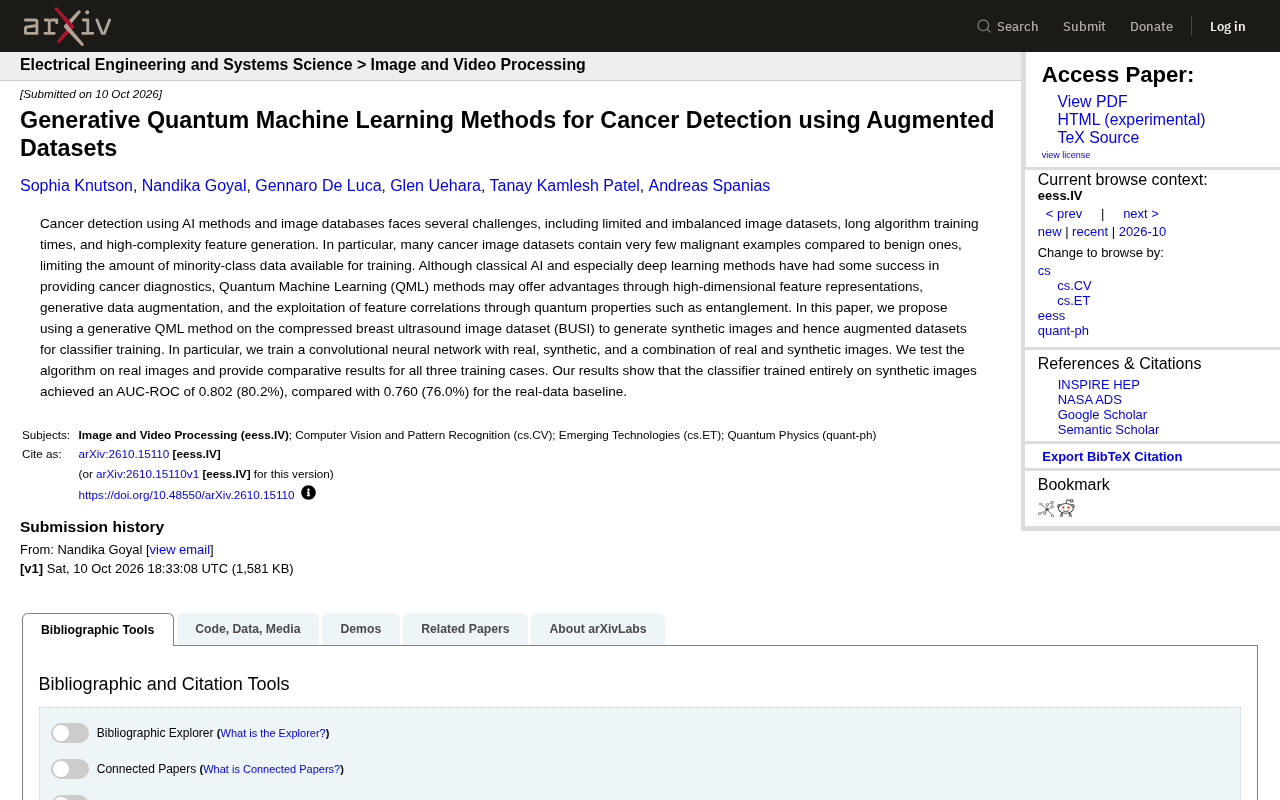
一篇关于生成式量子机器学习(Generative QML)应用于癌症检测的研究,提供了一条值得关注的新路径。研究者利用量子生成模型在压缩乳腺超声图像数据集(BUSI)上生成合成图像,并用这些合成数据训练分类器,最终在真实测试集上取得了优于纯真实数据基线的表现。
为什么是量子生成模型?
经典方法的瓶颈
深度学习在医学影像诊断中已有不少成功案例,但它对数据的渴求同样苛刻。数据增强(旋转、翻转、裁剪)虽然能缓解样本不足,却无法创造真正新的特征分布——翻转后的肿瘤图像仍然是同一张肿瘤图像。传统的生成对抗网络(GAN)可以合成图像,但训练不稳定、模式崩溃等问题在医学图像这种精细纹理场景中尤为突出。
量子特性的潜在优势
论文指出,QML方法可能通过三个机制带来优势:高维特征表示、量子纠缠对特征相关性的捕捉、以及生成式数据增强。量子态天然存在于指数级增长的希尔伯特空间中,这意味着在相同参数数量下,量子模型可以表达更复杂的概率分布。对于医学图像中恶性肿瘤边界模糊、纹理复杂的特点,这种高维表示能力可能有实际价值。
这个思路的本质不是用量子计算机替代经典神经网络,而是用量子生成模型作为一个更强的"数据工厂",为经典分类器提供高质量的合成训练样本。
希尔伯特空间与量子态的高维表示
希尔伯特空间是量子力学描述量子态的数学框架。一个由 n 个量子比特组成的系统,其状态存在于一个 2^n 维的复向量空间中。这意味着每增加一个量子比特,可表示的基态数量就翻一倍,呈指数级增长。经典模型若要表达同等维度的概率分布,所需的参数量会随维度线性甚至更高阶增长。量子模型借助这种指数级状态空间,在参数数量相近的情况下可以覆盖更广的概率分布形态。对于恶性肿瘤边界模糊、纹理高度复杂的医学图像,这种表示冗余度可能帮助模型捕捉经典模型容易遗漏的细微模式。需要注意的是,NISQ 时代的量子硬件在比特数、相干时间和门保真度上都有严格限制,因此这类优势目前更多停留在理论和小规模实验层面。
量子纠缠与特征相关性
量子纠缠是指多个量子比特之间形成的非经典关联:对一个比特的测量结果会瞬时影响另一个比特的状态,无论它们之间距离多远。在生成模型的语境下,纠缠可以被视为一种内置的特征相关性机制。医学图像中,肿瘤的边界、内部纹理和周围组织往往存在复杂的空间相关性,经典模型需要靠卷积核或注意力层显式建模这些关系。量子生成模型通过纠缠操作,有可能在状态准备阶段就把这类相关性编码进量子态,从而在生成合成样本时更自然地保留这些结构。不过,纠缠是否真的比经典相关性建模更高效,目前尚无定论,取决于具体任务和电路设计。
实验设计与核心结果
训练策略
研究团队设计了三种训练方案进行对比:仅使用真实图像训练、仅使用合成图像训练、以及真实与合成图像混合训练。分类器采用卷积神经网络(CNN),测试集全部使用真实图像,以确保评估结果反映的是模型在真实临床场景中的表现。
关键数据
最引人注目的结果是:完全使用合成图像训练的分类器,在真实测试集上达到了0.802的AUC-ROC,而仅使用真实数据训练的基线为0.760。合成数据训练的模型反而比真实数据训练的模型表现更好,这看起来反直觉,但可能的解释是:量子生成模型产生的合成样本在一定程度上缓解了类别不平衡问题,使得分类器在训练中接触到了更具代表性的恶性样本分布。
AUC-ROC从0.760提升到0.802,绝对提升约4.2个百分点。在医学影像诊断中,这个幅度的提升如果是可复现的,具有实际意义——它可能意味着更少的漏诊。
AUC-ROC 指标的含义与临床解读
AUC-ROC 是评估二分类模型整体性能的常用指标,取值范围在 0.5 到 1.0 之间。0.5 代表随机猜测,1.0 代表完美区分。它衡量的是模型将随机一个正样本排在随机一个负样本前面的概率,因此对类别不平衡不敏感——这正是它在医学影像诊断中备受青睐的原因。从 0.760 提升到 0.802,意味着在随机抽取一对恶性与良性样本时,模型正确排序的概率从 76% 提高到约 80%。在临床场景中,这一提升可能转化为更高的恶性病灶检出率,或更低的假阴性率。不过,AUC-ROC 是全局指标,无法反映模型在特定阈值下的灵敏度与特异度权衡,实际部署时还需结合临床需求选择工作点。
FID 分数与生成图像质量评估
FID(Fréchet Inception Distance)是评估生成图像质量的常用指标,通过比较真实图像和生成图像在 Inception 网络特征空间中的分布距离来衡量合成样本的逼真程度。FID 越低,说明生成分布越接近真实分布。论文未披露 FID 分数,意味着读者无法直接判断量子生成模型产生的合成图像在视觉和统计层面到底有多接近真实超声图像。缺少这一指标,合成数据优于真实数据的结果就难以排除一种可能:合成样本恰好以某种方式正则化了分类器,而非真正提供了高质量的恶性样本。未来研究若能同时报告 FID、精确率与召回率等指标,将更有助于判断合成数据的实际价值。
这项研究真正值得关注的地方
合成数据不只是"替补"
这项工作最反直觉的发现是:合成数据不仅仅是数据不够时的替补方案,它在特定条件下可以超越真实数据的训练效果。这挑战了"真实数据永远优于合成数据"的默认假设。当然,这需要更多独立研究来验证——单次实验的结果可能受到数据集规模、合成模型质量、甚至随机种子选择的影响。
量子机器学习的务实切入点
当前量子计算硬件仍处于含噪声中等规模量子(NISQ)阶段,量子机器学习领域不乏过度承诺。这项研究的可贵之处在于它选择了一个务实的问题:不是用量子算法替代整个诊断流程,而是用量子生成模型解决一个具体的瓶颈——数据增强。这种"量子作为组件"的思路,比"量子替代一切"的叙事更可能在实际中产生价值。
尚未回答的问题
论文没有披露合成图像的具体质量评估指标(如FID分数),也没有讨论量子生成模型的训练成本与传统GAN的对比。此外,BUSI数据集的规模相对有限,该方法能否推广到更大规模、更多癌种的图像数据集上,仍是未知数。
对医学AI发展的启示
这项研究传递出一个信号:在医学AI领域,数据质量问题可能比模型架构选择更关键。当整个社区都在追逐更大的模型和更复杂的注意力机制时,从数据生成的角度切入,用量子生成模型来改善训练数据的分布和质量,可能是另一条值得投入的路径。
对于关注AI医疗应用的开发者和研究者,实际可操作的启发是:在数据不平衡场景下,值得尝试将生成式方法(无论是经典GAN还是量子生成模型)作为数据预处理环节,而非仅仅依赖损失函数加权或采样策略来处理类别不平衡。合成数据在训练中的角色,可能比我们此前认为的更加主动。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。