LiFi:多视角图像生成LiDAR点云新框架

LiFi 提出几何与语义双分支协同引导的潜在扩散框架,从多视角图像生成高保真 LiDAR 点云。
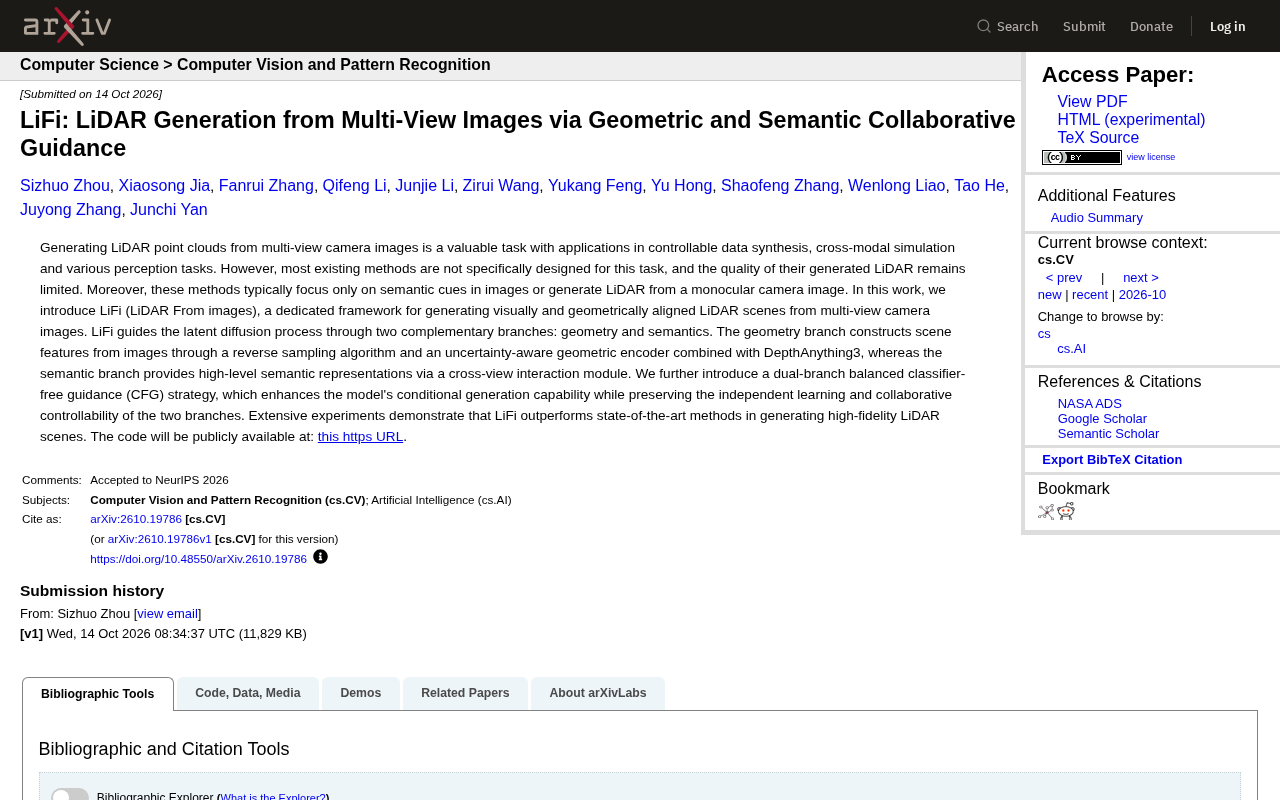
LiFi 是专为从多视角相机图像生成 LiDAR 点云而设计的框架,针对现有方法仅依赖语义线索或单目输入、几何一致性不足的问题,提出几何与语义双分支协同引导潜在扩散过程。几何分支采用反向采样与不确定性感知编码器,结合 DepthAnything3 提供可靠深度先验;语义分支通过跨视角交互模块捕捉多视角语义一致性。两者共同条件化扩散模型,并配合双分支平衡的无分类器引导策略,实现独立优化与协同可控。实验表明 LiFi 在生成高保真 LiDAR 场景方面优于现有最先进方法,代码将在 GitHub 开源。该工作有望降低自动驾驶 LiDAR 数据获取成本,推动可控数据合成与跨模态仿真。
从多视角相机图像生成LiDAR点云,是自动驾驶感知、跨模态仿真和可控数据合成中的关键任务。然而,现有方法大多并非为这一任务专门设计,生成的LiDAR质量有限;它们通常只利用图像中的语义线索,或仅从单目相机图像生成LiDAR,忽略了多视角几何信息的重要性。
近日,一篇题为《LiFi: LiDAR Generation from Multi-View Images via Geometric and Semantic Collaborative Guidance》的论文提出了LiFi框架,试图从根本上解决这一问题。
LiFi的核心思路:几何与语义双分支协同
LiFi(LiDAR From images)是一个专为从多视角相机图像生成视觉与几何对齐LiDAR场景而设计的框架。它的核心创新在于通过两个互补分支——几何分支和语义分支——共同引导潜在扩散过程。
这种双分支设计与以往仅依赖单一信息源的方法形成鲜明对比。论文指出,现有方法"typically focus only on semantic cues in images",导致生成结果的几何一致性不足。LiFi通过显式引入几何引导,弥补了这一缺陷。
关于潜在扩散模型(Latent Diffusion Model)
潜在扩散模型(LDM)是 Stable Diffusion 等主流生成模型的基础架构。其核心思想是先用一个自编码器(通常是 VAE)将高维数据(如图像、点云)压缩到低维潜在空间,再在潜在空间中执行扩散与去噪过程。这样做的好处是大幅降低计算量,同时保留生成质量。LiFi 面向 LiDAR 点云生成,同样采用潜在扩散框架:几何与语义双分支提供的条件信息被注入到去噪网络的每一层,引导潜在变量逐步还原为与输入图像对齐的 LiDAR 场景。理解 LDM 的两阶段结构(编码压缩 + 潜在空间扩散)有助于把握 LiFi 如何将多模态条件与生成过程结合。
几何分支:反向采样与不确定性感知编码
几何分支负责从图像中构建场景特征。具体来说,它采用了反向采样算法,并结合了一个不确定性感知的几何编码器。该编码器整合了DepthAnything3的深度估计能力,从而为扩散过程提供可靠的几何先验。
这一设计的巧妙之处在于"不确定性感知":深度估计本身存在噪声和误差,直接使用可能引入伪影。LiFi通过感知不确定性来加权几何特征,提升了生成点云的几何保真度。
关于 DepthAnything3 与深度估计先验
DepthAnything 系列是近年来广受关注的单目深度估计基础模型,其核心思想是利用大规模、多样化的图像数据(含标注与未标注)进行训练,从而获得强泛化能力的相对深度预测。DepthAnything3 是该系列的最新迭代,在多视角一致性和深度精度方面进一步优化。在 LiFi 中,它被用作几何分支的深度先验来源:模型先从每张输入图像预测深度图,再将深度图反投影为三维点,构成场景的几何骨架。之所以不直接端到端从图像回归 LiDAR,是因为显式深度先验能显著降低扩散模型学习三维几何的难度,同时让几何分支的输出具有明确物理意义,便于后续与语义分支融合。
语义分支:跨视角交互模块
语义分支则专注于提供高层语义表示。它通过一个跨视角交互模块,在不同视角之间建立关联,捕捉场景的语义一致性。
这种跨视角交互对于多视角输入至关重要——单个视角的语义信息可能不完整,而多视角融合可以显著提升语义理解的全面性。两个分支各司其职,又相互补充,共同为扩散模型提供条件引导。
关于跨视角交互与多视角融合
跨视角交互模块通常基于注意力机制实现:将不同相机视角提取的特征视为序列,通过自注意力或交叉注意力让各视角互相查询、交换信息。其目的是解决单视角语义不完整的问题——例如,某物体在一个视角中被遮挡,但在另一视角中可见。通过跨视角聚合,模型能构建出更完整、更一致的三维语义场。这一思路与自动驾驶中常用的 BEV(鸟瞰图)感知范式一脉相承,但 LiFi 将其用于生成任务的语义条件构建,而非直接输出检测结果。跨视角交互还能隐式编码相机位姿与场景结构的关系,使语义分支提供的条件与几何分支在空间上对齐,为后续双分支融合奠定基础。
双分支平衡的无分类器引导策略
LiFi还引入了一种双分支平衡的无分类器引导(CFG)策略。这一策略在增强模型条件生成能力的同时,保留了两个分支的独立学习和协同可控性。
传统的CFG策略通常针对单一条件设计,而LiFi的双分支平衡CFG需要同时协调几何和语义两个条件。论文强调,这一策略使模型既能独立优化每个分支,又能实现两者的协同控制,从而在生成质量和可控性之间取得平衡。
关于无分类器引导(CFG)
无分类器引导(Classifier-Free Guidance, CFG)是扩散模型中的一种条件采样技术。训练时模型同时学习有条件与无条件(即条件被随机丢弃)的去噪过程;采样时,将两者的预测按一定权重线性外推,从而在保持样本多样性的同时增强对条件的遵循程度。引导强度 ω 越大,生成结果越贴近条件,但过大可能导致过饱和或模式坍塌。LiFi 的创新在于条件并非单一,而是几何与语义两路。若直接沿用标准 CFG,需要选择统一的引导权重,难以兼顾两类条件的贡献差异。LiFi 因此设计双分支平衡策略,为几何与语义分别设定可调的引导系数,并引入平衡机制防止某一分支主导,从而在几何保真度与语义一致性之间实现更细粒度的控制。
实验表现与开源计划
据论文所述,大量实验表明LiFi在生成高保真LiDAR场景方面优于现有最先进方法。虽然摘要中未披露具体量化指标,但作者表示代码将在GitHub上公开(https://github.com/szzhou88/LiFi),这为后续复现和对比提供了基础。
潜在应用与意义
LiFi的价值在于其应用场景的广泛性:可控数据合成、跨模态仿真以及各类感知任务。在自动驾驶领域,LiDAR数据采集成本高昂且标注困难,从多视角图像生成高质量LiDAR点云可以大幅降低数据获取门槛。
跨模态仿真方面,LiFi能够帮助构建更真实的仿真环境,用于感知算法的训练和测试。此外,几何与语义协同引导的思路也可能启发其他跨模态生成任务的研究。
随着代码开源,LiFi有望成为多视角图像到LiDAR生成领域的一个重要基线,推动该方向的可复现研究和实际落地。
相关推荐

B站保姆级Codex攻略:从安装到实战,让AI帮你操作电脑
基于B站保姆级教程,详解Codex从安装、工作模式设置到项目文件夹管理、文件整理、计划模式与可视化仪表盘的完整实战流程,附使用心法与注意事项。

Agent Skills渐进式披露架构详解:让AI智能体拥有无限能力
详解Agent Skills渐进式披露架构:从什么是Agent Skills、解决什么问题,到如何定义Skills列表与调用工具,并对比Multi-Agent的区别,帮助开发者快速掌握这一AI智能体能力扩展方案。
Agent Loop面试十连问:B站最细Loop Engineering教程拆解
B站Agent Loop面试十连问教程拆解:从生命周期、工具、记忆、交付物四个维度讲清Agent Loop与单次API调用的本质区别,附可直接套用的面试回答模板,帮你在Loop Engineering面试中少走弯路。