零成本AI视频工作流:两个月商单破万的实操拆解

B站UP主分享仅用豆包智能体与Cdance 2.5从零到月商单破万的AI视频标准化产线。
文章拆解了一位B站创作者仅用豆包智能体搭配内置Cdance 2.5模型、从零做到月商单破万的完整AI视频工作流。核心观点是AI视频的瓶颈不在画面质量而在流程标准化:选题应基于近30天百万播放爆款做结构化对标而非凭空创作;大纲用四段式结构提前锁定注意力曲线;分镜坚持一镜一内容并用母版加引用保证风格一致;生成视频前必须批量制作统一图片资产以避免人物变脸和色调割裂;后期统一色温饱和度与响度参数并导出1080p 60帧;发布时填写AI创作声明、用高光画面做封面以提升初始流量。作者强调这套流程的内核是产线思维,工具会迭代但可复用的颗粒度管理方法不变,个体收入结果不宜直接作为预期。
AI视频赛道从不缺教程,缺的是能跑通商业闭环的标准化流程。B站一位创作者分享了自己从零到月商单破万的完整工作流,全程只用豆包工作上的智能体搭配内置Cdance 2.5模型,不需要专业绘画基础,也不涉及多软件切换。这套流程的价值不在于工具本身,而在于把选题、大纲、分镜、资产、生成、后期串成了一条可复制的产线。
选题决定流量上限,而非画面质量
很多新手把精力全砸在画面上,却忽略了最前置的环节。据该UP主观察,AI视频没流量的根本原因往往是选题老旧、缺少冲突和看点,观众几秒内就划走。他的做法是打开短视频排行平台,锁定目标赛道,筛选近30天100万播放以上、评论量高的爆款AI短剧,把标题、开篇钩子、核心剧情梗概整理成参考素材,再交给AI批量生成选题并打分。
这一步的本质是用数据验证过的爆款结构做模仿,而非凭空创作。结构化口令词在这里扮演关键角色——把赛道、对标素材、评分维度写清楚,AI输出的选题才有可筛选性。
结构化口令词(Structured Prompt)是指将任务拆解为明确的字段和约束条件,而非用自然语言随意描述。在选题环节,它通常包含赛道定位、对标素材特征、评分维度(如冲突强度、反转次数、情绪钩子类型)等字段。这种写法的优势在于把模糊的“帮我写个选题”转化为可比较、可打分的输出,让AI批量生成的结果具备筛选价值。对新手而言,结构化口令词是弥补经验不足的杠杆——它强迫创作者在提问前先想清楚判断标准。
大纲是新手最容易跳过的关键步骤
跳过内容大纲直接写脚本,结果往往是成片逻辑混乱、重点模糊。该UP主强调,爆款视频需要提前规划整体节奏,开头三秒必须有强钩子抓眼球。如果脑中没有画面,可以用结构化口令让AI分段搭建大纲,口令中要明确四件事:作品类型、四段式结构、时长分配、内容方向。
四段式结构配合时长分配,本质上是在脚本阶段就锁定了观众的注意力曲线。这一步做扎实,后续分镜才不会跑偏。
一镜一内容:分镜提示词的母版思维
普通提示词最容易导致画面与台词脱节、镜头混乱。该UP主的脚本坚持“一镜一内容”,提示词母版中固定风格氛围、画质、声音描述,画面提示词则包含分镜数、时间区间、景别、机位、焦段、景深、光线、画面内容和声音。声音部分他会明确写“全程无背景音乐”,避免AI自行添加。
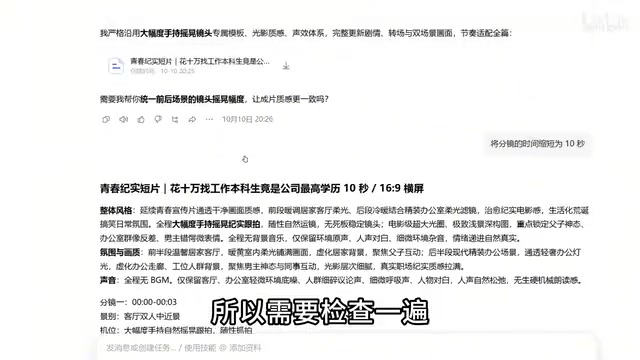
提示词生成后必须手动检查三件事:镜头之间剧情是否连贯、画面描述能否匹配台词、有没有被AI多余润色。AI偶尔会按自己的理解修改提示词和台词,这部分润色未必符合创作意图。一旦跑通一个模板,就可以用引用功能附上提示词,让AI延续同一模板处理下一段剧情。
景别、机位、焦段、景深是影视镜头语言的四个基础参数。景别指被摄主体在画面中的占比(远景、全景、中景、近景、特写),决定观众与角色的心理距离;机位是摄影机相对主体的位置(平视、俯视、仰视),影响权力关系和情绪倾向;焦段决定透视压缩感,长焦压缩背景、广角夸张空间;景深控制虚实层次,浅景深突出主体、深景深交代环境。在AI视频提示词中写明这四项,能显著降低模型自由发挥导致的镜头混乱,也是“一镜一内容”可执行的技术基础。
统一图片资产:批量出片的隐藏前提
边生成画面边做视频,是人物变脸、穿搭跳变、风格割裂的直接原因。正确顺序是在生成视频之前,先用AI批量制作全套图片资产:固定主角配角的五官、发型、服饰,统一整部剧的画风滤镜色调,同时备好剧情关键场景。这套资产既保证成片连贯,也大幅提升批量出片效率。
动态视频生成阶段,该UP主全程使用内置Cdance 2.5模型的工具,适配漫剧创作场景,导入统一图片资产和提示词后自动渲染动态镜头。据其描述,人物动作更自然、运镜更流畅、画面稳定性明显提升。
Cdance 2.5 是字节跳动推出的视频生成模型(即 Seedance 系列),支持文生视频与图生视频,在运镜连贯性和物理合理性上有针对性优化,常被集成在豆包等智能体工具中供创作者直接调用。对漫剧类创作而言,它的图生视频能力尤为关键:导入统一角色资产后,模型以参考图约束人物外观,减少跨镜头变脸。理解模型的能力边界——它擅长动态渲染但不擅长凭空保持角色一致性——才能明白为什么“资产前置”是流程中不可省略的一步。
后期与发布:被低估的质感分水岭
AI生成的初版视频只是半成品。该UP主的后期实操包括:一两个镜头不满意时用抽卡视频拼接以降低token消耗;统一全片色温饱和度;响度统一到0分贝左右,背景音乐控制在-12分贝左右并加淡出;最终导出1080p 60帧。这些参数看似琐碎,却是成片与“可接商单质感”之间的距离。
发布环节同样影响初始流量。封面选剧情高光画面,画面干净、主题清晰,不堆砌文字标签,搭配简洁大字或手写质感字体加人物画面。发布时填写AI创作声明,据该UP主经验,初始流量会明显优于同类新手作品。
响度标准化(Loudness Normalization)是音频后期的基础操作。人声对白通常以0分贝为峰值参考,背景音乐压到-12分贝左右,是为了在混音中拉开对白与配乐的动态差距,避免BGM盖过台词。淡出处理则防止片尾音乐戛然而止造成的听觉突兀。平台上传后还会进行二次响度归一化,若原始混音动态过大,归一化后容易出现对白忽大忽小。因此前期按统一标准混音,是保证成片在各平台听感一致的前提,也是“可接商单质感”在音频维度的具体体现。
这套流程真正可复用的部分
工具会迭代,模型会更新,但这套工作流的内核是产线思维:选题靠数据对标而非灵感,大纲锁定节奏,分镜模板保证一致性,资产前置避免风格漂移,后期参数标准化。对零基础创作者而言,它的门槛不在于技术,而在于是否愿意把每个环节拆到可执行、可检查的颗粒度。该UP主提到的“第一个月接广告、两个月商单破万”是单一来源的个体结果,不宜直接作为预期,但流程本身的标准化程度值得借鉴。
相关推荐
让Agent当导演:本地AI全流程制片工作站构想
B站UP主构想用英伟达RTX Spark搭建本地AI导演工作站,让Agent统筹剧本、分镜、视频生成、配音、自动剪辑与审片,实现AI全流程制片。本文分析其技术链路、可行性瓶颈与行业信号。
百万电梯维保背后:TK Elevator如何用AI盘活数十年知识
百万电梯维保背后:TK Elevator如何用AI盘活数十年知识
TK Elevator在科隆分享如何利用技术让维保技师快速获取数十年共享知识,减少搜索时间、提升电梯与扶梯维保效率。本文分析其知识复用逻辑及对AI落地现场服务的启示。

NVIDIA GTC柏林焦点:Microduck双足机器人如何革新强化学习
NVIDIA GTC柏林站上,Pollen Robotics的Microduck双足机器人成为焦点。这款专为强化学习设计的开发工具,以微型双足平台降低研究门槛,配套软件栈兼容主流RL框架,展现从仿真到实体的闭环潜力。