零成本本地Jarvis:开源语音克隆与任务自动化实战
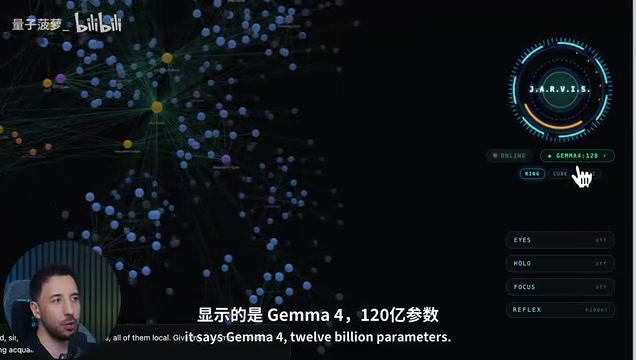
Jarvis用Ollama与Voice Studio把大模型和语音克隆搬进本地,零API成本实现可切换的离线AI助手。
文章介绍了AI Workshop频道展示的本地AI助手Jarvis:它用开源框架Ollama在本地运行Qwen 3.5 9B、Gemma 12B等模型,并支持通过语音指令在云端与本地模型间动态切换;语音层则从付费的ElevenLabs迁移到开源的Voice Studio,上传5到15秒音频即可克隆音色,且人格化回复风格得以保留。三项实测分别验证了本地文件检索、Google Calendar工具调用和Reverse Engineering Anything网页逆向拆解能力。文章同时指出硬件性能决定延迟与可用模型规模,9B是多数设备的演示基线;本地化换来零账单与数据不出本机,代价是设备在线依赖和工具调用质量仍逊于云端顶级模型。
本地AI助手的新范式:当Jarvis学会离线思考
本地AI助手正在从概念走向可落地的个人工具。AI Workshop频道展示的Jarvis,通过将大模型与语音克隆全部迁移到本地,实现零API成本运行。核心在于两个开源组件:Ollama负责本地模型调度,Voice Studio负责语音克隆。据UP主Zubair Trabzada演示,Jarvis可在本地模型与云端模型间自由切换,并保留工具调用与人格化回复能力。
通过Ollama可筛选并下载可本地运行的模型,覆盖不同参数规模。
本地大脑:模型切换与硬件门槛
Jarvis的"大脑"可动态切换。演示中,用户只需说"switch to your local brain",后台即从云端模型切至本地Qwen 3.5 9B;说"switch to Gemma 4 12B"则切换至另一本地模型。这种切换依赖Ollama的模型管理能力——用户可从Ollama模型库筛选本地可运行项,按机器性能选择0.8B到更大参数版本。据演示,Qwen 3.5 9B模型体积约7.6GB,下载后即可离线推理。
硬件差异直接影响体验。UP主使用Mac Studio级别设备,响应延迟较低;若在普通MacBook Pro(如M4芯片)上运行,延迟会明显增加。参数越大模型越聪明,但资源占用也越高。9B模型被选为演示样本,正是因其在多数设备上可跑通,同时保留基本工具调用能力。
演示中本地同时保留多个Gemma参数版本,可按需指定。
Ollama 是一个开源的本地大语言模型运行框架,它把模型权重下载、量化格式适配、推理引擎启动等步骤封装成统一命令行接口。用户通过 ollama pull 拉取模型后,Ollama 会在后台管理模型加载与显存分配,并以本地 API 形式对外提供服务。其模型库按参数规模与量化等级分类,同一模型常有 4-bit、8-bit 等不同体积版本,参数越大、量化越激进,对内存与算力的要求差异显著。文章中的“筛选 Local”即指在 Ollama 模型页勾选仅显示本地可运行项,避免误选需要云端算力的超大模型。
模型参数规模与硬件门槛的关系可以用经验法则理解:7B–9B 参数模型在 4-bit 量化下约需 6–8GB 内存,12B 模型则接近 10GB,而 70B 级别通常需要 40GB 以上统一内存或专业显卡。Mac Studio 与 MacBook Pro 的关键差异在于统一内存容量与内存带宽——M4 芯片的带宽低于 M 系列 Max/Ultra,因此加载同等模型时首 token 延迟和生成速度都会下降。这也解释了为何演示选择 9B 作为基线:它在多数消费级设备的内存预算内,同时保留了一定的推理与工具调用能力。
语音克隆:Voice Studio打破付费壁垒
语音层是另一成本大头。此前Jarvis通过ElevenLabs API合成语音,需持续订阅;切换至Voice Studio后,语音克隆完全本地化。Voice Studio是GitHub上热度飙升的开源项目(演示时位列 trending 第5),支持声音克隆、设计、配音、转录等功能。基础版免费,Pro版付费但基础版已满足个人使用。
克隆流程简单:上传5到15秒干净语音片段,即可生成自定义音色。演示中,Jarvis先在ElevenLabs克隆音色,又在Voice Studio克隆了"Jarvis"与"Zubair B"(UP主本人)两个音色。通过语音指令"switch to your local voice"或"switch your voice to Zubair B",即可实时切换。切换后,回复的幽默语气仍被保留——这意味着人格化提示词与本地语音可以共存。
语音克隆(Voice Cloning)通常指零样本或少样本声音复刻:模型从几秒参考音频中提取音色、韵律与音高特征,再将其迁移到新文本的合成语音上。主流方案基于神经声码器与说话人编码器,参考音频的质量(信噪比、无背景音乐、单一说话人)直接决定克隆相似度。5–15 秒是多数少样本模型的推荐区间——太短特征不足,太长则可能引入噪声。ElevenLabs 属于云端商业服务,按字符或订阅计费;Voice Studio 则将同类能力本地化,因此“免费”的本质是把推理成本转移到了本机算力上。
三项实测:文件读取、工具调用与逆向工程
演示包含三项任务测试本地组合是否接近云端表现。
文件检索:指令"pull up my brand voice"触发Jarvis访问本地"第二大脑"文件夹,返回品牌相关内容,验证本地文件交互能力。
工具调用:指令"pull up my calendar"触发Google Calendar工具。Jarvis准确列出次日三项日程(DFY service launch、11点团队同步、1点"busy"块、3点健身),并附带调侃式评论。界面显示"run via Google calendar",证明工具链在本地模型下仍可工作。
第三方工具集成:指令"reverse engineer igloo.inc"调用开源项目Reverse Engineering Anything(演示时约381.9k stars)。Jarvis自动打开浏览器滚动页面,REA在后台读取代码、识别技术栈(Three.js、GSAP、Svelte壳、bloom景深与抗锯齿),并生成完整拆解报告。UP主强调,这并非黑客行为,所有信息本就存在于浏览器开发者工具中,REA只是将其结构化呈现。
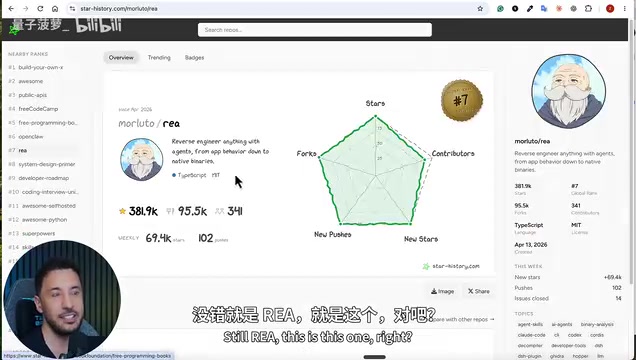
Reverse Engineering Anything在GitHub上星标数极高,演示时约381.9k。
工具调用(Tool Calling / Function Calling)是指大模型在对话中输出结构化的函数名与参数,由外部运行时执行后把结果回传给模型继续推理。文章中的 Google Calendar 查询、本地文件夹检索,都是模型先判断需要调用哪个工具,再由编排层实际执行。本地小模型在工具调用上的短板主要在于:参数规模小导致函数名与参数格式的遵循能力较弱,多步工具链容易中断。因此“能跑通”与“稳定可用”之间仍有差距,这也是演示中强调 9B 只是起点的技术原因。
部署路径与成本对比
搭建本地Jarvis分三步。第一步,安装Ollama并下载模型:访问Ollama官网注册,进入模型页筛选Local,搜索目标模型(如Qwen 3.5),复制ollama pull qwen3.5:9b命令执行。第二步,安装Voice Studio:从GitHub仓库获取一键安装命令(curl开头),粘贴至终端运行。第三步,用提示词包在Claude Code等工具中生成Jarvis前端与3D界面。
UP主提供免费提示词包,内含云端与本地Jarvis的功能对比、模型选择建议与安装指南。免费社区"AI Workshop Light"的Classroom区可获取;付费社区则提供打包好的Jarvis成品(5分钟安装)。
演示中Jarvis调用REA对目标网站进行自动化拆解,输出技术栈与交互逻辑。
本地化的边界与取舍
完全本地化并非没有代价。演示中UP主坦言,本地模型在工具调用上仍与云端顶级模型存在差距,9B参数只是"能跑通"的起点;若追求接近云端的推理质量,需更大参数模型与更强硬件。语音克隆的"免费"也限于基础功能,高级特性仍可能导向付费。此外,本地运行意味着设备休眠或关机时助手不可用,与云端7×24在线的体验不同。
但收益同样明确:无API账单、无订阅、数据不出本机。对于频繁使用助手且在意隐私的个人用户,这套开源组合提供了可自主掌控的替代方案。
相关推荐
DeepSeek Harness开源插件:让QQ群机器人看懂B站视频
一个开源的DeepSeek Harness插件,让QQ群机器人把B站视频切成分镜图、配台词和弹幕来“看懂”内容,还能搜索逛站、定时浏览,评论点赞等写操作默认关闭。
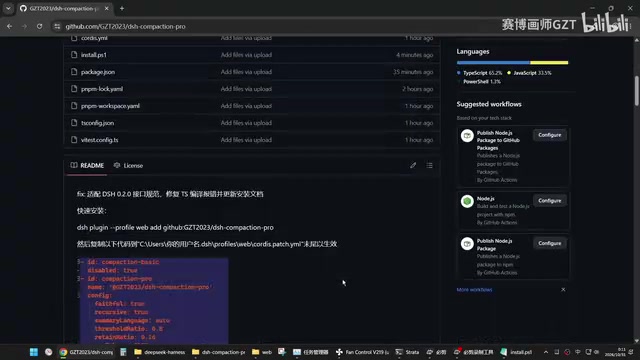
DeepSeek Harness 上下文精确压缩插件:安装与配置指南
B站UP主分享DeepSeek Harness上下文精确压缩插件的安装与配置方法,包括手动修改配置和脚本自动添加参数两种方式,以及禁用默认压缩的注意事项。
Google Zero反噬谷歌:AI搜索赚钱难,护城河正在崩塌
谷歌财报显示AI搜索变现能力不及传统搜索,股价承压。本文解析“Google Zero”如何反噬谷歌:AI概览同质化、停止向网络导流导致索引优势瓦解,传统搜索护城河正在消失。