零基础吃透扩散模型:从加噪到去噪的完整推导

扩散模型用加噪去噪取代GAN博弈,核心是预测噪声并借助闭式解高效训练。
本文系统梳理扩散模型的核心原理,解释其取代GAN的原因:GAN双网络博弈训练困难、损失波动大,而扩散模型以预测噪声为明确目标,更易收敛。文章详述前向过程如何逐步加噪并用闭式解直接计算任意时刻状态,反向过程如何借贝叶斯公式转化并用神经网络预测噪声,以及训练与采样流程。还介绍了UNet结构与时刻编码的作用,给出基于Fashion-MNIST的代码实现要点,并讨论模型的高斯噪声前提、近似误差及向文本生成等方向的延伸。
对抗生成网络(GAN)的热度在下降,扩散模型(Diffusion Model)成了生成模型领域绕不开的名字。从DALL·E系列带火这一方向开始,读懂扩散模型的原理和公式,已经成为理解现代图像生成技术的基本功。本文根据B站UP主的系统讲解,把扩散模型的核心逻辑完整梳理一遍,从加噪、去噪到代码落地,尽量避开论文里那些被省略的推导步骤。
为什么扩散模型取代了GAN
GAN的思路依赖生成器和判别器的博弈:生成器努力骗过判别器,判别器努力分辨真假。这种对抗机制带来了几个实际问题。训练过程涉及两个网络同时优化,收敛难度大;损失值来回波动,很难判断训练到什么程度算好;模型还可能学到训练者没有预期的捷径,导致生成结果的多样性变差。
扩散模型换了思路:先把图像一步步加噪变成纯噪声,再训练模型学会一步步去噪还原。相比GAN的双网络博弈,它的训练目标更明确——预测每一步加入的噪声。这个思路并不是新东西,2015年就有类似论文出现,但直到2022年DALL·E 2展示出惊艳效果,才真正引起大规模关注。
据B站UP主的分析,扩散模型的走红与DALL·E 2基于扩散模型构建直接相关;也有研究者坦言,GAN方向做了七八年,能挖的空间越来越窄,扩散模型成了新的主攻方向。
马尔可夫链是理解扩散模型前向与反向过程的基础数学框架。它指的是一系列状态构成的序列,其中每个状态只依赖于前一个状态,与更早的状态无关。扩散模型的前向过程正是这样一条马尔可夫链:x_t 仅由 x_{t-1} 决定,与 x_{t-2} 及更早的状态条件独立。这一性质使得每一步的转移概率可以单独写出,也为后续推导闭式解提供了便利。反向过程同样被建模为马尔可夫链,即从 x_t 还原 x_{t-1} 时只依赖当前时刻的状态。值得注意的是,严格来说反向过程只有在加噪步数足够多、每步噪声足够小时,才能近似为马尔可夫链,这也是扩散模型需要较多步数的原因之一。
前向过程:从图像到纯噪声
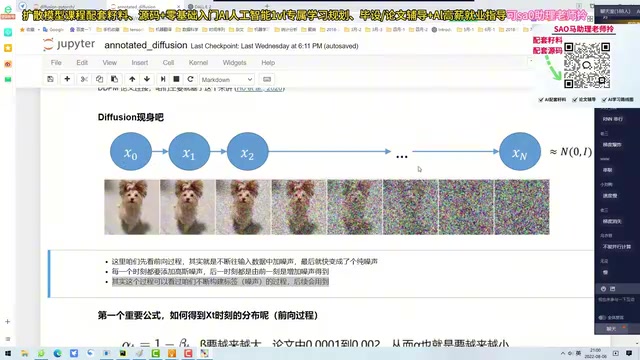
每一步加多少噪声
前向过程就是不断往图像里加噪声,直到原始分布彻底消失。关键在于,每一步加的噪声量并不相同:前期图像规律清晰,加一点点噪声就能明显改变分布;后期图像已经接近纯噪声,再加同样小的噪声几乎看不出变化。因此需要一个逐时刻增大的权重\beta_t来控制加噪幅度,论文给出的取值范围大约从0.001到0.002,按线性方式增长。
定义\alpha_t = 1 - \beta_t,则每一时刻的递推关系可以写成:x_t由前一时刻x_{t-1}与一个标准高斯噪声共同决定,两者各带一个权重系数。随着时刻t增大,前一时刻的权重下降,噪声的权重上升。
直接由x0算出任意时刻
如果老老实实按递推一步步算,就变成了类似RNN的串行结构,计算慢且梯度传递困难。原论文的一个关键贡献是推导出了闭式解:任意时刻x_t的分布可以直接由初始图像x_0表示,不需要走中间每一步。
推导方式是把相邻时刻的递推式反复代入并合并同类项。噪声项都是标准高斯分布,两个独立高斯分布相加,方差直接相加,因此多次合并后可以得到一个统一的表达:x_t等于根号下\alpha_t的累乘乘以x_0,加上根号下一减去\alpha_t累乘乘以一个标准高斯噪声。
这个公式意味着,给定初始图像和想要扩散到的步数,就能直接算出该时刻的噪声状态,中间过程不需要保存。
反向过程:从噪声还原图像
贝叶斯公式搭桥
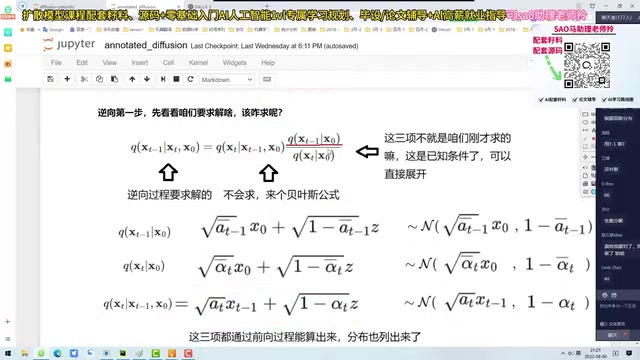
反向过程要解决的问题是:已知x_t,求x_{t-1}的分布。直接求是做不到的,但正向的x_{t-1}推x_t是已知的,因此可以用贝叶斯公式做转换,把难求的条件概率转成三个可计算项的乘积。
展开这三项后,每一项都对应一个高斯分布。通过配方和合并同类项,可以得到x_{t-1}的均值表达式——它同时依赖于x_t和x_0。这里出现了一个关键矛盾:x_0正是我们想求的目标,不可能当作已知条件。
高斯分布的两个关键性质支撑了扩散模型几乎所有推导。第一,两个独立高斯分布相加,结果仍是高斯分布,且均值相加、方差相加——这正是前向过程能把多步加噪合并为一步闭式解的根本原因。第二,给定一个高斯分布,若对其施加线性变换并加入独立高斯噪声,结果仍为高斯分布,这使得反向过程的条件分布可以被参数化为高斯形式。此外,在反向推导中对方差进行“配方”时,用到的也是高斯分布配平方的技巧:把均值与方差分离,从而得到均值关于 x_t 和 x_0 的显式表达式。理解这两条性质,论文里大量被省略的合并同类项步骤就不再神秘。
用模型预测噪声
解决办法是把x_0用x_t反向表示出来,代入均值公式。整理后发现,均值只与x_t和一个噪声项z_t有关,但z_t本身无法直接计算——我们只知道当前的x_t,不知道之前每一步加了什么噪声。
科学家在这里的处理方式是:既然公式推不出来,就让神经网络去预测这个噪声。训练一个模型,输入x_t和时刻t,输出对噪声的估计值。模型的训练需要标签,而标签恰好来自前向过程——加噪时生成的随机噪声本身就是已知的,直接保存下来即可作为真实值。损失函数就是预测噪声与真实噪声之间的差异。
变分下界(ELBO) 是扩散模型训练损失的理论来源。严格来说,扩散模型是一个潜变量模型,直接最大化对数似然不可行,因此转而最大化其变分下界。经过推导,ELBO 可以分解为多个时刻的 KL 散度之和,每一项衡量反向预测分布与真实后验分布之间的差异。原论文进一步简化,发现当把反向过程方差固定时,优化这些 KL 散度等价于最小化预测噪声与真实噪声之间的均方误差。这就解释了为什么最终损失函数形式如此简洁——它并非凭空设计,而是变分推断经过化简后的结果。理解这一层,才能明白“预测噪声”这个看似直觉的选择背后有严格的理论依据。
训练与采样流程
训练阶段从数据集中采样x_0,对每个样本随机选取一个时刻t,按前向公式加噪得到x_t,让UNet预测噪声,计算损失并反向传播更新参数。时刻t的随机化很重要,避免模型只学到固定步数的规律。
采样阶段从纯噪声出发,每一步用训练好的UNet预测噪声,结合当前时刻的系数计算均值,再加上一个缩放后的噪声采样得到x_{t-1},循环直到还原出图像。训练好的UNet在所有时刻共享参数,每次变化的只是输入。
UNet结构与时序编码
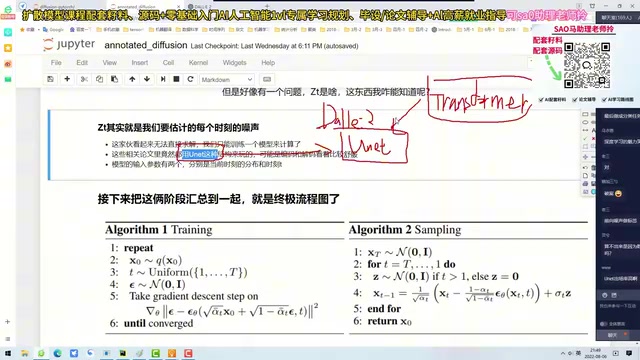
模型主体采用UNet:先下采样提取特征,中间经过若干卷积层,再上采样并拼接对应层特征。时刻t通过类似Transformer位置编码的正余弦编码转成向量,再与图像特征相加融合,让网络知道当前处于哪个加噪阶段。
UP主特别提到一个现象:扩散模型明明可以用更大的Transformer结构,论文却选择了UNet,甚至在UNet内部又加了一层简单的注意力模块,原因并没有在论文中充分解释。一个合理猜测是,任务本身只需要预测噪声,不需要过于复杂的网络容量。
位置编码在扩散模型中的作用常被低估。时刻 t 是一个标量,若直接输入网络,模型难以区分相邻时刻的细微差异。正余弦编码把 t 映射为高维向量,不同频率的正余弦函数使得每个时刻都有独特的模式,且相近时刻的编码也相近,便于网络平滑地泛化到未见过的步数。这与 Transformer 中处理词序位置的思路一致,区别在于扩散模型只编码一个时间维度。编码后的向量通常经过两层全连接和激活函数,再通过逐元素相加或拼接注入 UNet 的各个残差块,使每一层特征都能感知当前处于加噪的哪个阶段。
代码实现要点
用Fashion-MNIST这类28×28的灰度图数据集,在普通CPU上也能跑通完整流程。UP主演示的实现里,总扩散步数设为200,\beta从0.001线性增长到0.002,预先算好\alpha_t及其累乘、1减去累乘再开根号等系数,训练和采样阶段直接查表取用。
训练循环中,每个batch随机分配时刻,加噪、预测、算损失、更新参数。采样循环则从t等于最后一步开始倒序迭代,每次调用UNet预测噪声并计算前一步的分布,保存中间结果可以看到图像从纯噪声逐渐显现出服装轮廓的过程。
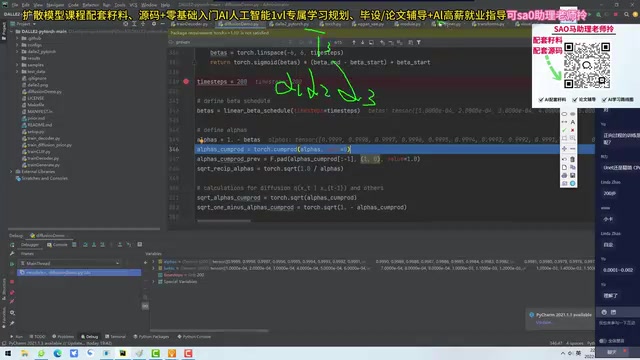
UP主也提到,自己最初看论文公式时一头雾水,是先理解代码再回头补数学才理顺的。对数学基础一般的读者,这个顺序可能比硬啃论文更有效。
扩散模型的边界与延伸
这套基础框架有明确前提:噪声必须服从标准高斯分布,换其他分布推导会困难得多。如果训练数据本身不符合高斯假设,模型的适用性也会受限。
反向过程的每一步都带有近似成分,预测噪声不可能完全准确,因此最终生成结果与原始图像会有差异,这也是生成质量依赖模型能力的原因。
扩散模型的延展性不止于图像生成。输入从随机噪声换成文本特征向量,就能做文本到图像的生成,DALL·E系列正是沿这个方向走通的。UP主提到,训练这类大模型对算力要求极高,个人复现难度很大,但原理层面已经清晰。
至于论文原文,UP主建议数学基础一般的读者谨慎尝试:原论文从概率论和信息熵的角度展开,大量中间推导被省略,直接阅读容易陷在局部公式里。先跟着通俗讲解建立整体框架,再回头对照论文,效率会高得多。
相关推荐
达芬奇如何证明太阳是热的?一段被忽视的科学史
达芬奇如何用凹面镜实验推翻亚里士多德的冷太阳理论?本文梳理这段被忽视的科学史,揭示科学思维在十五世纪的萌芽,以及达芬奇对太阳发热和生命本质的冷峻观察。
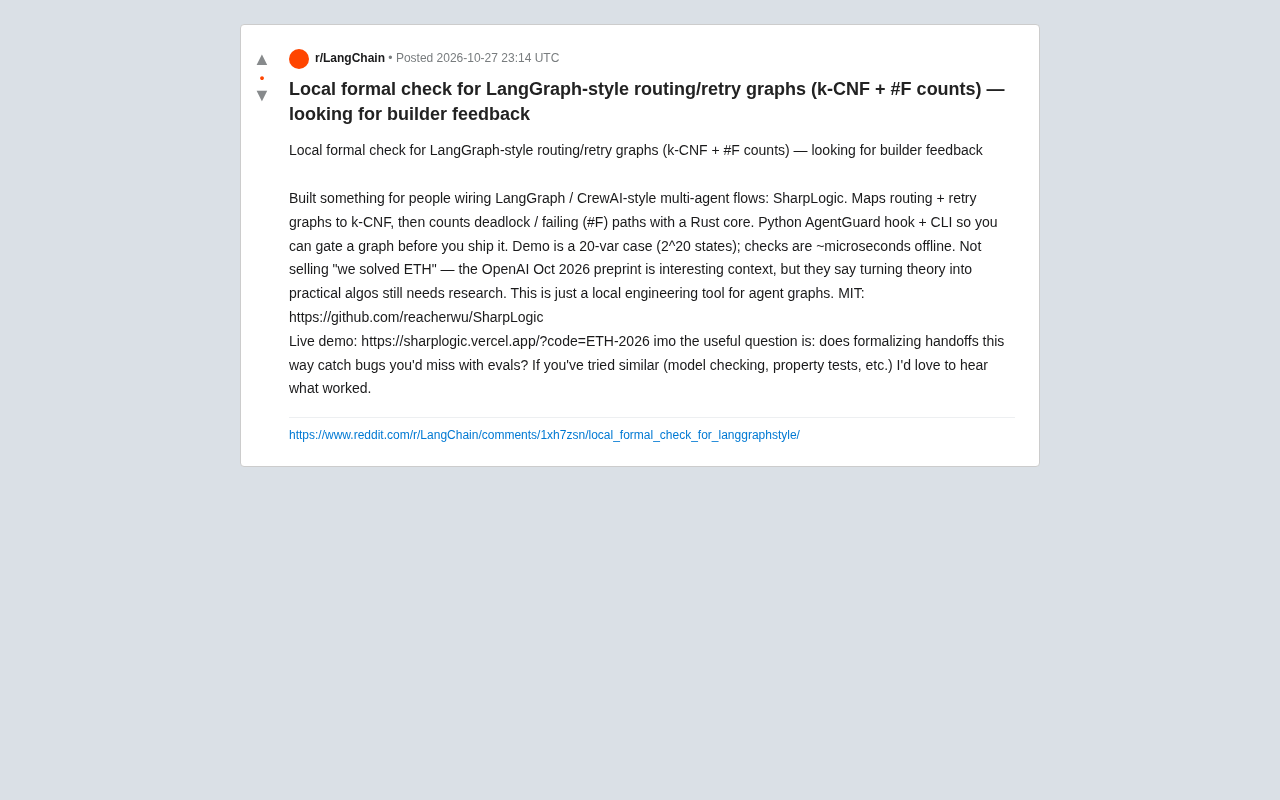
SharpLogic:用k-CNF为LangGraph路由图做形式化查错
SharpLogic开源项目将LangGraph风格的多智能体路由与重试图映射为k-CNF,用Rust内核统计死锁与失败路径(#F计数),提供Python AgentGuard钩子与CLI,在发布前做形式化门禁检查。本文分析其原理、与评测的互补关系及社区关注的建模成本问题。
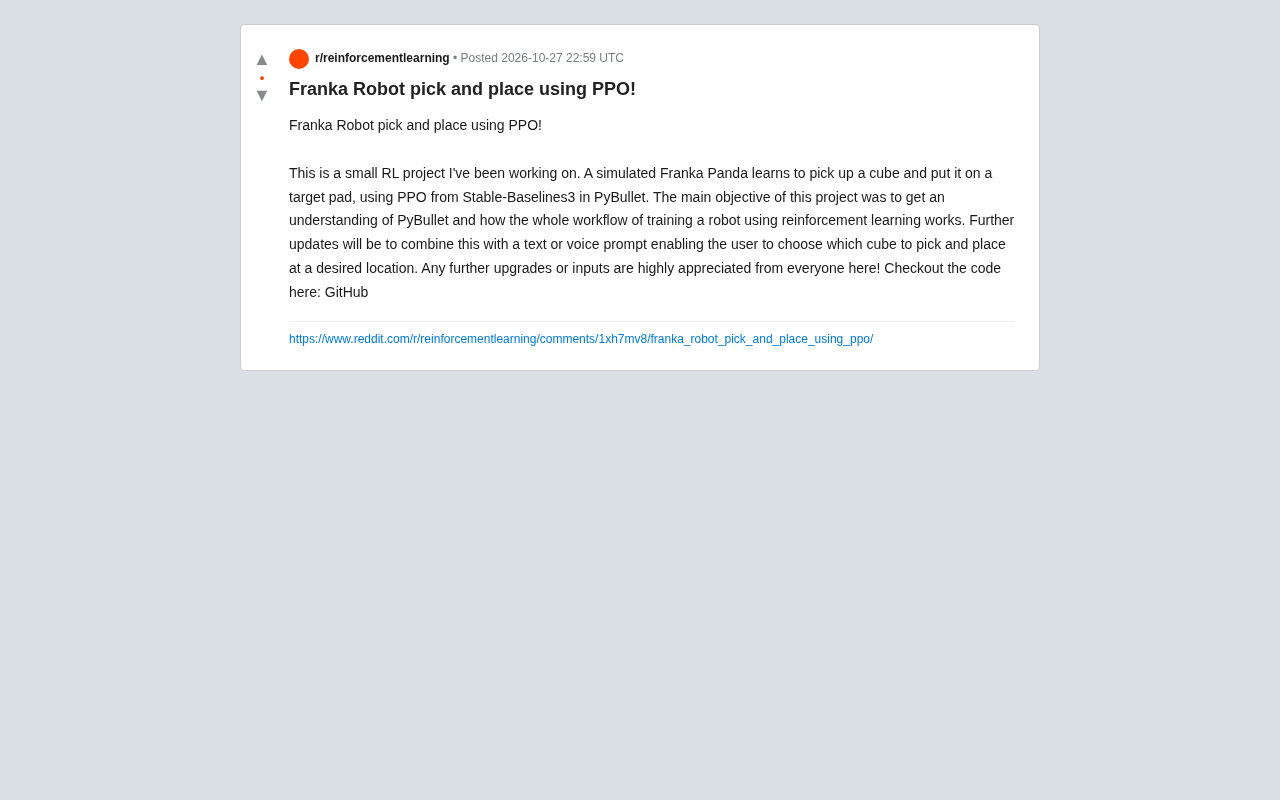
PPO训练Franka机械臂抓取放置:一个强化学习入门项目
一个用PPO算法在PyBullet中训练Franka Panda机械臂完成抓取放置任务的强化学习项目,涵盖技术栈选型、任务设计难点与未来文本/语音指令交互计划,适合入门者参考。