零基础入门AI/ML:三门热门课程对比与选课指南

一个真实的困惑:从哪里开始学AI?
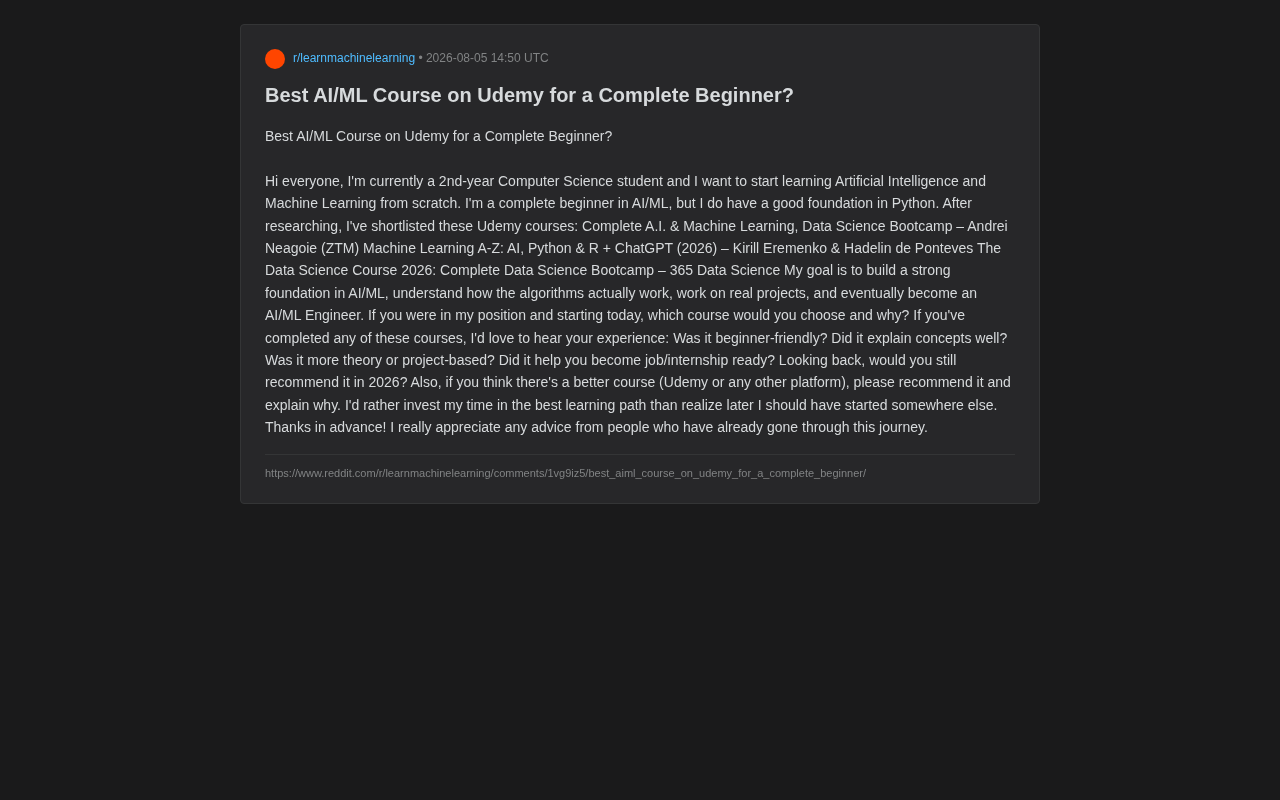
在Reddit上,一位计算机科学专业的大二学生发起了一个颇具代表性的提问:作为AI/ML的完全新手(但有扎实的Python基础),面对Udemy上眼花缭乱的课程,究竟该如何选择?
他列出了三门备受关注的热门课程:
- Complete A.I. & Machine Learning, Data Science Bootcamp —— Andrei Neagoie(ZTM)
- Machine Learning A-Z: AI, Python & R + ChatGPT —— Kirill Eremenko & Hadelin de Ponteves
- The Data Science Course: Complete Data Science Bootcamp —— 365 Data Science
他的目标很明确:打好AI/ML基础、真正理解算法原理、参与实战项目,并最终成为一名AI/ML工程师。这个问题背后,其实反映了无数初学者共同的焦虑——不想在错误的路径上浪费时间。
三门课程的定位差异
虽然这三门课都打着"Bootcamp"(训练营)的旗号,但它们的侧重点其实各有不同,理解这些差异是做出正确选择的关键。
Bootcamp(编程训练营)这一概念最早兴起于2012年前后的硅谷,最初以线下集中培训为主,承诺在8-16周内将零基础学员培养为可就业的软件工程师。随着Udemy、Coursera等在线教育平台的崛起,Bootcamp模式迅速线上化。与传统大学课程相比,Bootcamp强调实用性和项目驱动,弱化理论推导。但也正因如此,Bootcamp毕业生常被批评"知其然不知其所以然"。在AI/ML领域,这一矛盾尤其突出——机器学习的核心算法深度依赖数学直觉,纯粹的代码实操难以替代对损失函数、梯度下降、概率分布等概念的深层理解。值得注意的是,Udemy的商业模式也塑造了课程形态:平台频繁的促销活动(课程经常以9.9-14.99美元的折扣价出售)使得讲师倾向于制作时长极长、覆盖面极广的"百科全书式"课程以吸引购买,但这种模式有时牺牲了单个主题的讲解深度。学习者需要意识到,Udemy课程的"完成率"通常低于10%,能否坚持学完并做完项目,比选哪门课更重要。
Machine Learning A-Z:面向初学者的算法直觉培养
Kirill Eremenko与Hadelin de Ponteves的这门课是Udemy上历史最悠久、评价数量最多的ML课程之一(截至目前累计评分超过18万条)。它的最大特点是用直观的方式讲解算法逻辑,而非陷入繁重的数学推导。课程覆盖回归、分类、聚类、关联规则、强化学习、深度学习等主流主题,并同时提供Python和R两种语言的实现。
这些术语代表了机器学习的核心任务类型,理解它们的区别是入门的第一步。回归(Regression) 用于预测连续数值,如房价、温度,最基础的形式是线性回归——通过拟合一条直线(或更高维的超平面)来描述自变量与因变量之间的关系。分类(Classification) 用于预测离散标签,如垃圾邮件检测、医学影像诊断,经典算法包括逻辑回归(尽管名字中有"回归",它实际上是分类算法)、支持向量机(SVM)和随机森林。这两者属于监督学习(Supervised Learning),需要带标签的训练数据——即每个数据样本都附带了"正确答案"。聚类(Clustering) 则属于无监督学习(Unsupervised Learning),在没有标签的情况下自动发现数据中的分组模式,典型算法包括K-Means(通过迭代计算质心来划分数据)和DBSCAN(基于密度的算法,能发现任意形状的簇,对噪声数据更鲁棒)。关联规则学习用于发现变量间的有趣关系,最经典的应用是超市购物篮分析——Apriori算法和FP-Growth算法通过挖掘频繁项集来揭示商品之间的共现模式,这一技术至今仍广泛应用于推荐系统和交叉销售策略。强化学习(Reinforcement Learning) 则是另一个完全不同的范式,智能体通过与环境交互获取奖励信号来学习最优策略,核心概念包括状态、动作、奖励函数和策略函数。AlphaGo是强化学习的标志性成果,而近年来强化学习在大语言模型对齐(如RLHF——基于人类反馈的强化学习)中的应用更使其成为AI领域的焦点话题。
对于"想理解算法如何工作"的初学者来说,这门课的优势在于门槛低、覆盖广。Kirill Eremenko以"数据科学布道者"自居,擅长用商业案例和可视化图表来解释复杂概念,这使得非数学背景的学习者也能建立初步的算法直觉。但它的短板也很明显:由于追求易懂,很多概念的数学深度不足(例如梯度下降的讲解可能省略了学习率调度、动量优化等关键细节),实战项目偏向"模板化"——学员跟着代码敲一遍,但缺少从问题定义到方案设计的独立思考环节,学完后未必能独立搭建真实系统。
ZTM Bootcamp:更贴近工程实践的选择
Andrei Neagoie的Zero to Mastery系列以"从零到就业"为卖点,内容更强调工程链路的完整性——从数据处理、模型训练到部署。对于目标是成为AI/ML工程师的学习者而言,ZTM的工程导向可能更契合职业规划。它通常会包含更现代的工具栈(如TensorFlow、Pandas、Scikit-learn的完整工作流),并且在课程设计上注重"端到端"的项目经验——不只是训练一个模型,还包括数据获取、特征工程、模型评估、超参数调优和模型部署等完整流程。
理解这些工具的定位和生态关系对于ML工程师至关重要。Pandas 是Python生态中最核心的数据处理库,由Wes McKinney于2008年开发,提供DataFrame数据结构(类似于电子表格或SQL表),使得数据清洗、转换、聚合操作变得直观高效。在实际ML项目中,数据预处理往往占据60%-80%的工作量,因此精通Pandas几乎是所有数据相关岗位的硬性要求。Scikit-learn(简称sklearn)是传统机器学习的首选框架,由法国国家信息与自动化研究所(INRIA)主导开发,内置了从数据预处理(标准化、编码)、特征工程(PCA降维、特征选择)到模型训练、评估(交叉验证、网格搜索)的完整流水线,支持几乎所有经典ML算法,其统一的API设计(fit-predict-transform模式)极大地降低了学习成本。TensorFlow 由Google Brain团队于2015年开源,是深度学习领域最主流的框架之一,支持从研究原型到生产部署的全生命周期,其生态系统包括TensorFlow Lite(移动端部署)、TensorFlow.js(浏览器端推理)和TensorFlow Serving(服务化部署)。与之竞争的PyTorch(由Meta/Facebook的AI研究团队于2016年发布)近年来在学术界更受欢迎,以动态计算图(eager execution)和更Pythonic的API著称,使得调试和实验更加灵活。2023年前后,PyTorch在顶级AI会议论文中的使用率已超过TensorFlow,但在工业部署场景中TensorFlow仍占有重要份额。掌握这些工具的协作关系——Pandas做数据处理、Scikit-learn做传统ML、TensorFlow/PyTorch做深度学习——是成为AI/ML工程师的基本功。
365 Data Science:偏向数据科学体系
第三门课的定位更偏"数据科学"而非纯粹的机器学习工程。它会花更多篇幅在统计学、数据分析、SQL、可视化等基础上。这里有必要区分"数据科学家"和"ML工程师"两个容易混淆的角色:数据科学家侧重于从数据中提取洞察、验证假设、支持业务决策,核心技能是统计分析、数据可视化和沟通能力;ML工程师则侧重于构建、优化和部署机器学习系统,核心技能是软件工程、模型优化和系统架构。两者存在大量重叠,但职业路径和日常工作内容差异显著。如果你的目标是数据分析师或偏商业智能的数据科学家,365 Data Science这门课体系完整;但如果聚焦AI/ML算法与工程实现,它的针对性反而弱一些。
选课背后更重要的思考
课程只是起点,不是终点
一个残酷但真实的事实是:没有任何一门Udemy课程能让你直接成为AI/ML工程师。这些课程的价值在于建立系统的知识框架和入门信心。真正让人"就业ready"的,是课程之后的持续实践——自己动手复现论文、参加Kaggle竞赛、构建端到端的个人项目并部署上线。
Kaggle 在这条学习路径中扮演着独特且不可替代的角色。作为全球最大的数据科学竞赛平台(2010年由Anthony Goldbloom创立,2017年被Google收购),Kaggle的价值远不止于竞赛本身。平台上托管了数以万计的公开数据集,涵盖医疗、金融、自然语言处理、计算机视觉等几乎所有领域,任何人都可以免费使用;社区成员分享的Notebook(代码笔记本)构成了一个庞大的实战案例库,涵盖从探索性数据分析(EDA)到高级模型集成(Ensemble)的全过程,许多顶级竞赛的获胜方案都被详细拆解。Kaggle竞赛要求参赛者在真实或近真实的数据上优化模型性能,排行榜机制迫使学习者不断迭代方案——尝试不同的特征工程策略、模型架构、超参数组合——这种压力驱动的学习方式对提升实战能力极其有效。Kaggle还设有一套等级体系(Novice → Contributor → Expert → Master → Grandmaster),许多AI/ML从业者在求职时会将Kaggle排名和竞赛成绩作为简历的重要组成部分,部分公司(如H2O.ai、NVIDIA)甚至专门招聘Kaggle高排名选手。此外,Kaggle提供的免费GPU/TPU计算资源(通过Google Cloud支持)也让没有高性能硬件的学习者能够训练较大规模的深度学习模型。
对于这位有Python基础的CS学生来说,与其在三门课之间反复纠结,不如尽快选定一门开始动手。过度的"选课焦虑"本身就是一种时间浪费——在心理学中,这被称为"分析瘫痪"(Analysis Paralysis),指在面对过多选择时陷入无限比较而无法行动的状态。
建议的AI/ML学习路径
结合他的背景(大二CS、Python基础、目标是AI/ML工程师),一个更合理的学习路径是:
- 先用Machine Learning A-Z建立算法直觉,快速了解各类算法的应用场景;
- 补足数学短板,尤其是线性代数、概率统计和微积分基础——这是理解算法"为什么有效"的关键;
- 转向更硬核的资源深化理解,例如Andrew Ng的Machine Learning Specialization(Coursera)、fast.ai的深度学习实战课程,或cs231n等大学公开课;
- 做真实项目并公开成果,用GitHub和博客沉淀作品集。
数学之所以在第二步被着重强调,是因为它构成了机器学习的底层语言,决定了一个从业者能走多远。线性代数提供了处理高维数据的基本框架——在机器学习中,一个包含m个样本、n个特征的数据集就是一个m×n的矩阵;特征变换就是矩阵乘法;主成分分析(PCA)的核心是对协方差矩阵做特征值分解,找到数据方差最大的方向来实现降维;神经网络的前向传播本质上是一系列矩阵运算加上非线性激活函数的复合。推荐资源包括Gilbert Strang的MIT 18.06线性代数课程和3Blue1Brown的"线性代数的本质"系列视频。概率统计是理解模型不确定性和泛化能力的关键——贝叶斯定理提供了在观察到新证据后更新信念的数学框架(贝叶斯网络、朴素贝叶斯分类器的理论基础);最大似然估计(MLE)是参数估计的核心方法,逻辑回归、高斯混合模型等算法的训练目标本质上都是最大化似然函数;假设检验和置信区间帮助我们判断模型性能的差异是否具有统计显著性。更进阶的概率模型如变分自编码器(VAE)和扩散模型(Diffusion Models)则需要对概率分布、KL散度等概念有深入理解。微积分(尤其是多元微积分) 则是理解模型优化的核心——梯度下降算法依赖偏导数来确定参数更新方向,学习率控制步长大小;反向传播算法本质上是链式法则(Chain Rule)的系统化应用,它使得在包含数百万参数的深度网络中高效计算梯度成为可能;现代优化器如Adam、AdaGrad、RMSProp在梯度下降的基础上引入了自适应学习率和动量等机制,理解它们需要对一阶和二阶导数有直观感受。缺乏这些数学基础,学习者只能停留在"调API"的层面,无法诊断模型失效的原因(如梯度消失/爆炸、过拟合/欠拟合的数学本质),也无法针对特定问题设计创新方案。
别忽视免费的优质资源
值得一提的是,虽然提问聚焦Udemy付费课程,但AI/ML领域有大量高质量的免费资源。Andrew Ng的课程、fast.ai、Google和Kaggle的免费教程,其教学质量往往不逊于付费Bootcamp。付费课程的主要价值在于"结构化"和"节省筛选时间",而非内容独占。
吴恩达(Andrew Ng) 是AI教育领域最具影响力的人物之一,其个人经历本身就是一部AI发展简史。他是斯坦福大学计算机科学系教授,2011年创立了Google Brain项目(该项目后来产出了深度学习的多项突破性成果,包括通过无监督学习从YouTube视频中自动识别猫脸的实验),后于2014-2017年担任百度首席科学家,推动了百度在语音识别和自然语言处理方面的进展。2012年,他与Daphne Koller共同创办了Coursera,并在平台上发布了传奇性的Machine Learning课程,全球注册学习者超过500万人,被誉为"将机器学习知识民主化"的里程碑——在此之前,系统学习ML几乎只有攻读相关硕博学位这一条路。2022年,他对该课程进行了重大更新,推出Machine Learning Specialization(共三门课),将编程语言从Octave/MATLAB迁移至Python,并加入了神经网络、决策树、推荐系统等更现代的内容。他创办的DeepLearning.AI还提供深度学习专项课程(Deep Learning Specialization,共五门课),系统覆盖神经网络基础、超参数调优与正则化、卷积神经网络、序列模型等核心主题,被许多从业者视为深度学习入门的"黄金标准"。
fast.ai 由Jeremy Howard和Rachel Thomas于2016年创办,其教学理念在AI教育界独树一帜——采用"自上而下"的教学法,先让学生用高层API在第一节课就跑通一个完整的深度学习项目(如图像分类器),建立直觉和成就感,再在后续课程中逐层剥开底层原理。这与传统学术课程"自下而上"(先花数周学线性代数和概率论,再写第一行ML代码)的路径形成鲜明对比。Jeremy Howard认为这种方法更符合人类自然的学习方式——我们学骑自行车时并不需要先学力学。fast.ai同时开发了同名的开源深度学习库,封装了PyTorch的常用操作(如数据加载、学习率查找、混合精度训练),大幅降低了实验门槛,同时仍允许用户在需要时深入底层PyTorch代码。该课程完全免费,且每年更新以跟进最新技术进展。
cs231n(Convolutional Neural Networks for Visual Recognition) 则是斯坦福大学的经典计算机视觉课程,最初由李飞飞教授和Andrej Karpathy(后成为Tesla AI总监、OpenAI核心成员)等人创立。这门课以严谨的数学推导和从零实现神经网络的编程作业著称——学生需要用NumPy手写前向传播、反向传播、批归一化等模块,这种"造轮子"的训练方式虽然痛苦,但能极大加深对神经网络工作原理的理解。课程讲义和视频均免费公开,与之配套的还有cs224n(自然语言处理)和cs229(机器学习理论),共同构成了斯坦福AI课程的"铁三角"。fast.ai和cs231n一个偏实战效率,一个偏理论深度,互为补充——理想的学习策略是先通过fast.ai快速获得实践经验和全局视角,再通过cs231n等课程补足理论根基。
结语:行动比选择更重要
这位学生的困惑很有代表性,也很值得肯定——愿意在开始前认真调研,说明他对学习是认真的。但AI/ML这条路的核心规律是:理解深度来自反复实践,而非课程本身。
如果一定要给一个建议:以工程师为目标,可以优先考虑ZTM或Machine Learning A-Z入门,同时补齐数学基础,然后尽快进入项目实战阶段。真正拉开差距的,永远不是你上了哪门课,而是课后你独立解决了多少真实问题。
核心要点
- 三门Udemy课程各有侧重:Machine Learning A-Z适合建立算法直觉,ZTM更贴近工程全链路实践,365 Data Science偏向数据科学体系而非纯ML工程
- Bootcamp是起点而非终点:没有任何一门课能直接让你成为AI/ML工程师,课程的价值在于建立知识框架和入门信心
- 数学基础不可跳过:线性代数、概率统计和微积分构成了机器学习的底层语言,决定了从业者能理解多深、走多远
- 免费资源质量不输付费课程:吴恩达的Coursera课程、fast.ai、cs231n等免费资源在教学质量上往往不逊于付费Bootcamp
- 行动比选择更重要:克服"分析瘫痪",尽快选定一门课开始动手,通过Kaggle竞赛和个人项目积累真实经验才是核心竞争力
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。