零基础学Python爬虫:工作原理、完整流程与法律红线

什么是网络爬虫?
网络爬虫(Web Crawler)本质上是一段模拟人类浏览网页行为的程序。当我们打开一个购物网站,浏览商品信息,只对感兴趣的产品名称和价格加以关注并记录下来——爬虫做的正是这件事,只不过它用代码代替了人手。
以浏览华为官网为例:人类用户会打开网页、浏览内容,然后从中筛选出自己关心的信息(比如某款产品及其价格)。而爬虫程序则通过代码自动完成从「访问」到「提取」再到「保存」的全过程。理解这一点,是学习 Python 爬虫的第一步。
值得一提的是,网络爬虫并非个人开发者的专属工具——搜索引擎巨头 Google、百度的核心能力之一,正是其覆盖全球数十亿网页的大规模爬虫系统(称为"蜘蛛"或"Spider")。正是这些爬虫持续不断地抓取、索引互联网内容,才让我们每次搜索都能在毫秒内获得相关结果。从这个角度看,爬虫是现代互联网信息基础设施不可或缺的组成部分。
搜索引擎爬虫的工业级实现:搜索引擎爬虫系统与个人爬虫在规模和架构上存在本质差异。以 Google 的 Googlebot 为例,它每天抓取数百亿个 URL,背后依托的是分布式抓取调度系统、优先级队列(根据页面权重决定抓取频率)、海量去重机制(通过 URL 指纹或内容哈希避免重复抓取)以及专用的 DNS 解析缓存集群。Googlebot 还会主动遵循 HTTP 响应头中的
Cache-Control和Last-Modified字段,对未变更的页面实施增量抓取策略,以最大化抓取效率并减少对服务器的压力。这种工业级架构与个人学习用的爬虫脚本虽然原理相通,但在可靠性、容错性和扩展性上有着天壤之别,也为学习者提供了技术演进的清晰路径。
爬虫技术的演进背景:网络爬虫技术自1994年第一个现代意义上的搜索引擎爬虫「World Wide Web Wanderer」诞生以来,已历经三十年演进。早期爬虫仅需处理静态 HTML 页面,通过简单的 HTTP 请求即可获取完整内容。然而现代网络中超过70%的页面采用 JavaScript 动态渲染技术(如 React、Vue、Angular 等前端框架),页面内容并非随 HTML 源码一同返回,而是在浏览器执行 JS 脚本后才动态生成。这使得传统 HTTP 请求型爬虫只能拿到空壳页面,由此催生了以 Selenium、Playwright 为代表的「无头浏览器」(Headless Browser)爬虫方案——这类工具能够驱动一个没有图形界面的真实浏览器引擎,完整执行 JavaScript 并等待页面渲染完毕后再提取数据。对初学者而言,理解「静态页面」与「动态渲染页面」的区别,是进阶爬虫开发的重要分水岭。
爬虫是如何工作的?
要理解爬虫的运作机制,需要先弄清楚人类获取网页内容的完整流程。
从 HTTP 请求到页面渲染
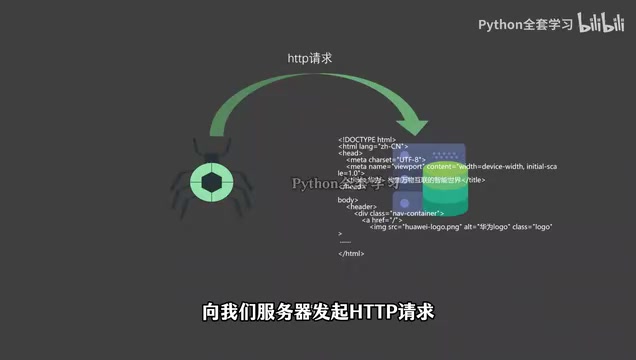
当我们用浏览器打开一个网页时,实际发生了这样一系列动作:浏览器向目标网站的服务器发起一个 HTTP 请求,服务器收到请求后将网站的原始内容响应回浏览器,浏览器再对这些原始内容进行渲染,最终呈现为我们看到的可视化页面。
HTTP 协议背景:HTTP(HyperText Transfer Protocol,超文本传输协议)是互联网数据通信的基础规范,由蒂姆·伯纳斯-李(Tim Berners-Lee)于1991年在欧洲核子研究中心(CERN)发明。它规定了客户端(如浏览器)与服务器之间"如何对话"的格式和规则。每一次 HTTP 请求都包含请求方法(最常见的是 GET,表示"我要获取这个页面")、目标地址(URL)以及各种头部信息(Headers,包含浏览器类型、语言偏好等元数据)。服务器收到请求后,会返回一个包含状态码(如 200 表示成功,404 表示页面不存在,403 表示禁止访问)和响应体(即网页的原始内容)的响应包。理解 HTTP 请求与响应的结构,是编写爬虫的核心基础——因为爬虫本质上就是在用代码精确模拟这个"对话"过程。
HTTP 协议版本演进对爬虫的影响:HTTP 协议自诞生以来经历了多个重要版本迭代。HTTP/1.1(1997年)引入了持久连接(Keep-Alive),允许在同一 TCP 连接上发送多个请求,显著降低了爬虫的连接开销。HTTP/2(2015年)更进一步,通过多路复用(Multiplexing)机制允许在单个连接上并行传输多个请求/响应,并引入了头部压缩(HPACK)技术,大幅减少了重复 Header 信息的传输量。最新的 HTTP/3(2022年正式标准化)则将底层传输协议从 TCP 切换为基于 UDP 的 QUIC 协议,从根本上解决了 TCP 的队头阻塞问题,进一步提升了弱网环境下的传输效率。对爬虫开发者而言,Python 的
httpx库已原生支持 HTTP/2,而requests库默认仅支持 HTTP/1.1——在爬取强制要求 HTTP/2 的现代网站时,选择合适的 HTTP 客户端库至关重要。
值得延伸的是,当前互联网已大规模普及 HTTPS(HTTP Secure),即在 HTTP 协议之上叠加了 TLS/SSL 加密层,确保数据在传输过程中无法被第三方窃听或篡改。Python 的
requests库对 HTTPS 请求提供了透明支持,开发者无需手动处理加密细节,但需要注意的是,部分企业内网或自签名证书的网站可能需要额外处理证书验证问题。
爬虫程序的逻辑与此类似,但缺少了关键的「渲染」环节。爬虫通过代码向服务器发起 HTTP 请求,服务器同样会把原始内容返回,但由于爬虫没有浏览器的渲染能力,它拿到的只是未经渲染的 HTML 源代码。
认识网页标签
想查看这些原始内容,可以在浏览器中右击选择「检查」,弹出的开发者工具窗口显示的就是整个网页的 HTML 结构。点击元素选择图标,将鼠标移动到页面不同区域,开发者工具中高亮的代码也会随之变化——这能帮助你快速定位目标元素在源码中的位置。
仔细观察会发现,每个元素都被一对尖括号(< >)包裹,这就是网页标签。标签类型多样,不同标签有不同的显示效果,但初学者只需记住一个核心概念:被标签包裹起来的内容,就是一个元素。
HTML 与 DOM 树背景:HTML(HyperText Markup Language,超文本标记语言)是构建网页内容的骨架语言,自1993年诞生至今已演进至 HTML5 版本。浏览器在接收到 HTML 源码后,并非直接显示文字,而是将其解析为一棵树状数据结构,称为 DOM 树(Document Object Model,文档对象模型)。每一个 HTML 标签都对应树中的一个节点,父子标签之间形成层级关系,例如
<div>内嵌套的<p>就是其子节点。爬虫在提取数据时,本质上是在遍历这棵 DOM 树,通过标签名称(如div、span)、class属性或id属性来精确定位目标节点,再提取其中的文本或属性值。Python 中常用的 BeautifulSoup 和 lxml 库,正是专门用于解析 HTML 并操作 DOM 树的工具。
HTML 解析器的选择与性能差异:在 Python 生态中,HTML 解析器的选择直接影响爬虫的性能与容错能力。BeautifulSoup 支持多种底层解析器:内置的
html.parser无需额外安装但速度较慢;lxml基于 C 语言实现,速度快约5-10倍,是生产环境的首选;html5lib则严格遵循 W5C 规范,对格式不规范的"破损 HTML"容错能力最强,但速度最慢。真实网络中存在大量不符合规范的 HTML(缺少闭合标签、标签嵌套错误等),选择容错性强的解析器能避免很多意外的数据丢失。此外,对于需要对爬取内容进行全文检索的高性能场景,直接使用 lxml 的 XPath 接口通常比 BeautifulSoup 的 CSS 选择器快2-3倍,是处理大批量文档的优先选择。
需要补充的是,现代前端开发中广泛使用的 Shadow DOM(影子DOM)技术,将部分组件的内部结构封装隔离,使得普通的 DOM 查询方法无法直接访问其内部节点。这是爬虫开发者在处理使用 Web Components 技术构建的页面时可能遭遇的进阶挑战之一。
数据提取与存储
获取到网页的 HTML 原始内容后,接下来要做的就是「解析内容、提取有价值信息」这一关键步骤。

通过标签定位目标数据
网页源码中存在海量标签,信息量庞杂。就像人类浏览时会自动过滤无用内容一样,爬虫同样需要精准「筛选」。
以提取产品名称和价格为例:这些数据往往由特定的 div 标签包裹,div 标签通常会用 class 属性来标注其名称。假设产品名称都位于 class 名为 css-175oi22 的 div 标签内,那么爬虫的任务就变成:定位这个特定标签,然后抓取其中的文本内容。
在实际开发中,爬虫定位元素通常有两种主流方式:一是使用 CSS 选择器(通过标签类型、class、id 等属性组合来精确匹配元素,语法简洁直观);二是使用 XPath(一种用于在 XML/HTML 文档中导航的路径语言,表达能力更强,适合处理复杂的嵌套结构)。Python 的 BeautifulSoup 库对 CSS 选择器支持友好,而 lxml 库则对 XPath 的支持更为强大——初学者通常从 BeautifulSoup 入手,掌握基础后再按需学习 XPath。
结构化数据提取的现代方案:除了传统的 CSS 选择器和 XPath,现代爬虫开发还出现了更高层次的提取方案。部分网站在页面源码中嵌入了符合 Schema.org 规范的结构化数据标记(以
<script type="application/ld+json">形式内嵌的 JSON-LD 格式),这些标记本身就包含了产品名称、价格、评分等结构化信息,爬虫可以直接提取这段 JSON 而无需解析复杂的 HTML 嵌套结构。此外,越来越多的网站通过GraphQL 或 REST API 接口向前端传输数据,熟练使用浏览器开发者工具的「网络(Network)」面板分析 XHR/Fetch 请求,直接调用这些数据接口往往比解析渲染后的 HTML 更加高效可靠,且数据结构更加规整——这也是资深爬虫工程师处理动态页面的首选思路。
反爬虫机制与应对策略:现代网站普遍部署了多层反爬虫机制,这也是爬虫开发者必须了解的对立面。常见的反爬手段包括:User-Agent 检测(服务器识别请求头中非浏览器的特征,对爬虫请求返回错误或空内容);IP 频率限制(同一 IP 地址在短时间内发起大量请求会触发封锁,俗称"封 IP");验证码(CAPTCHA)挑战(通过图形识别或行为验证区分人类与机器);Cookie 会话验证(要求访问者维持有效的登录状态);以及更高级的 JavaScript 指纹识别(通过检测浏览器环境特征、鼠标移动轨迹等行为特征判断是否为自动化程序)。了解这些机制,有助于开发者在合法合规的前提下编写更健壮的爬虫——例如,合理设置
User-Agent请求头模拟真实浏览器、在相邻请求之间加入随机延时(time.sleep(random.uniform(1, 3)))、使用requests.Session()维持 Cookie 会话等,都是爬虫工程实践中的基本礼仪。
数据落地
抓取到目标元素后,爬虫的最后一步是将数据存储到数据库中,以便后续分析和使用。常见的存储方案包括:将结构简单的数据保存为 CSV 文件(适合快速查看和导入 Excel);将半结构化数据存入 JSON 文件;或将大批量、需要频繁查询的数据写入关系型数据库(如 MySQL、PostgreSQL)甚至 NoSQL 数据库(如 MongoDB,特别适合存储格式不固定的网页数据)。
数据存储方案的选型逻辑:MongoDB 在爬虫数据存储领域广受欢迎,核心原因在于其「无模式」(Schema-less)特性——网页数据结构往往因页面而异,关系型数据库要求预先定义所有字段及其类型,而 MongoDB 以 BSON(Binary JSON,二进制 JSON)格式存储文档,天然适应字段数量和类型不固定的场景,无需提前建表,插入即存。此外,对于需要对爬取内容进行全文检索的场景(如搜索引擎、新闻聚合),Elasticsearch 也是常见的存储与检索一体化解决方案,其倒排索引(Inverted Index)机制能对海量文本实现毫秒级关键词检索。而对于数据量较小、以后续数据分析为主要目的的项目,直接使用 Python 的
pandas库将数据保存为 Parquet 格式也日渐流行,兼顾了存储效率与分析便利性。
爬虫任务的工程化管理:当爬虫规模从单脚本扩展到持续性、大批量的数据采集项目时,任务调度与去重机制变得不可或缺。Python 生态中,Scrapy 框架提供了完整的爬虫工程化解决方案,内置了请求队列管理、去重过滤(基于请求指纹的 BloomFilter)、Pipeline 数据处理流水线以及自动限速(AutoThrottle)等模块,是从个人脚本升级到生产级爬虫系统的主流选择。对于需要定时触发的周期性爬虫任务,结合 Celery(分布式任务队列)与 Redis(作为消息中间件和去重集合存储)的组合架构,能够支撑数十台机器协同抓取的分布式爬虫场景。
至此,「发起 HTTP 请求 → 获取 HTML 源码 → 解析提取 → 存储数据」这条完整的爬虫工作流就全部走通了。
不可触碰的法律红线
很多初学者对爬虫心存顾虑,觉得它是「危险」的技术。事实上,只要守住几条明确的底线,爬虫完全是合法、合规的数据采集工具。
三条绝对不能碰的底线
第一,不能抓取政府机关、国防等敏感单位的信息。 这类数据涉及国家安全,切勿触碰。
第二,不能涉及公民个人信息与商业机密。 大量网站实行实名制,用户个人信息散落在各类系统中。抓取并利用这些数据,属于侵犯隐私的违法行为。根据2021年正式实施的《中华人民共和国个人信息保护法》,未经授权收集、处理个人信息最高可面临5000万元人民币或年营业额5%的罚款,情节严重者还将承担刑事责任。
个人信息保护的全球监管趋势:个人信息保护的立法浪潮已席卷全球。欧盟于2018年实施的 GDPR(通用数据保护条例)被视为迄今最严格的数据保护法规,违规者最高罚款可达全球年营业额的4%或2000万欧元(取较高者),并已对谷歌、Meta 等科技巨头开出逾数十亿欧元的罚单。中国的《个人信息保护法》在多处借鉴了 GDPR 的立法框架,同样强调了数据处理的「最小必要原则」——即只收集实现特定目的所必需的最少量数据。对于爬虫开发者而言,这意味着即便技术上能够抓取某个数据字段,也应审慎评估其必要性。「能抓到」与「应该抓」之间的边界,正是数据伦理的核心命题。
第三,不能对目标网站造成破坏。 利用爬虫在短时间内发起海量请求,可能导致服务器宕机,使正常用户无法访问。由此造成的损失,最终都会追责到爬虫运行者身上。
DDoS 与爬虫滥用的法律边界:当爬虫请求密度高到一定程度,其效果与 DDoS(分布式拒绝服务攻击)并无本质区别——都是通过海量请求耗尽服务器资源。即便主观上没有攻击意图,客观上造成服务中断的后果,在司法实践中同样可能被认定为《中华人民共和国刑法》第286条规定的「破坏计算机信息系统罪」。2019年震惊业内的「大众点评数据爬虫案」中,被告因大规模爬取竞争对手数据被判构成不正当竞争,赔偿金额高达200万元,为行业敲响了警钟。
合规爬取的实用建议
养成以下习惯,能帮你将法律风险降到最低:
- 在目标网址后添加
/robots.txt,查看网站的 robots 协议,了解哪些路径允许爬取、哪些被明确禁止; - 控制请求频率与并发数量,避免对服务器造成不必要的压力;
- 只采集页面上公开可见的内容,一般不会有法律问题。
robots 协议背景:robots.txt 协议(又称"机器人排除标准")由网络先驱 Martijn Koster 于1994年提出,是互联网上历史最悠久的自律规范之一。它是一个纯文本文件,网站管理员将其放置于网站根目录下(如
https://example.com/robots.txt),通过User-agent(指定针对哪类爬虫)和Disallow/Allow指令声明哪些页面路径不希望被爬取。例如,Disallow: /private/表示禁止爬取/private/目录下的所有内容。需要注意的是,robots.txt 属于君子协议,在技术层面并没有强制约束力,但在法律层面,明知网站通过 robots.txt 声明了禁止爬取,仍强行抓取,可能被认定为"未经授权访问计算机系统",从而承担更重的法律责任。Google、百度等主流搜索引擎均严格遵守 robots.txt 协议,这也是负责任的爬虫开发者应有的职业素养。
Sitemap 协议:robots.txt 的友好补充:与 robots.txt「告知爬虫不要去哪里」相对应,Sitemap(网站地图)协议则是网站主动告知爬虫「应该去哪里」的标准机制。网站管理员可以在 robots.txt 中通过
Sitemap: https://example.com/sitemap.xml指令声明 Sitemap 文件的位置,该 XML 文件列举了站内所有希望被索引的页面 URL 及其更新频率、优先级信息。对于合法的爬虫任务(如竞品分析、内容聚合),主动读取目标网站的 Sitemap 文件往往能快速获得完整的 URL 列表,比从首页逐层递归发现链接效率高出数个量级,也体现了对目标网站意图的尊重。
此外,部分网站还会在页面底部或服务条款(Terms of Service,ToS)中明确声明禁止自动化数据采集。建议在启动爬虫项目前,养成阅读目标网站服务条款的习惯。美国法院在 hiQ Labs v. LinkedIn 案(2022年)中的判决表明,即便是公开可见的数据,若违反平台服务条款大规模采集,仍可能面临法律诉讼——这一判例对国内爬虫实践同样具有参考意义。
至于能否采集付费视频等版权内容——从技术上或许可行,但已触碰法律边界。感兴趣的读者可查阅《中华人民共和国刑法》第 286 条「破坏计算机信息系统罪」及相关侵犯著作权条款,务必三思而后行。
小结
本文梳理了 Python 爬虫的核心原理:它本质上是模拟人类浏览行为、通过 HTTP 请求获取网页 HTML 源码、再解析提取有价值信息并存储的自动化程序。理解 HTTP 请求与响应机制、页面渲染原理(包括静态页面与 JavaScript 动态渲染的区别)、HTML DOM 树结构以及网页标签这几个概念,是入门爬虫的必备基础。
更重要的是,技术本身无罪,但使用者必须守住法律红线:不碰敏感信息、不侵犯隐私(尤其注意《个人信息保护法》的约束)、不破坏服务器、尊重 robots.txt 协议,并在动手前查阅目标网站的服务条款。掌握了原理与边界,下一步就可以动手编写属于自己的第一个 Python 爬虫程序了。
核心要点
核心要点
核心要点
相关推荐

用n8n打造AI每日新闻简报:20秒告别信息过载
一位 YouTube 创作者用 n8n 搭建 AI 每日新闻简报工作流:RSS 抓取路透社头条、AI 去标题党并摘要、写入 Supabase 数据库、推送 Telegram,20 秒读完全球资讯。本文拆解其实现逻辑与借鉴价值。

Zapier、Make、n8n实测对比:同一AI工作流三次翻车
Zapier、Make、n8n三款自动化工具实测对比:用同一个AI线索分类工作流各搭一遍,三者全部翻车。深度拆解搭建时间、运行速度、计费逻辑及各自的静默失败陷阱,帮你选对AI自动化平台。

用n8n搭建AI内容引擎:全自动运营Facebook主页实战
一位创作者用开源工具n8n搭建AI内容引擎,实现Facebook主页全自动运营:选题、写作、配图、审核、发布五步流水线,287篇写出238篇发布,拆解其人机分工逻辑与可复制性。