零依赖Python工具TokenPrune:无需二次LLM,API负载Token直降80%

TokenPrune用确定性本地剪枝替代辅助LLM摘要,亚毫秒压缩Agent工具输出70%-90%的Token。
文章介绍开源零依赖Python包TokenPrune,针对Agent调用外部API时工具输出被元数据淹没、浪费上下文窗口的问题。常见方案是用GPT-4o-mini等辅助模型先做摘要,但带来500ms到2秒网络延迟和持续API费用。TokenPrune改为在本地内存中执行确定性剪枝:通过@prune_tool装饰器自动剥离空值、压缩重复键值模式,并将结构一致的列表转为紧凑表格YAML。作者基准显示企业级API负载Token削减70%–90%,运行时开销低于0.5毫秒,且无外部调用。局限在于启发式规则可能不覆盖所有schema,存在信息丢失风险,且数据来自作者自测,尚未经大规模生产验证。
为什么你的Agent总在浪费Token?
构建与外部API(GitHub、Jira、Stripe或内部微服务)交互的Agent时,工具返回的输出常常会淹没上下文窗口:头像URL、HATEOAS链接、节点ID、空值键……这些元数据动辄消耗数百个Token,而真正有用的信息可能只占一小部分。
常见的做法是引入一个辅助模型(比如GPT-4o-mini)先对工具输出做摘要,再喂给主Agent。但这会带来500ms到2秒的外部网络延迟,以及持续的API调用费用。对于高频调用的Agent工作流来说,这笔开销既影响响应速度,也推高了运营成本。
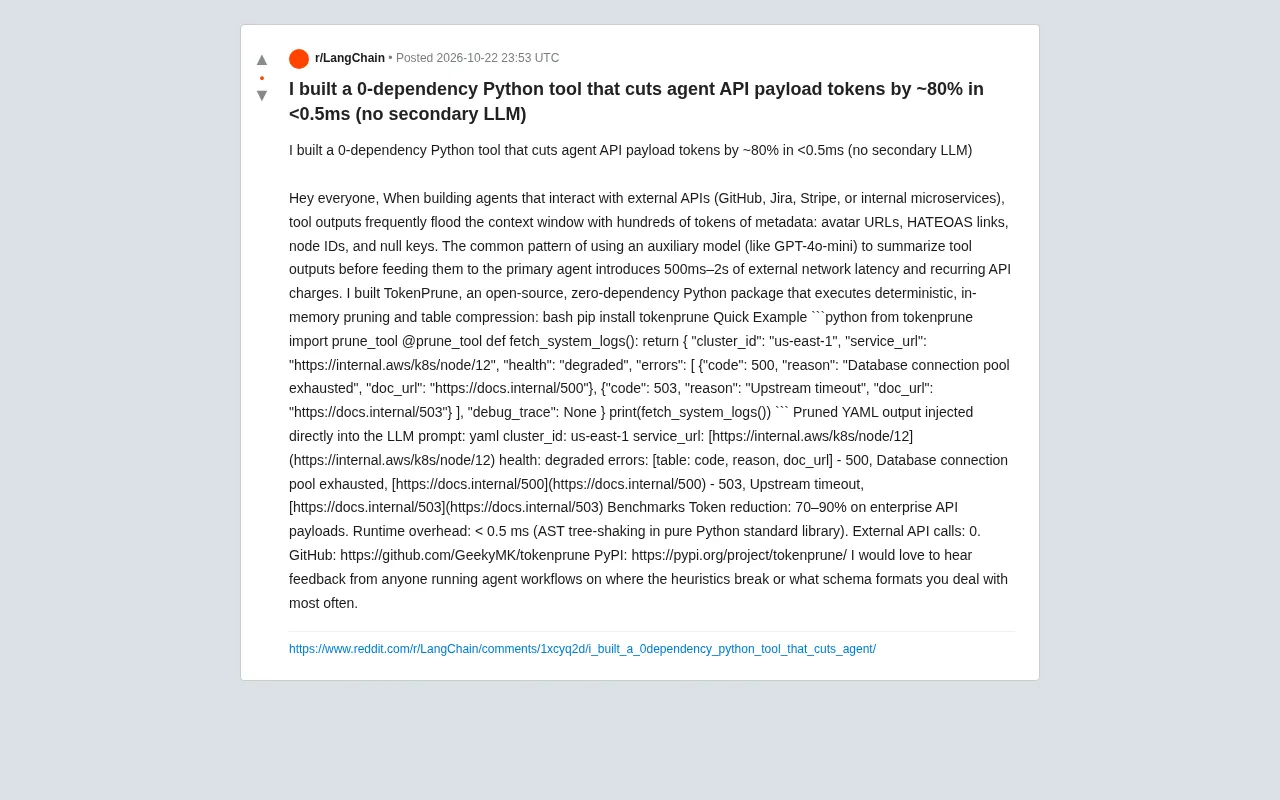
TokenPrune:确定性的本地剪枝方案
一位开发者在Reddit上发布了TokenPrune——一个开源、零依赖的Python包。它的思路很直接:不调用任何外部模型,而是在内存中执行确定性的剪枝和表格压缩,把工具输出中的冗余信息去掉,只保留对Agent决策有价值的部分。
安装方式也很简单:
pip install tokenprune
核心用法是通过@prune_tool装饰器包裹工具函数。当函数返回一个字典时,TokenPrune会自动分析其结构,剥离空值、压缩重复的键值模式,并将列表型数据转换为紧凑的表格形式。
一个例子看懂剪枝效果
假设一个获取系统日志的工具返回如下字典:
from tokenprune import prune_tool

@prune_tool
def fetch_system_logs():
    return {
        "cluster_id": "us-east-1",
        "service_url": "https://internal.aws/k8s/node/12",
        "health": "degraded",
        "errors": [
            {"code": 500, "reason": "Database connection pool exhausted", "doc_url": "https://docs.internal/500"},
            {"code": 503, "reason": "Upstream timeout", "doc_url": "https://docs.internal/503"}
        ],
        "debug_trace": None
    }
经过TokenPrune处理后,注入LLM提示词的内容变成紧凑的YAML:
cluster_id: us-east-1
service_url: https://internal.aws/k8s/node/12
health: degraded
errors: [table: code, reason, doc_url]
  - 500, Database connection pool exhausted, https://docs.internal/500
  - 503, Upstream timeout, https://docs.internal/503
注意debug_trace: None被直接移除了,而errors列表从重复的字典结构变成了表头加行的紧凑格式。对于包含大量同类对象的API响应,这种表格压缩能显著减少Token数量。
HATEOAS(Hypermedia as the Engine of Application State)是 REST 架构的一种风格:API 响应除了业务数据,还会附带一组指向相关操作的链接(如 _links、href、next 等),让客户端通过跟随链接发现可用动作。这类链接字段对构建 UI 或导航很有价值,但对 LLM Agent 的决策往往只是噪声——Agent 通常已经知道要调用哪个工具,不需要再从响应里解析出下一个 URL。类似的还有头像 URL、分页游标、节点 ID 等元数据。TokenPrune 的默认剪枝会优先剥离这类字段,但这也意味着若某些链接在溯源或后续调用中确有必要,需要开发者显式保留。
性能数据与实现细节
根据作者公布的基准测试结果:
- Token削减幅度:在企业级API负载上达到70%–90%
- 运行时开销:低于0.5毫秒,基于纯Python标准库的AST树摇(tree-shaking)实现
- 外部API调用:0次
这意味着TokenPrune完全在本地进程内完成处理,不需要网络往返,也没有按Token计费的额外成本。对于延迟敏感的Agent场景,这比调用辅助模型做摘要要轻量得多。
作者将项目开源在GitHub(GeekyMK/tokenprune),并发布到了PyPI。
AST树摇(tree-shaking)原本是编译器和打包工具中的概念,指在构建阶段静态分析代码的抽象语法树,移除未被引用的代码以减小产物体积。TokenPrune 借用这一思路,在 Python 运行时对工具返回对象的结构进行静态遍历与重写:识别可安全丢弃的键(如空值、重复元数据),把结构同构的字典列表折叠为表头加行的表示。由于整个过程只依赖标准库、在内存中完成,不触发任何解释器外部的调用,因此能在亚毫秒级完成,且行为完全可复现——相同的输入永远得到相同的剪枝结果,便于调试和单元测试。
适用边界与待验证的问题
TokenPrune的剪枝逻辑是确定性的启发式规则,这既是优点也是局限。优点在于可预测、可调试、无额外成本;局限在于规则可能无法覆盖所有API的返回结构。作者本人也在帖子中坦言,希望了解Agent工作流开发者“启发式规则在哪里会失效”以及“最常处理哪些schema格式”。
几个值得关注的点:
- 表格压缩的适用性:当列表中的对象结构不一致时,表格压缩可能失效或产生歧义,需要开发者自行确认输出是否符合预期。
- 信息丢失风险:剪枝掉的字段(如
doc_url这类链接)在某些调试或溯源场景下可能是必需的,Agent设计时需要权衡保留策略。 - 与提示词工程的配合:TokenPrune只负责压缩工具输出,最终提示词的组织方式仍会影响整体Token消耗。
目前该工具尚未经过大规模生产环境验证,70%–90%的削减数据来自作者自测,实际效果会因API负载类型而异。
小结
TokenPrune提供了一个绕过“辅助LLM摘要”路线的轻量选项:用确定性的本地剪枝替代网络调用,在亚毫秒级完成Token压缩。对于正在构建Agent、且工具输出以结构化JSON为主的开发者,值得在测试环境中评估其剪枝规则是否匹配自己的schema。项目的后续价值,很大程度上取决于社区能否贡献更多针对不同API格式的启发式规则。
相关推荐

Cognition SWE-2 实战:一个提示词搞定产品发布全流程
解析 YouTube 创作者用 Cognition SWE-2 发布产品的完整提示词:落地页、七封邮件序列与未购买用户跟进工具三段式结构,以及"测试并汇报"这一约束如何改变 AI 的交付质量。
AWS AgentCore Gateway:用MCP打通AI Agent与企…
AWS AgentCore Gateway:用MCP打通AI Agent与企业后端
AWS AgentCore Gateway如何作为主MCP服务器聚合REST API、Lambda与已有MCP服务?解析其AST实时映射、零冷启动、语义搜索治工具过载、会话隔离与密钥注入安全设计,以及企业AI Agent解耦后端的架构思路。

一个链接给Figma AI装上新技能:MCP连接器实战
通过粘贴一个MCP服务器链接,Figma中的AI Agent就能获得新工具能力。本文拆解配置流程、超过20个一键接入应用、读写权限与执行策略设置,以及公开HTTPS链接这一关键限制。