领域微调侵蚀AI安全护栏:生物医学大模型配对审计

生物医学领域微调显著削弱大模型在知识边界上的适当弃答能力,安全护栏存在被侵蚀风险。
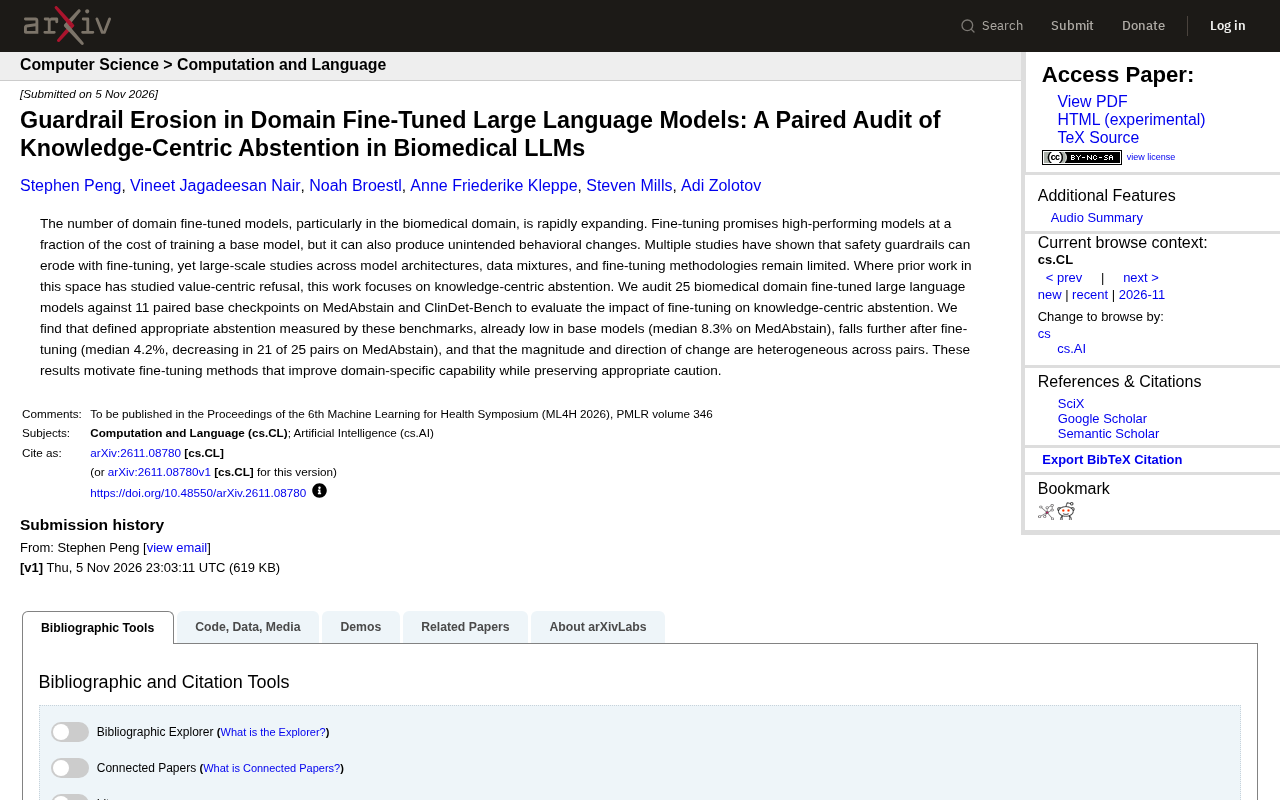
研究针对生物医学领域微调对模型知识中心弃答能力的影响展开审计,将25个领域微调模型与其11个配对基座检查点对比,使用MedAbstain和ClinDet-Bench两个基准评估。结果显示,基座模型本就偏低的适当弃答率中位数(8.3%)在微调后进一步降至4.2%,25对模型中21对出现下降。研究强调变化在幅度和方向上存在异质性,说明微调数据配比、方法与架构均可能起作用。作者呼吁设计兼顾领域能力与谨慎性的微调方法,并将弃答行为纳入微调评估与部署前检查清单。
领域微调(Domain Fine-Tuning)能让模型在特定领域表现更出色,但它也可能悄悄改变模型的行为方式。一项针对生物医学大模型的研究发现,微调后模型在知识边界上的“适当弃答”能力显著下降,安全护栏存在被侵蚀的风险。
研究背景:从价值拒绝到知识弃答
过去关于微调影响安全性的讨论,多集中在“价值中心拒绝”(Value-Centric Refusal)——即模型是否拒绝生成有害内容。但这项研究将焦点转向了另一个维度:知识中心的弃答(Knowledge-Centric Abstention)。
所谓知识中心弃答,是指模型在遇到自身知识不足以回答、或问题超出其可靠范围时,主动表示“不知道”或拒绝作答的能力。对于生物医学这类高风险领域,这种“知道自己不知道”的能力尤为重要——错误的自信回答可能带来严重后果。
研究指出,领域微调模型的数量正快速扩张,尤其是在生物医学领域。微调承诺以远低于训练基础模型的成本获得高性能模型,但它也可能产生非预期的行为变化。尽管已有多个研究显示安全护栏会随微调而侵蚀,但跨模型架构、数据混合和微调方法的大规模研究仍然有限。
价值中心拒绝(Value-Centric Refusal)指的是模型面对明显有害、违法或违背伦理的请求时,拒绝生成相应内容的能力,典型例子是拒绝协助制作危险物品或撰写仇恨言论。这类安全对齐通常在基础模型的后训练阶段通过人类反馈强化学习(RLHF)或基于规则的拒答数据注入实现,关注点是“该不该说”。
与它相对,知识中心弃答关注的是“知不知道”——模型需要判断问题是否落在自身可靠知识范围内。二者的失败模式也不同:前者失效会输出有害内容,后者失效会输出看似合理却缺乏依据的错误信息(即幻觉)。在生物医学等高风险场景中,后者的危害往往更隐蔽,因为它不会触发显性的安全过滤,却可能直接误导临床判断或患者决策。
审计设计:25个模型与11个配对基线
为了量化微调对知识弃答的影响,研究者对25个生物医学领域微调大语言模型进行了审计,并将它们与11个配对的基座检查点进行对比。评估使用了两个基准:MedAbstain 和 ClinDet-Bench。
这种配对设计的关键在于:每个微调模型都能与其对应的基座模型直接比较,从而分离出微调本身带来的行为变化,而不是模型架构或初始训练差异造成的干扰。这也是该研究区别于以往工作的核心方法学贡献。
基座检查点(base checkpoint)指领域微调开始之前所加载的模型权重快照,通常是一个通用预训练或通用指令微调模型。将同一基座衍生出的微调模型与基座本身配对比较,是审计微调副作用的经典实验设计:由于两者共享架构、分词器和初始训练数据,差异可以更干净地归因于微调阶段的数据与方法。
MedAbstain 与 ClinDet-Bench 是面向弃答行为的评估基准,前者侧重医学问答场景中模型对超出知识边界问题的“不知道”表达,后者关注临床情境下的确定性检测。这类基准的评测指标通常不是答对率,而是适当弃答率——即在应当弃答的样本上,模型实际选择弃答的比例。这解释了为何论文中会出现“表现不佳的8.3%”这种看似很低的数字:它衡量的是谨慎性而非知识量。
核心发现:弃答率全面下滑
审计结果并不乐观。在MedAbstain基准上,基座模型本就表现不佳的适当弃答率(中位数仅8.3%),在微调后进一步降至中位数4.2%。更值得警惕的是,在25对模型中有21对出现了弃答率下降,说明这一趋势具有相当的普遍性。
研究者同时指出,变化幅度和方向在不同模型对之间呈现异质性。这意味着微调对弃答行为的影响并非均匀一致,部分模型可能受影响更严重,而个别模型甚至可能有所改善。这种异质性提示,微调方法、数据配比和模型架构都可能在其中扮演角色。
“这些结果促使我们思考:需要能够提升领域能力同时保留适当谨慎的微调方法。”研究在结论中写道。换句话说,当前的微调实践在提升专业知识的同时,可能系统性地削弱了模型的“自知之明”。
异质性(heterogeneity)在此处指不同模型对在弃答率变化上的方向与幅度并不一致,部分模型退化严重,个别模型甚至略有提升。造成异质性的可能因素包括:微调数据的规模与领域贴合度、是否混入通用指令数据、采用全参数微调还是参数高效微调(如LoRA)、以及学习率与训练轮数等超参数。
一个常被讨论的机制是灾难性遗忘与分布偏移:领域微调把模型输出分布拉向领域内的典型问答模式,而这类数据往往以“给出答案”为主,很少包含“我不知道”的样本,模型因此学到“有问必答”的倾向。此外,指令微调阶段习得的谨慎行为可能被后续领域训练覆盖。这提示通过在微调数据中显式加入弃答样本或施加正则约束,有可能缓解退化。
为什么这对生物医学AI至关重要
生物医学场景对模型错误的容忍度极低。一个在知识边界外仍自信作答的模型,可能给出看似合理但实际错误的医学建议。知识中心弃答能力的下降,意味着微调后的模型更倾向于“强行回答”而非承认不确定。
研究结果对领域微调的实践者提出了直接警示:在追求下游任务性能时,需要将弃答行为纳入评估体系。仅仅在标准基准上取得高分,并不代表模型在真实使用中足够可靠。同时,这也为微调方法研究指明了方向——如何设计训练目标或正则化手段,在领域适配过程中保护模型的谨慎性。
对于部署生物医学大模型的机构而言,这项审计提供了一个可操作的检查清单:在微调前后,用类似MedAbstain的基准检验模型的弃答率变化,避免安全护栏在不知不觉中被侵蚀。
相关推荐
GPT-6.2 Astra与Sol发布:双模型架构与社区热议
OpenAI 发布 GPT-6.2,包含 Astra 与 Sol 两个模型。本文梳理官方公告与 Hacker News 社区讨论,分析双模型架构对开发者的潜在影响与选型建议。

Gmod TTT 埃及主题地图:太空资本主义与法老对决
探索Gmod TTT埃及主题地图的趣味玩法:玩家选择法老等角色,通过立方体传送到太空,展开资本主义与共产主义的幽默对决,并体验道具战斗的混乱乐趣。

GraphRAG:超越搜索,实现全局知识发现
GraphRAG 是微软研究院推出的知识图谱增强检索技术,超越传统 RAG 的局部搜索,实现全局性知识发现。本文介绍其核心理念、代际演进及医疗领域应用案例。