零知识证明+共识聚合:打造鲁棒隐私的Swarm Learning

零知识验证者准入与共识聚合打造隐私鲁棒的群体学习框架。
本文介绍了一种鲁棒且隐私保护的 Swarm Learning 框架,旨在解决去中心化验证中因 peers 数据偏差或恶意导致的脆弱性问题。该框架通过零知识证明实现验证者准入,确保只有数据质量达标的节点才能参与验证,且不泄露原始数据;同时利用无标签类别分布生成集体 IID 验证者池,效果接近 oracle。在聚合阶段,采用 Tendermint 风格 BFT 共识达成质量感知的聚合权重,替代传统的数据集大小加权。实验表明,在梯度缩放攻击下,该框架在 CIFAR-100 和 FashionMNIST 上分别保持 94% 和 99% 以上的准确率,而 FedAvg 崩溃至随机水平。此外,借鉴 Split Learning 的 cut-layer 思想实现低成本审计,提升了可扩展性。尽管零知识证明开销和动态网络效率仍是挑战,但该工作为去中心化学习的安全与隐私提供了新思路。
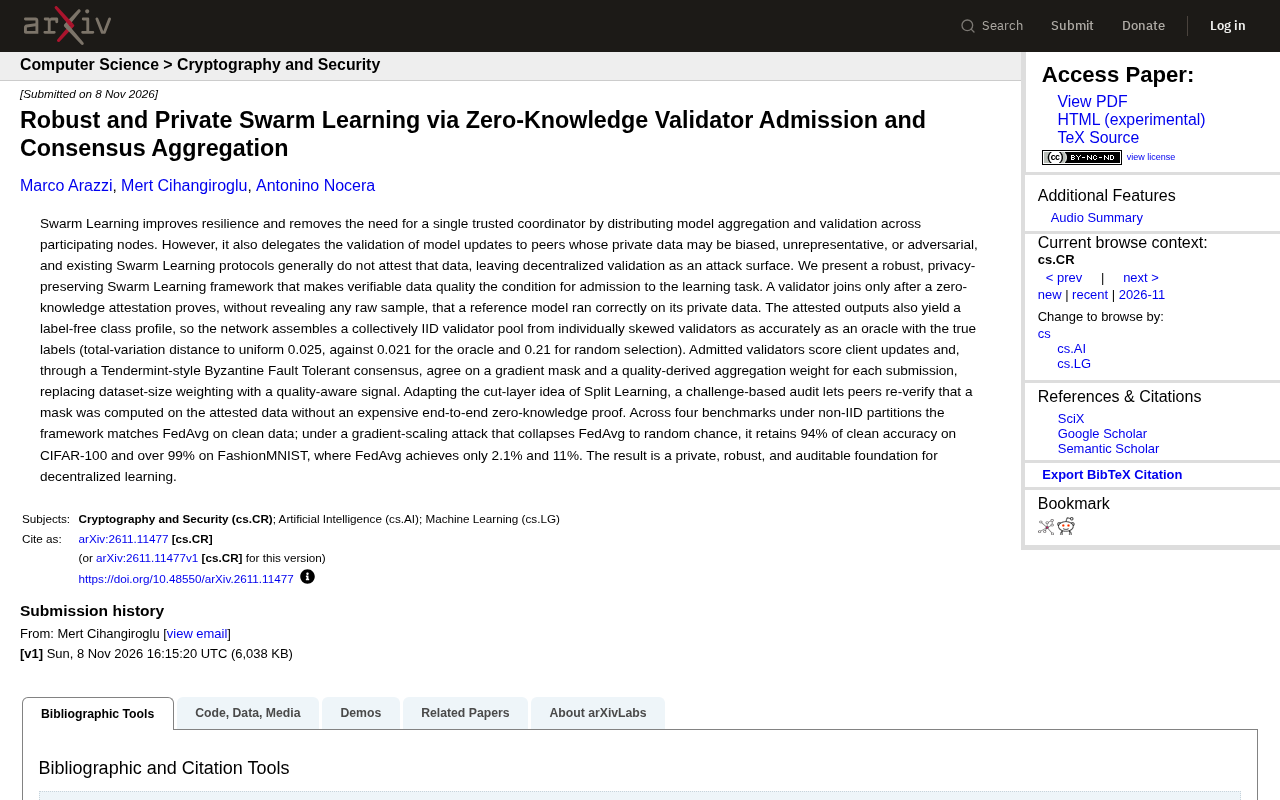
Swarm Learning(群体学习)通过将模型聚合与验证分散到各个节点,消除了对单一中心协调者的依赖,从而提升了系统的韧性和去中心化程度。然而,这种架构也引入了一个关键脆弱点:模型更新的验证被委托给 peers,而这些 peers 的私有数据可能存在偏差、不具代表性,甚至是恶意的。现有的 Swarm Learning 协议通常不对数据质量进行验证,使得去中心化验证本身成为一个攻击面。近期一篇论文提出了一种鲁棒且隐私保护的 Swarm Learning 框架,通过零知识验证者准入和共识聚合机制,将可验证的数据质量作为参与学习任务的前提条件。
核心创新:零知识验证者准入
该框架的核心在于,验证者必须通过零知识证明来证明其私有数据的质量,才能加入学习任务。具体而言,一个验证者需要运行一个参考模型在其私有数据上,并生成零知识证明,证明模型运行正确,同时不泄露任何原始样本。这种机制确保了只有数据质量达标的节点才能参与验证,从而在源头上降低了恶意或偏差数据的影响。
据论文描述,验证者证明的输出还会生成一个无标签的类别分布 profile。通过这种方式,网络能够从各自偏斜的验证者中组装出一个集体 IID 的验证者池,其效果与拥有真实标签的 oracle 相当。实验数据显示,该池与均匀分布的 total-variation 距离为 0.025,而 oracle 为 0.021,随机选择则为 0.21。这表明该方法在无需真实标签的情况下,有效逼近了理想的数据分布。
零知识证明(Zero-Knowledge Proof, ZKP)是一种密码学协议,允许证明者向验证者证明某个陈述为真,而无需透露陈述本身之外的任何信息。在区块链和隐私计算领域,zk-SNARKs 和 zk-STARKs 是两种主流实现,它们能够将计算过程的正确性压缩成简短证明,供他人快速验证。在本框架中,验证者需要证明其正确运行了参考模型,但不必公开私有数据,这正是零知识证明的典型应用:将“数据质量达标”这一事实转化为可验证的密码学证据,从而在不泄露隐私的前提下建立信任。
共识聚合:质量感知的权重分配
被准入的验证者负责对客户端更新进行评分,并通过 Tendermint 风格的拜占庭容错共识,就每个提交的梯度掩码和质量衍生的聚合权重达成一致。这一机制用质量感知的信号取代了传统的数据集大小加权,使得聚合过程更加鲁棒。共识聚合不仅确保了验证结果的一致性,还能抵御拜占庭节点的恶意行为。
为了降低验证成本,框架借鉴了 Split Learning 的 cut-layer 思想,引入基于挑战的审计机制,允许 peers 重新验证掩码是否在已证明的数据上计算,而无需昂贵的端到端零知识证明。这种设计在保证安全性的同时,显著提升了系统的可扩展性。
Tendermint 是一种拜占庭容错(BFT)共识算法,广泛应用于区块链系统。它通过多轮投票机制,使分布式节点在存在恶意节点(最多不超过总节点数的三分之一)的情况下仍能达成一致。Tendermint 的核心包括提案、预投票和预提交三个阶段,并依赖锁定机制保证安全性。在本框架中,Tendermint 风格共识被用于对客户端更新的评分和聚合权重达成一致,确保即使部分验证者作恶,系统仍能输出正确的聚合结果。这种共识机制与零知识准入相结合,构成了去中心化验证的完整闭环。
Split Learning(拆分学习)是一种分布式机器学习范式,它将神经网络按层拆分为客户端部分和服务器部分,客户端仅计算到 cut-layer(切割层)并将中间激活值发送给服务器,从而保护原始数据隐私。cut-layer 思想的核心在于,中间表示足以支持后续计算,而无需暴露完整模型或数据。在本框架中,cut-layer 被借鉴用于审计:peers 可以要求验证者重新计算掩码在 cut-layer 处的中间结果,以低成本验证其是否基于已证明的数据计算,而无需重复执行昂贵的端到端零知识证明。这显著降低了验证开销,提升了系统的可扩展性。
实验结果:鲁棒性显著提升
在非独立同分布(non-IID)分区下的四个基准测试中,该框架在干净数据上的表现与 FedAvg 相当。然而,在面对梯度缩放攻击时,FedAvg 的性能崩溃至随机水平,而该框架则保持了鲁棒性。具体来说,在 CIFAR-100 上,该框架保留了 94% 的干净准确率,而 FedAvg 仅为 2.1%;在 FashionMNIST 上,该框架保持了超过 99% 的准确率,而 FedAvg 仅为 11%。这些结果凸显了该框架在对抗性环境下的显著优势。
通过多源交叉验证,我们可以确认该框架在隐私保护、鲁棒性和可审计性方面提供了坚实的基础。零知识证明确保了数据隐私,共识聚合增强了鲁棒性,而基于挑战的审计则实现了可审计性。尽管该框架目前仅在四个基准测试上进行了评估,但其设计理念为去中心化学习的安全与隐私提供了新的思路。
梯度缩放攻击(Gradient Scaling Attack)是一种针对联邦学习/分布式学习的投毒攻击。恶意客户端通过放大或缩小其上传的梯度,试图扭曲全局模型的更新方向,使其偏离最优解甚至崩溃。在传统 FedAvg 中,由于聚合权重通常基于数据集大小,攻击者可以通过控制大量样本或直接放大梯度来主导聚合结果。本框架通过质量感知的权重分配和共识验证,能够识别并抑制异常梯度,从而在攻击下保持模型性能。实验中 FedAvg 准确率骤降至随机水平,而本框架仍保持高位,直观体现了质量感知聚合的防御效果。
未来展望与挑战
该框架的提出为 Swarm Learning 的安全性问题提供了创新性的解决方案,但仍有一些挑战需要进一步研究。例如,零知识证明的计算开销可能成为大规模部署的瓶颈,尽管 cut-layer 审计缓解了部分压力。此外,共识机制在动态网络环境下的效率与安全性也需要更深入的评估。未来工作可以探索更高效的零知识证明方案,以及将框架扩展到更多实际应用场景中。
总体而言,这项研究通过零知识验证者准入和共识聚合,为构建隐私、鲁棒且可审计的去中心化学习基础做出了重要贡献。
相关推荐

Aircad:浏览器里的专业制图与3D建模新选择
Aircad在Hacker News展示浏览器端专业制图与3D建模能力,探索无需安装的CAD工作流。本文分析其定位、潜在优势与早期项目的不确定性。

AI做新闻,受众为何不买账?
AI正成为信息入口,但受众仍抵触AI生产新闻。本文分析信任赤字根源、信息入口与内容生产的边界,以及对媒体机构AI化的现实启示。

律所如何用AI重塑法律业务?Gilbert + Tobin的实践
澳大利亚律所Gilbert + Tobin合伙人兼CEO Sam Nickless谈律所如何用AI重新思考法律业务模式,从效率工具走向业务逻辑重构,以及CEO层级介入AI战略的意义。