浏览器端人脸分析实战:MediaPipe 实现隐私优先的面部测评应用

FaceRuler 将人脸评分完全放在浏览器端:MediaPipe 478 关键点 WASM 推理,纯函数数学引擎输出可复现的 PSL 分数。
FaceRuler 是一款把颜值评分推理完全留在浏览器内的应用,使用 MediaPipe FaceLandmarker 的 478 个关键点,通过 WASM 在本地运行,照片从不离开标签页。整条管线是检测、测量、映射三步:关键点转几何比例,再由一个确定性函数把比例映射到 0–100 子分数,最后经逻辑斯蒂曲线落到 PSL 0–8 量表,其中"完全平均"锚定在 4.0。评分引擎全部是纯函数,单元测试全过,重新校准只需改一行。文章详述了四个真正棘手的技术点:头部旋转校正、归一化坐标的宽高比压缩、FWHR 与学术定义的不可比性,以及用标准差而非均值衡量和谐度。前端部分则记录了 React 19 合成事件在程序化触发时失效、依赖 ref 的节点不能条件渲染、fumadocs 版本错配 500、undici 忽略系统代理等踩坑经验。
为什么要在浏览器端做人脸分析
大多数"给我颜值打分"的工具会把你的自拍传到服务器,用后端模型跑一遍再返回结果。问题是:这是一张和你身份绑定的脸,流向的却是不透明的服务器基础设施。对于颜值评分这类产品而言,信任问题本身就是产品的一部分——如果"照片不上传"这个承诺不是字面意义上可验证的,其他一切都不重要。
FaceRuler 选择了另一条路:推理完全在浏览器内完成,使用 MediaPipe 的 FaceLandmarker(478 个关键点)编译为 WASM 运行。模型(约 3.6 MB)和 WASM 运行时都由自有源站提供,推理阶段不产生任何第三方请求。照片不会在"处理后被删除"——它从未离开过浏览器标签页。
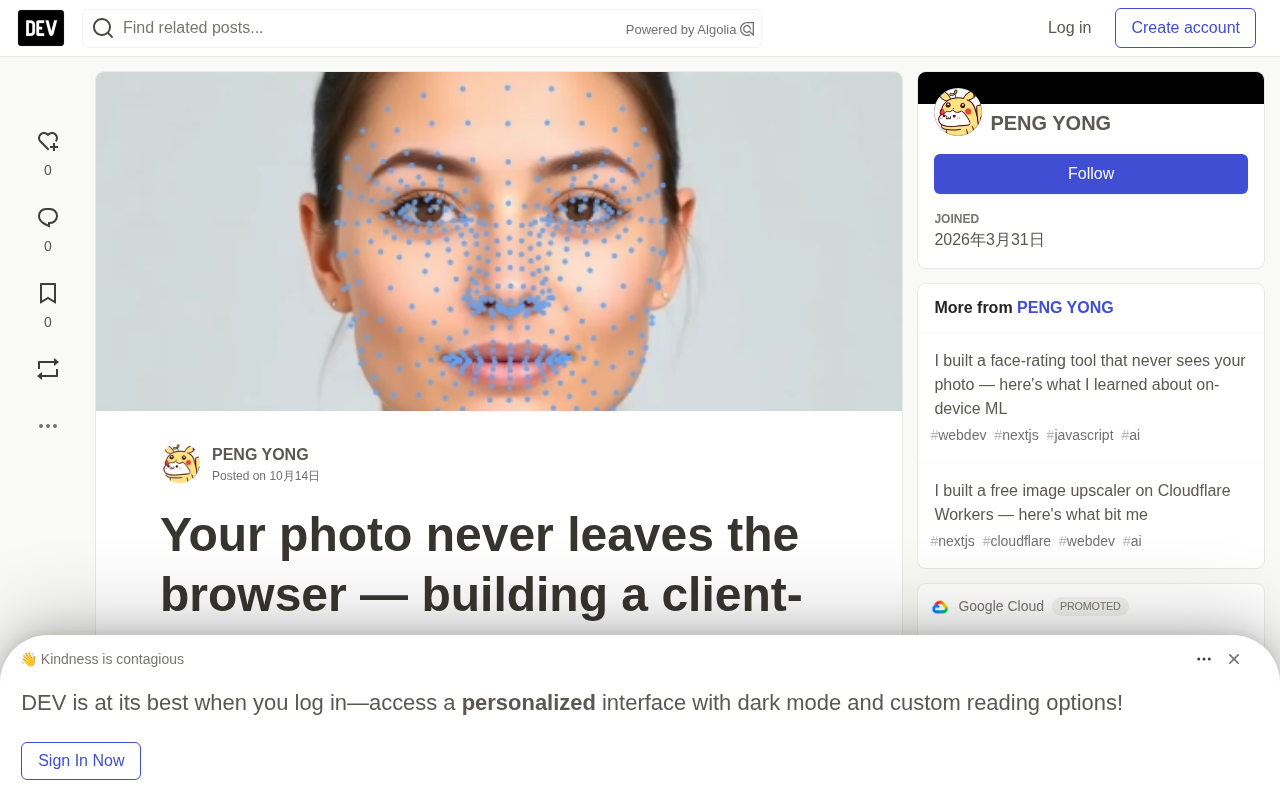
这个约束决定了整个应用几乎每一处工程决策。
MediaPipe FaceLandmarker 是 Google 开源的一套端侧人脸感知方案,属于 MediaPipe 家族中专门处理面部拓扑的模块。它基于 BlazeFace 检测器先定位人脸区域,再通过回归网络输出 478 个三维关键点,覆盖五官轮廓、眼球虹膜乃至面部密集网格。与需要上传图片到云端的方案不同,FaceLandmarker 提供可编译为 WebAssembly 的运行时,模型体积控制在数 MB 量级,能在普通笔记本和手机的浏览器里以接近实时的速度跑完一帧。所谓 WASM(WebAssembly)是一种可移植的二进制指令格式,让 C++/Python 写的高性能代码在浏览器沙箱中以接近原生速度执行,是当前客户端 AI 推理的主流载体之一。关键点之所以用归一化坐标返回,是因为它要与输入图像尺寸解耦,这也正是后文宽高比陷阱的来源。
核心管线:检测 → 测量 → 映射
整个处理流程分三步:
- 检测:MediaPipe 返回 478 个归一化关键点,应用将它们绘制在 canvas 上作为可视化凭证。
- 测量:纯几何计算把关键点转化为比例——面部三庭、FWHR、眼角倾斜度、下巴比例等。
- 映射:一个确定性函数将比例转化为 0–100 的子分数,再映射到 PSL 0–8 量表。
没有 LLM,没有"AI 感觉"。同样的关键点永远产生同样的报告。这既是技术选择也是产品决策:一个你无法复现的分数,就是一个你无法质疑的分数——而这款产品的用户恰恰是爱较真的那群人。
评分引擎就是数学,这正是关键
每个子指标围绕参考目标值做高斯衰减评分:
export const targetScore = (value: number, target: number, tol: number): number => {
  const z = (value - target) / tol;
  return 100 * Math.exp(-0.5 * z * z);
};
八个子指标汇总为五个维度,权重固定:对称性 0.2、比例 0.25、结构 0.25、眼部 0.15、和谐度 0.15。加权总分(0–100)通过逻辑斯蒂曲线映射到 PSL 量表,锚定条件是"完全平均"的脸恰好落在 4.0:
// overall 50 -> exactly 4.0 on the 0-8 PSL scale
export const overallToPsl = (overall: number): number =>
  8 / (1 + Math.exp(-(overall - 50) / 13));
中位数定在 4.0 而非 5.0。PSL 量表刻意比日常评分更严格。百分位使用均值 4.0、标准差 0.9 的正态分布。因为全是纯函数,整个引擎有完整的单元测试(12/12 通过),重新校准只需改一行,而不是重新训练模型。
高斯衰减评分的思路是把每个面部指标都设一个"理想目标值",偏离越远分数越低,衰减曲线是标准正态的钟形函数 exp(-z²/2)。这样做的优点是平滑、可导、无阈值跳变:一张脸从"接近理想"到"稍微偏离",分数是连续变化的,不会出现卡在某个临界点突然掉一大截的情况。逻辑斯蒂映射(logistic function)则是把任意实数域的总分压缩到 0–1 的 S 形曲线,再线性拉伸到目标量表。它天然具有饱和特性——极高和极低的输入都被压向边界,中间段近似线性,因此常用于把无界的连续分数转成有界的等级分。二者组合的典型好处是:整条评分链路都是初等函数,没有随机性、没有需要迭代收敛的过程,给定输入必然得到唯一输出。这正是"可复现"的技术底座。
四个真正棘手的技术难题
1. 头部旋转
倾斜拍摄的照片不应该改变分数。方案是从额头顶部到下巴测量中轴线角度,在计算任何指标前将所有关键点旋转到校正后的坐标系。垂直距离(比如 FWHR 的分子)对此尤其敏感。
2. 宽高比悄悄压缩了面部指数
MediaPipe 返回归一化坐标:x 除以图像宽度,y 除以图像高度。天真地计算高宽比时,3:4 的竖版照片读出的脸会比同样一张脸在方形画布上"短"约 25%。修正方法是将 y 分量缩放回像素等效空间。
3. FWHR 和论文里的定义不是一回事
学术文献中的面部宽高比(1.85–1.9)是在物理照片上测量的。在归一化关键点空间中,鼻根到上唇的距离约为颧骨宽度的 36%,两套数字根本不可比。开发者从关键点批次中校准出自己的中心值(2.75),并记录了这种不匹配,而不是假装论文数值可以直接套用。
PSL 量表(Puget Sound Looksmaxxing scale)源自网络社群对男性面部吸引力的 0–8 分级,并非学术心理学量表。它的特点是刻度故意偏严:4.0 被定义为"完全平均",而非直觉上的 5.0,意味着多数人落在 4 以下或略高于 4,8 几乎不可达。这种设定让用户对"普通"的感知被压低、对"高于平均"的渴望被放大,带有明显的产品心理设计。学术文献常用的 FWHR(面部宽高比)通常在真实照片上以物理毫米为单位测量,典型男性值约为 1.85–1.9。当测量空间换成 MediaPipe 的归一化关键点后,鼻根到上唇的物理距离与颧骨宽度的比值完全不同,数值会跃升到 2.5 以上。因此任何把论文基准直接搬到关键点空间的尝试都会系统性偏低或偏高,必须像文中那样重采样校准。
4. 和谐度不是平均值
对子分数取平均会奖励一张处处平庸的脸。开发者想要恰恰相反的东西——一致性。所以"和谐度"是由子分数的标准差推导的:一个拖后腿的特征会拉低它。
前端踩坑:花费最多时间的经验
React 19 合成事件在程序化触发时失效
上传组件需要同时服务真实用户和通过 DataTransfer 注入 File 的自动化测试。React 的合成 onChange 在注入路径下不触发。修复方式是用 ref 挂载原生 addEventListener 替代合成处理器——对真实用户也更健壮。
依赖 ref 的 DOM 节点绝不能放进条件渲染
结果 canvas 曾放在 report && (...) 内。首次报告生成前,canvasRef.current 为 null,绘制函数的守卫静默返回——没有报错,没有输出,什么都没有。同一个 bug 在两个不同组件里各踩了一次。现在强制规则:依赖 ref 的节点始终挂载,用 hidden 切换可见性。
一个依赖版本错配能 500 掉整个内容层
所有 MDX 页面因 TypeError: files.map is not a function 崩溃。根因是 lockfile 将 fumadocs-core 解析到 15.8.5,而 fumadocs-mdx 11.10.1 期望 15.7.x 接口。锁定 fumadocs-core@15.7.13 后修复。
fumadocs 是一套面向 Next.js 的文档/内容框架,由 fumadocs-core(运行时与 API)和 fumadocs-mdx(把 MDX 编译进内容树的构建插件)等包组成。两个包通过内部接口通信,并不属于强绑定依赖——npm 生态里这很常见。当 fumadocs-mdx 期望 core 返回数组、而新版 core 改成了返回 Map 或对象时,files.map is not a function 就会在整个内容层爆炸。这类 bug 的隐蔽之处在于:单看报错栈完全指向内容加载逻辑,与版本号毫无关系,只有在 lockfile 里对比两个包的解析版本才能定位。锁定一个兼容版本比升级全套依赖更安全,因为升级 mdx 可能连带触发 MDX 语法和预设的变更。
Node 的 undici fetch 忽略系统代理
服务端 OAuth 静默超时,报出误导性的 invalid_code。为开发环境配置 ProxyAgent 全局 dispatcher 后解决,生产环境在 Workers 上自动空操作。
技术栈
Next.js 16(App Router),通过 OpenNext 部署在 Cloudflare Workers 上,D1 存储许可/权限表,付费深度报告使用托管结账。MediaPipe 完全客户端运行,服务器永远看不到图像。
对隐私敏感型 AI 应用的启示
这个案例的价值超出人脸分析本身。当"数据不离开设备"是产品的核心卖点时,架构选择不是性能取舍,而是信任基础设施。纯函数评分引擎带来的可复现性、可测试性和可审计性,恰恰是黑盒模型无法提供的。对于任何需要用户交出生物特征或个人数据的 AI 应用,客户端推理正在从"锦上添花"变成"基本要求"。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。