流匹配中的速度缩放:为何有效的真正原因

新研究推翻速度缩放的流行解释,指出真正原因是采样时的群体时间滞后,并据此将ImageNet-256的FID从28.0降至12.2。
流匹配生成模型中,速度缩放技巧长期被解释为对MSE训练导致速度幅值不足的补偿。最新研究(arXiv:2610.10823)推翻了这一说法,证明MSE训练并不产生速度幅值缺口。真正的根源是"群体时间滞后"——离散化ODE求解器的累积误差使采样状态对应训练分布中更早时刻的特征,造成时间维度上的错位。速度缩放与回拨模型时间本质上是补偿同一问题的两种等价方式。基于对时间滞后的直接测量来选择增益系数,在ImageNet-256(NFE=25,无引导)上将FID从28.0大幅降至12.2,且效果在不同架构和模型规模上均保持一致,为流匹配模型的推理调优提供了更可靠的理论与实践依据。
速度缩放:一个被误读的技巧
在生成模型的流匹配(Flow Matching)框架中,研究者此前发现了一个颇具实用价值的技巧:将训练得到的速度场 $v_\theta$ 乘以一个随时间变化的增益系数 $\gamma(t)$,就能显著提升生成质量。这个看似简单的操作在实践中效果立竿见影,但它背后的机制究竟是什么,一直存在争议。
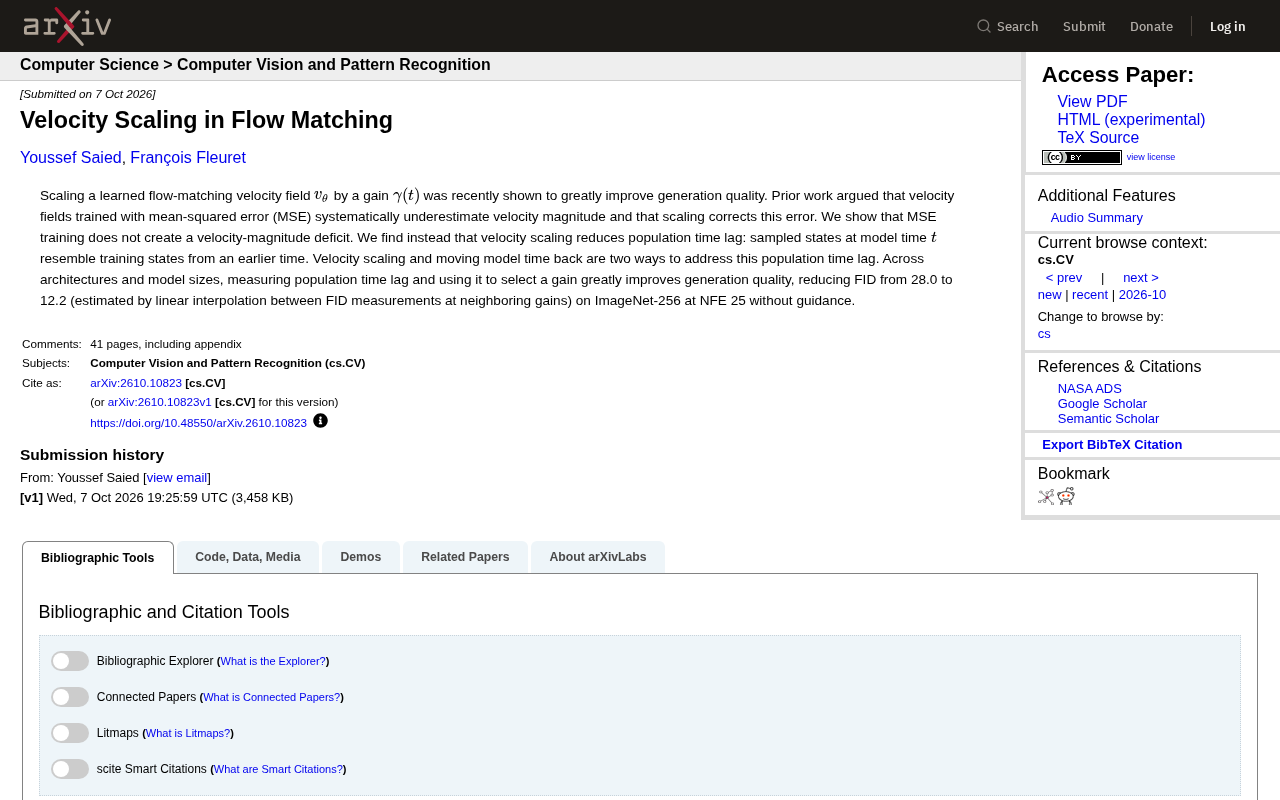
一篇最新发布于 arXiv 的研究(arXiv:2610.10823v1)对这个问题给出了与主流解释截然不同的答案。此前的工作认为,用均方误差(MSE)损失训练出的速度场会系统性地低估速度的幅值,而速度缩放正是对这一误差的修正。换句话说,流行观点把速度缩放理解为一种对训练缺陷的补偿。
**流匹配(Flow Matching)**是近年来生成模型的重要范式之一。其核心思想是学习一个连续时间的速度场 $v_\theta(x, t)$,将噪声分布($t=0$)沿着轨迹逐步"流动"到数据分布($t=1$)。训练时,模型被要求在每个时间步预测将当前状态推向目标的速度向量,损失函数通常采用均方误差(MSE)。推理时,从噪声出发,用数值ODE求解器(如Euler法)沿速度场积分,最终生成样本。与扩散模型相比,流匹配的训练目标更直接、轨迹更"笔直",理论上可以用更少的采样步数(NFE,Number of Function Evaluations)获得高质量结果。正是在追求少步高质量采样的背景下,速度缩放这类推理阶段的调整技巧才显得格外重要。
真正的问题不是速度被低估
这项研究的核心贡献,在于推翻了"MSE 训练导致速度幅值不足"这一假设。作者通过分析指出,MSE 训练并不会产生所谓的速度幅值缺口。也就是说,模型学到的速度大小本身并没有系统性偏小,之前的解释找错了病根。
那么速度缩放为什么还有效?研究给出了一个更本质的解释——群体时间滞后(population time lag)。具体来说,在模型时间 $t$ 处采样得到的状态,其实更像是训练数据中更早时间点的状态分布。采样轨迹在时间轴上落后了。这种滞后才是导致生成质量下降的真正原因。
两种等价的修正方式
一旦把问题定位到时间滞后上,解决思路就变得清晰了。研究指出,速度缩放和将模型时间往回拨本质上是解决同一个问题的两种途径。前者通过放大速度让采样状态更快地推进,后者则直接在时间维度上做校正。二者殊途同归,都是在补偿群体时间滞后带来的偏差。
这个视角的转变意义重大:它把一个被当作"误差修正"的经验技巧,重新解释为对采样动力学时间对齐问题的处理,为后续方法设计提供了更可靠的理论基础。
**群体时间滞后(population time lag)**可以这样直观理解:流匹配模型在训练时,对每个时间步 $t$ 都见过大量 $(x_t, v_t)$ 配对样本,并学会预测条件期望速度 $\mathbb{E}[v | x_t, t]$。然而在推理时,ODE求解器(尤其是步长较大的Euler法)会引入离散化误差,使实际积分轨迹偏离理想流线。这种偏差具有累积性:每一步的微小误差会让状态 $x_t$ 漂移到训练分布中"更早"时刻才会出现的区域。换言之,模型在时间 $t$ 处接收到的输入,更像是训练集中时间 $t - \Delta$ 的典型状态,$\Delta$ 就是所谓的时间滞后。这一现象并非模型学习能力不足,而是离散化求解与连续训练之间的结构性错位,在步数较少(NFE较小)时尤为显著。
用时间滞后指导增益选择
理论解释之外,这项工作还给出了可操作的方法。既然群体时间滞后是关键变量,那么直接测量它并据此选择增益系数 $\gamma(t)$,就能系统性地提升生成质量,而不必依赖反复试错。
实验结果相当有说服力。在 ImageNet-256 数据集上,在 NFE(函数评估次数)为 25、且不使用引导(guidance)的条件下,这种基于时间滞后测量的增益选择方法,将 FID 从 28.0 降低到了 12.2(该数值通过相邻增益的 FID 测量值线性插值估计得到)。FID 降低超过一半,意味着生成样本的质量和多样性都有大幅改善。
更重要的是,这一效果在不同架构和不同模型规模上都保持一致。方法的普适性说明群体时间滞后确实是一个贯穿流匹配采样过程的通用现象,而非特定模型的个例。
**FID(Fréchet Inception Distance)**是评估生成图像质量与多样性的标准指标。其计算方式是:分别提取真实图像和生成图像在预训练Inception网络中间层的特征,将两组特征各自拟合为多元高斯分布,然后计算两个高斯分布之间的Fréchet距离。FID越低,说明生成分布与真实分布越接近,即生成质量和多样性越好。FID从28.0降至12.2意味着生成样本在视觉保真度和分布覆盖度上都有显著提升,这一幅度在无额外训练、仅调整推理策略的前提下尤为突出。需要注意的是,文中该数值通过相邻增益的FID线性插值估计得到,实际效果可能略有出入,但数量级上的改善具有重要参考价值。
对生成模型实践的启示
这项研究的价值不只在于刷新了一个具体指标。它提醒从业者:一个在实践中有效的技巧,其流行解释未必正确。速度缩放一度被归因于"修正速度幅值不足",而真实原因却是时间维度上的分布错位。
从工程角度看,这意味着调优流匹配模型时,与其盲目调整增益大小,不如先去测量采样过程中的群体时间滞后,用它来指导增益的选取。这种以可测量量为依据的方法,比经验性的网格搜索更高效,也更容易迁移到新的模型和数据集上。
对于研究社区而言,这一工作也示范了对既有经验方法进行机制层面重新审视的重要性——找对病因,才能开出更好的药方。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。