LlamaIndex v0.14.25发布:大规模安全修复与核心功能增强

LlamaIndex v0.14.25以安全加固为核心,横扫数十个集成包漏洞并修复多项生产环境关键Bug。
LlamaIndex v0.14.25是一次以安全性和稳定性为主线的维护性版本,未引入颠覆性新功能,但在三个层面完成了系统性整治。安全层面,通过一次横跨数十个集成包的统一漏洞修复,以及对93个Dependabot卡住依赖清单的集中重新锁定,显著降低了供应链风险。稳定性层面,核心库恢复了compact与refine两种模式的流式输出能力,优化了工具调用的重试逻辑,新增了StructuredLLMRerank的异步支持,并修复了元数据空值处理的崩溃问题。生态协同层面,将openai-like基础依赖统一升级至0.8.x,影响26个主流LLM集成包,同时修复了OpenAI与Gemini在多模态工具结果中图片无法保留的问题。对于生产环境中依赖LlamaIndex的团队,尤其是有安全合规要求的企业用户,本版本提供了充分的升级理由。
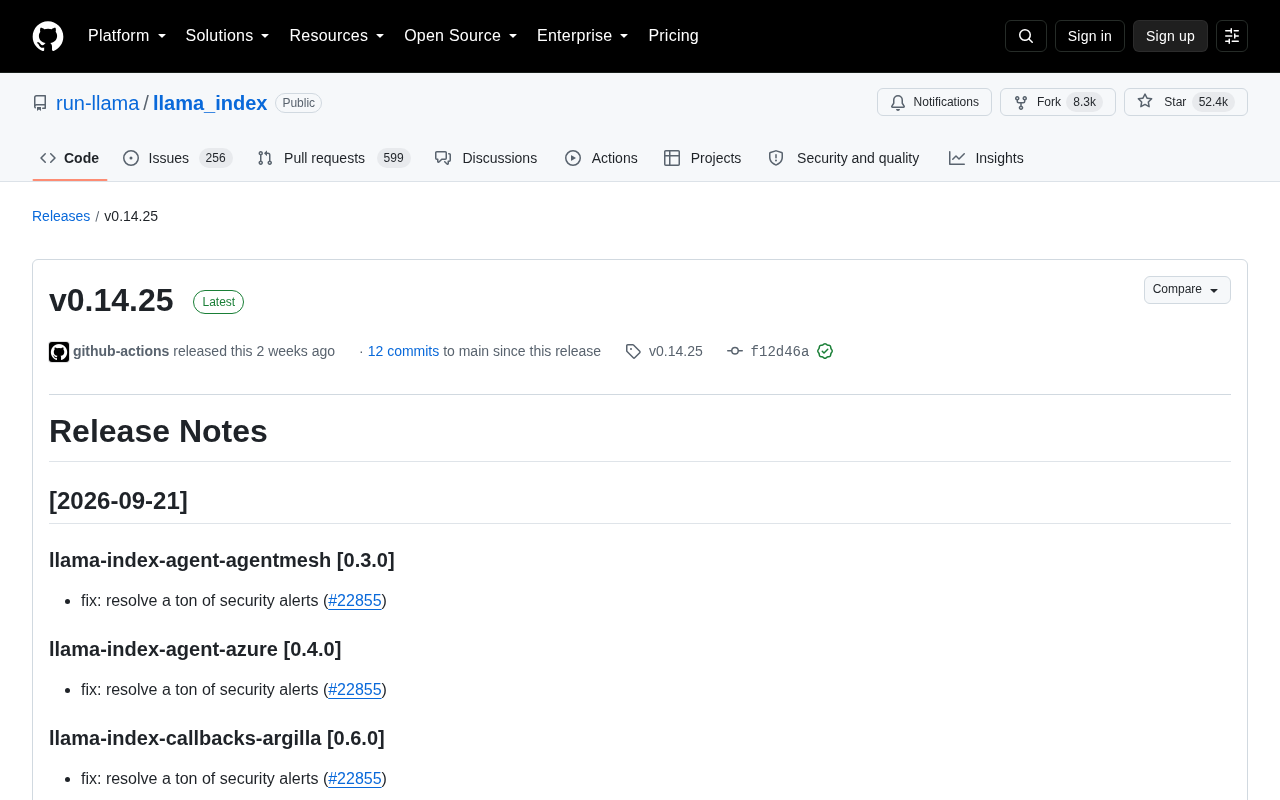
LlamaIndex作为当下最流行的RAG(检索增强生成)与LLM应用开发框架之一,拥有超过52.4k的GitHub星标和8.3k的Fork数。其最新发布的v0.14.25版本并非一次激进的功能迭代,而是一次以安全加固和稳定性提升为主线的维护性更新。对于正在生产环境中使用LlamaIndex的团队来说,这个版本值得关注。
一次大规模的安全修复行动
本次更新最醒目的主题,是贯穿几乎所有子包的 fix: resolve a ton of security alerts(#22855)。从agent模块、callbacks回调集成,到embeddings嵌入模型适配器、instrumentation监控工具,数十个集成包都同步升级了小版本号,统一修复了安全告警。
这种“横扫式”的修复方式反映出LlamaIndex模块化架构的特点——核心框架之外,大量功能通过独立发布的集成包(integration packages)实现。无论是Azure、Bedrock、Cohere还是国内的阿里云广告AI搜索、智谱AI、DashScope等生态,都有对应的独立包。当底层依赖出现安全漏洞时,维护团队需要对所有受影响的包进行逐一升级。
配合安全修复,团队还执行了 chore: re-lock the 93 manifests with stuck Dependabot alerts(#22921),一次性重新锁定了93个因Dependabot告警卡住的依赖清单。这意味着许多长期悬而未决的依赖版本冲突得到了集中清理,对项目的供应链安全是一次重要的整体性提升。
Dependabot是GitHub提供的自动化依赖安全扫描工具,能够检测项目依赖中已知的CVE漏洞并自动提交Pull Request建议升级。对于LlamaIndex这类拥有数百个集成包的生态系统,Dependabot告警会随时间大量积累——当某个基础库(如cryptography、requests等)存在漏洞时,所有直接或间接依赖它的集成包都会收到独立的告警。"锁定依赖清单"(re-lock manifests)的操作本质上是重新生成各包的poetry.lock或requirements.txt锁定文件,将依赖树中的每个包版本精确固定到通过安全审查的最新状态,从而消除因版本范围模糊导致的供应链风险。对于有SOC2或ISO 27001合规要求的企业,依赖清单的定期重新锁定往往是安全审计的必检项。
核心库 llama-index-core 的关键改进
作为整个框架的中枢,llama-index-core [0.14.25] 本次带来了多项实质性的bug修复与功能增强:
流式处理与工具调用的稳定性
- 恢复compact与refine的流式输出(#22836):此前这两种响应合成模式的流式能力出现问题,本次得到修复,对需要实时返回生成结果的应用至关重要。
- 避免对失败的函数工具进行重试(#22841):当函数工具执行失败时,框架不再盲目重试,减少了无效调用和潜在的副作用风险。
- 覆盖流式工具调用中的空参数场景(#22825):补充了对边界情况的测试覆盖,提升了Agent工具链的鲁棒性。
compact与refine是LlamaIndex中两种经典的响应合成(Response Synthesis)策略。compact模式会将检索到的多个文本块尽量压缩合并后送入LLM,以减少API调用次数;refine模式则采用迭代方式,依次将每个文本块送入LLM并逐步精炼答案。这两种模式在处理长文档或多文档问答时尤为常用。流式输出(streaming)允许LLM在生成过程中逐Token实时返回结果,而非等待完整回答后一次性输出,这对聊天界面的用户体验至关重要。此次修复意味着使用这两种模式构建的应用可以重新获得低延迟的实时响应能力。
元数据与重排序能力
- 元数据替换的空值回退处理(#22773):当元数据替换的目标值为
None时,核心库现在会进行安全回退,而非直接报错。 - 为StructuredLLMRerank新增原生异步支持(#22842):结构化LLM重排序器获得了异步能力,这对于高并发检索场景下的性能优化有直接帮助。
此外,核心库还移除了已废弃的 ipex-llm 和 optimum-intel IPEX集成(#22406),持续清理技术债务。
LLM集成层的生态协同升级
本次版本在LLM集成层的一个明显动作,是统一将 llama-index-llms-openai-like 的依赖版本锁定提升至0.8.x(#22907),这一改动影响了多达26个消费方。包括DeepSeek广告、Groq、Together、Databricks、Perplexity、智谱(zhipuai)、MiniMax、StepFun等众多主流LLM提供商的集成包,都因此同步发布了补丁版本。
这种“牵一发而动全身”的升级,体现了LlamaIndex对OpenAI兼容接口的高度依赖——大量第三方LLM服务通过OpenAI-like协议接入,统一基础依赖版本有助于避免生态内部的兼容性碎片化。
具体的集成改进还包括:
- OpenAI(0.8.1):修复了Responses API工具结果中图片与文件无法保留的问题(#22906)。
- Google GenAI(0.11.2):修复了Gemini工具请求ID的问题(#22368),并确保Gemini函数响应中的图片得以保留(#22919)。这两项修复对多模态Agent应用尤为关键。
- Perplexity(0.6.1):新增了集成归因请求头(#22854)。
AG-UI协议的安全性修复
值得关注的还有 llama-index-protocols-ag-ui [0.5.0] 的一项修复:不再在服务端持久化前端工具结果(#22727)。这是一个涉及数据隔离的改动,避免了前端工具执行结果被意外保存在服务端,符合最小权限与数据安全的设计原则。
AG-UI(Agent-UI)是LlamaIndex提出的一种标准化协议,用于规范AI Agent后端与前端界面之间的通信方式,涵盖工具调用、状态同步、流式事件等交互模式。"前端工具"指的是运行在用户浏览器或客户端的工具函数(如表单提交、本地文件读取),其执行结果理论上属于客户端数据。若服务端将这些结果持久化到数据库,可能导致用户隐私数据被意外留存,在多租户场景下还可能引发数据越界访问的风险。此次修复通过在服务端丢弃前端工具的执行结果而非落库,严格遵守了"数据最小化"原则,对于需要处理敏感用户输入的企业级Agent应用来说是不可忽视的安全改进。
对开发者的实际意义
综合来看,v0.14.25是一个典型的“打磨型”版本。它没有颠覆性的新功能,但在三个维度上做足了功课:
- 安全性:横跨数十个包的漏洞修复与93个依赖清单的重新锁定,显著降低了供应链风险。
- 稳定性:流式输出恢复、工具调用重试逻辑优化、空值安全处理,这些修复直接关系到生产环境的可靠性。
- 生态一致性:统一OpenAI-like依赖版本,减少了多LLM接入时的版本冲突。
对于正在使用LlamaIndex构建RAG系统或Agent应用的团队,尤其是依赖Gemini多模态能力、OpenAI Responses API,或使用compact/refine流式响应的场景,建议评估升级。而对于关注安全合规的企业用户,这次大规模的安全告警清理本身就是升级的充分理由。
相关推荐

Jev判断模型实战:6类高频应用场景全解析
Jev是全新的AI判断模型,擅长大规模、高速、低成本的瞬间判断。本文梳理Choice、Score、Null三种提问方式,解析数据分析、语义搜索、输入分流、规则检查、加速智能体、即时响应六大真实应用场景,并给出适用判断标准与风险提示。

AI无需超级智能或恶意,也可能引发核战争
AI引发核战争的真正风险不在于超级智能或恶意,而在于误报、自动化偏见和决策时间压缩。本文分析平庸AI在核指挥系统中的隐患,以及人在回路、可解释性等应对之道。

AI智能体的真实风险:被夸大的"黑客"与被忽视的隐患
AI智能体"黑客"事件频发,但真实风险究竟是什么?本文剖析OpenAI训练暂停、DNS隧道漏洞、Meta Muse隐私泄露,以及智能体消除摩擦可能引发的银行挤兑与医疗成本上涨,提出"AI现实主义"的理性视角。