llm-gemini 0.35 支持 Gemini 4 Argon:性能与定价双看点

llm-gemini 0.35 快速支持 Gemini 4 Argon,本文分析其能力、定价与真实成本。
开源工具 llm-gemini 发布 0.35 版本,第一时间支持 Google 新模型 Gemini 4 Argon,开发者可在命令行中直接调用。Simon Willison 用“鹈鹕骑自行车”测试显示,Argon 在 SVG 生成上延续 Gemini 系列优势,高、中、低三档表现均出色。定价方面,发布时为每百万输入 2 美元、输出 10 美元,与 GPT-6 Sol 持平,但 12 月 1 日起将翻倍至与 Claude Opus 5.5 同价。Artificial Analysis 基准测试表明,Argon 完成任务的总成本为 2,407 美元,处于 14 个对比模型的中低区间,涨价后仍略低于 GPT-6 Astra。文章建议开发者关注智能体框架下的实际 token 消耗,而非单纯单价。
引言:llm-gemini 0.35 快速跟进新模型
开源工具 llm-gemini 发布 0.35 版本,第一时间加入了对 Google 新模型 Gemini 4 Argon 的支持。该模型通过 Gemini API 向开发者开放,同时也面向每月 100 美元订阅计划的用户。对于习惯用命令行调用大模型的开发者来说,这意味着可以在终端里直接测试 Argon 的能力。
llm-gemini 是 Simon Willison 开发的 LLM 命令行工具的一个插件。LLM 本身是一个用 Python 编写的 CLI 工具,允许开发者在终端中通过统一的接口调用各种大语言模型,并支持将提示词、输出结果存入 SQLite 数据库以便追溯和复用。llm-gemini 则专门负责接入 Google 的 Gemini 系列模型,通过 Gemini API 完成请求。这类插件模式的好处是:当新模型发布时,只需更新对应插件即可获得支持,无需改动主工具。0.35 版本对 Argon 的跟进,正是这种快速迭代能力的体现。
模型能力:SVG 生成仍是强项
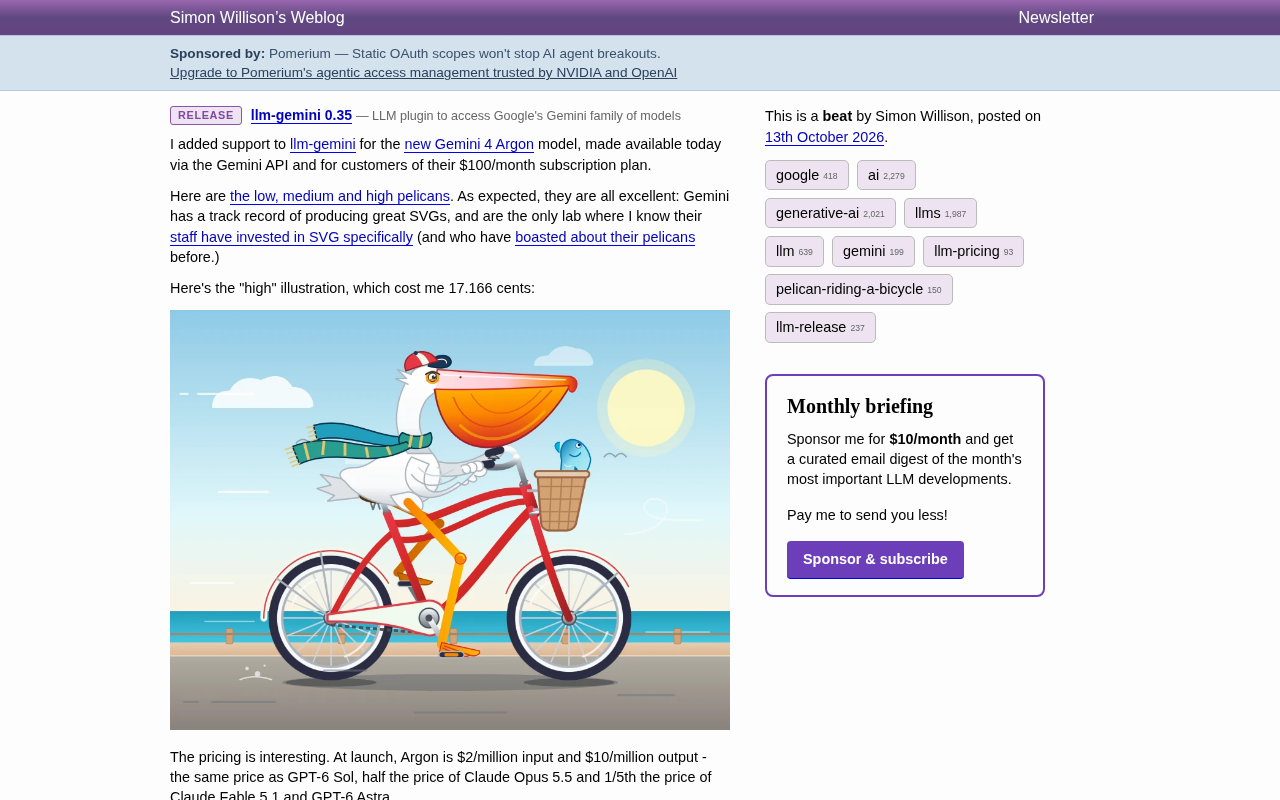
发布者 Simon Willison 照例用“鹈鹕骑自行车”测试了 Gemini 4 Argon 的低、中、高三档输出。结果不出所料,三档表现都相当出色。Gemini 系列在 SVG 生成上一直有良好口碑,也是少数有员工专门投入 SVG 方向研究的实验室,此前还曾公开夸耀过自家模型的鹈鹕图。
Willison 展示的“高”档插图细节丰富:自行车车架准确、车筐里有鱼、围巾时髦、双脚分别踩在踏板两侧,辐条、小帽子、喙和喉囊都到位,还带着一股凶悍的表情。这次生成花费了 17.166 美分。
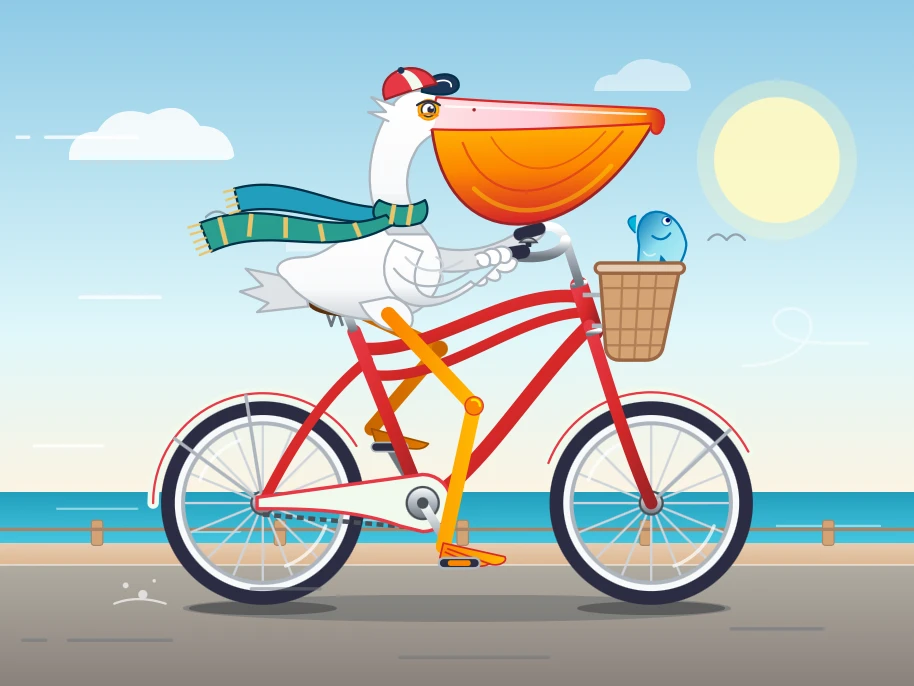
“鹈鹕骑自行车”(pelican riding a bicycle)是 Simon Willison 自 2024 年起用于横向对比各家大模型绘图能力的非正式基准测试。他要求模型生成一幅 SVG 矢量图,内容是一只鹈鹕骑在自行车上。之所以选择这一题目,是因为它同时考验模型对动物解剖结构、机械结构(车架、踏板、辐条)以及两者空间关系的理解与组合能力。SVG 是纯文本的矢量图形格式,便于直接检查生成代码的准确性,因此成为观察模型空间推理与指令遵循能力的直观窗口。
定价策略:先低价后翻倍
Gemini 4 Argon 的定价值得关注。发布时定价为每百万输入 token 2 美元、每百万输出 token 10 美元,与 GPT-6 Sol 持平,是 Claude Opus 5.5 的一半,仅为 Claude Fable 5.1 和 GPT-6 Astra 的五分之一。
但这一价格并非长期有效:12 月 1 日起 Argon 价格将翻倍,届时将与 Opus 5.5 同价。这种“先低价获客、后恢复原价”的策略在当下模型竞争中并不少见,但对需要长期调用 API 的开发者来说,成本规划需要提前考虑。
每百万 token 定价是大模型 API 最常见的计费单位,通常区分输入(input)和输出(output)两个方向,输出价格一般显著高于输入。这里的“token”指模型处理文本时的最小单位,大致对应英文单词的一部分或中文的一个字词。输入 token 指发送给模型的提示词与上下文,输出 token 指模型生成的回复。开发者估算成本时,需要将这两部分分别乘以对应单价再求和。对于智能体类应用,由于会反复携带上下文、多次调用,输入 token 的累积量往往远超单次对话。
实际成本:Artificial Analysis 基准测试数据
单纯比较单价已经不够准确,因为真正决定成本的是模型在智能体框架下完成任务所需的 token 总量。Artificial Analysis 公布的基准测试总成本数据更有参考价值。
在这份数据中,Argon 表现亮眼:运行基准测试总花费 2,407 美元,接近 GLM-5.3,明显低于 OpenAI、Anthropic 和 Meta 的最新模型。即便价格翻倍后,仍比 GPT-6 Astra 略便宜。
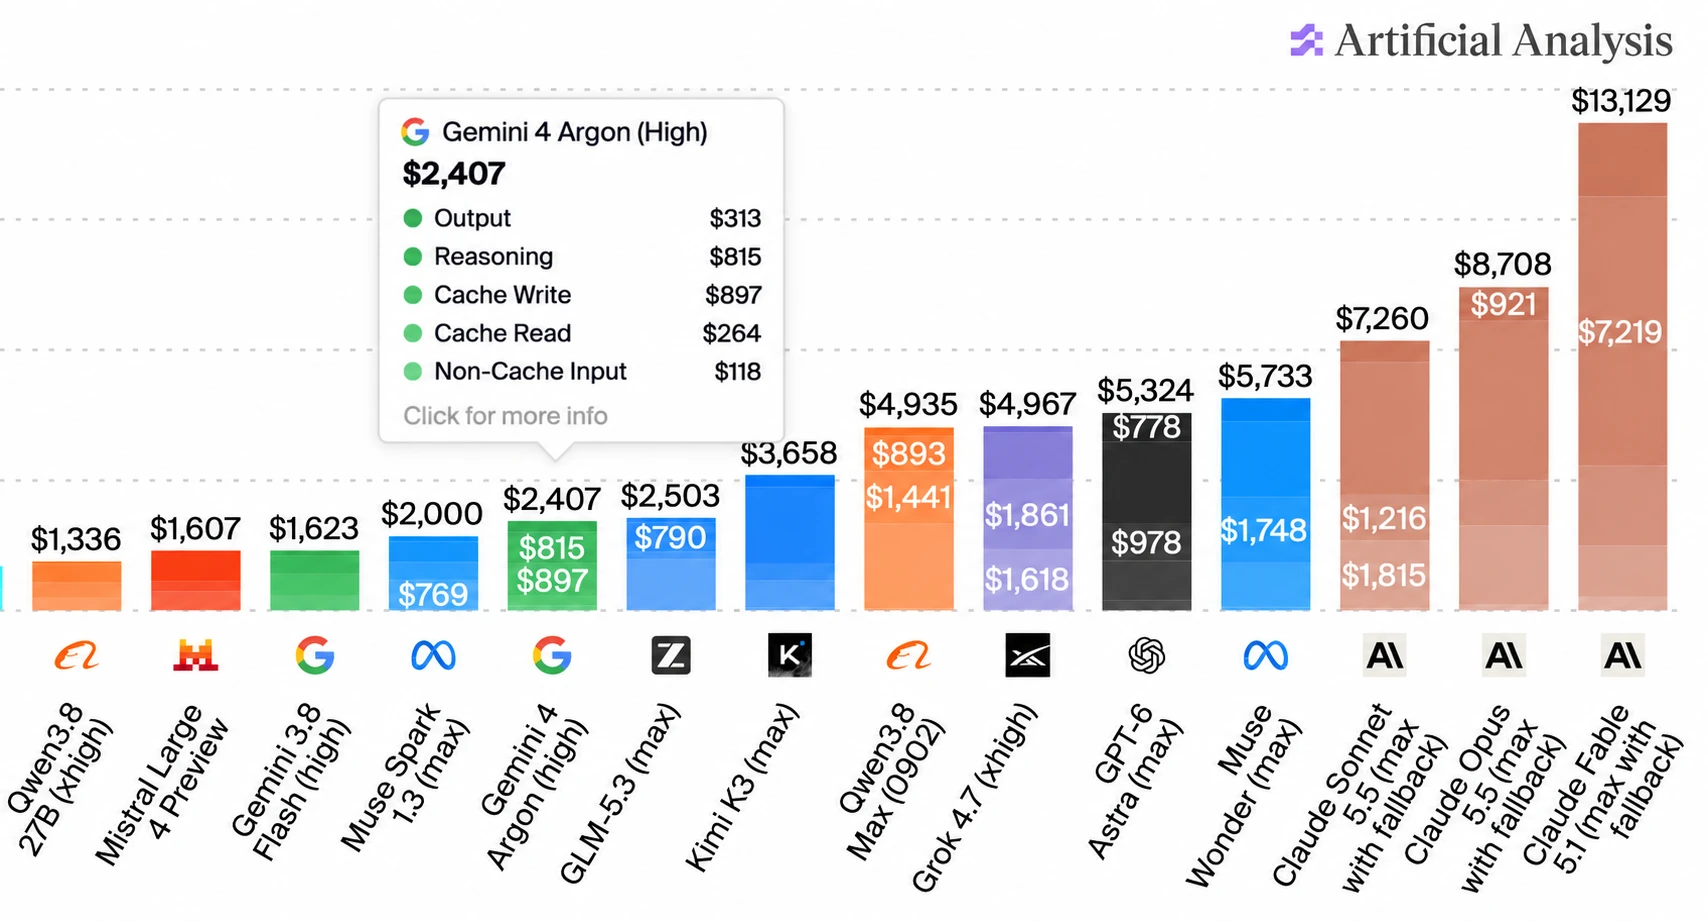
从柱状图看,参与对比的 14 个模型中,Argon 的总成本处于中低区间,其推理成本和缓存写入成本占比较大。这一数据为开发者选择模型提供了更贴近实际使用的参考。
Artificial Analysis 是一家独立的大模型评测机构,其基准测试不仅考察模型回答质量,还系统性地统计完成同一套任务所消耗的 token 数量和对应费用。与单纯比较每百万 token 单价不同,这种评测方式会把模型在智能体(agent)框架下多次调用工具、反复推理所产生的全部 token 计入总成本。因此,一个单价较高的模型如果推理更简洁、更少绕弯路,其实际总花费反而可能更低。这也是文章中强调“真正决定成本的是 token 总量”的原因。
对开发者的意义
llm-gemini 0.35 的快速跟进,让开发者能第一时间在命令行工作流中接入 Gemini 4 Argon。结合 Artificial Analysis 的成本数据和即将到来的涨价节点,当前阶段或许是测试和评估 Argon 性价比的合适时机。对于依赖智能体完成复杂任务的团队,模型的实际 token 消耗效率比单价更值得关注。
总结
Gemini 4 Argon 在 SVG 生成等任务上延续了 Gemini 系列的优势,定价策略则呈现出明显的阶段性特征。llm-gemini 0.35 为开发者提供了便捷的接入方式,而 Artificial Analysis 的成本数据揭示了单价之外的另一种评估视角。
相关推荐

GitHub日报·10月23日:Agent运行时与技能库同日爆发

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。