llm-meta-ai 0.2 发布:Meta 新模型 Muse Wonder 全面解析

Meta 发布 Muse Wonder,性能对标顶尖模型,并提供六档推理级别。
Meta AI 发布新模型 Muse Wonder(及 Full 版本),官方称其为迄今能力最强的模型。Artificial Analysis 评测显示其 Max 模式得分与 GPT-6.1 Sol 同级,Simon Willison 判断它可能属于 Meta 首批“Fable 级”模型。该模型提供 minimal 到 max 六档推理级别,用户可按任务复杂度调配算力。Willison 更新了 llm-meta-ai 插件至 0.2 版以支持新模型,并用“骑自行车的鹈鹕”测试对各档位做可视化对比。结果显示 max 级别下图像完成度较高,但仍有自行车缺横梁等瑕疵;与几周前的 Muse 1.3、1.2 纵向比较,每代都有实质性改进,体现 Meta 约每月一模型的快速迭代节奏。
Meta 推出 Muse Wonder:一次模型能力的实质性跃迁
Meta AI 刚刚发布了 Muse Wonder(以及 Muse Wonder Full),官方称其为"迄今为止能力最强的模型"。这一发布标志着 Meta 在大语言模型赛道上的又一次重要冲刺。
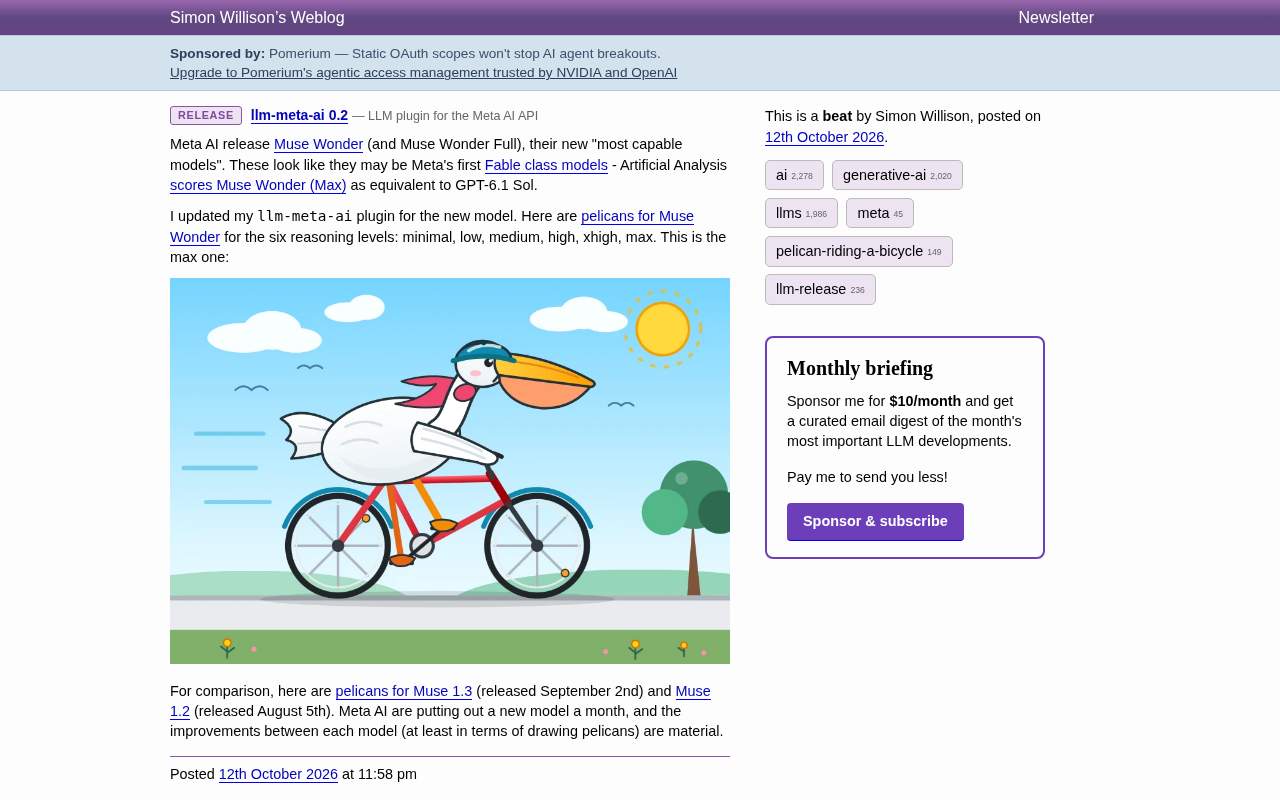
另一边,知名开发者 Simon Willison 迅速更新了他的 llm-meta-ai 插件至 0.2 版本,以支持这一新模型。这个插件让用户能够通过 LLM 命令行工具直接调用 Meta AI 的模型,对于习惯在终端中工作的开发者来说相当实用。
性能对标:与 GPT-6.1 Sol 同级别
根据 Artificial Analysis 的评测数据,Muse Wonder(Max 模式)的得分与 GPT-6.1 Sol 处于同一水平。这是一个值得关注的信号——如果数据可靠,意味着 Meta 的模型能力已经追平了当前顶尖闭源模型的水平。
Simon Willison 在其博客中提出了一个有意思的判断:Muse Wonder 可能属于 Meta 首批"Fable 级"模型。这个分类暗示着模型在推理深度、指令跟随和复杂任务处理上有了质的提升,而不仅仅是参数量的堆砌。
Artificial Analysis 是一家独立第三方 AI 模型评测机构,它通过统一的基准测试套件(涵盖数学推理、代码生成、知识问答等维度)对主流大模型进行横向打分,并给出综合质量指数。相较于厂商自行发布的 benchmark 数据,Artificial Analysis 的评测因其口径一致、样本固定而更受开发者社区信任,常被用作模型选型的参考依据。不过需要注意,任何单一评测机构的分数都只是参考:不同机构的测试集侧重不同,同分并不意味着在所有任务上表现一致,实际部署前仍应结合自身场景做定向验证。
六档推理级别:从 minimal 到 max
Muse Wonder 提供了六个推理级别:minimal、low、medium、high、xhigh 和 max。这种分级设计让用户可以根据任务复杂度灵活调配计算资源——简单问答用低级别即可获得快速响应,复杂推理任务则切换到高级别以获取更深入的分析。
Simon Willison 用他标志性的"骑自行车的鹈鹕"测试对各个级别进行了可视化对比。这种测试方法虽然看起来不太严肃,但实际上能有效检验模型的空间理解、细节遵循和创意生成能力。
推理级别(reasoning effort) 是近两年大模型产品中逐渐普及的一项设计,其底层通常对应“思维链长度”或“测试时计算量(test-time compute)”的调节。模型在回答前会生成一段内部推理过程,级别越高,这段推理允许消耗的 token 越多,模型就有更多机会分步拆解问题、自我检查与回溯。代价是延迟和成本同步上升——max 级别的响应时间可能是 minimal 的数倍,且对简单问题往往没有增益,甚至可能因过度思考而引入偏差。因此这类分级并非“越高越好”,而是让用户按任务难度做性价比取舍,本质上把一部分调度决策从模型内部交还给了使用者。
鹈鹕测试揭示的进步轨迹
在 max 级别下,Muse Wonder 生成的鹈鹕图像展现出了不错的完成度:蓝色骑行头盔、带挡泥板的自行车、合理的背景,以及"还可以"的喙部形状。当然也存在瑕疵——自行车少了一根横梁。
更有说服力的是纵向对比。Simon 将 Muse Wonder 与几周前发布的 Muse 1.3 和 Muse 1.2 的鹈鹕测试结果放在一起比较,发现每次迭代都有"实质性改进"。这种进步速度值得注意。
“骑自行车的鹈鹕”测试 由 Simon Willison 提出并推广,做法是让模型用 SVG 或图像生成方式绘制一只骑自行车的鹈鹕。它之所以能成为非正式基准,是因为这个任务同时考察多项能力:鹈鹕的喙、喉囊、蹼足等解剖特征考验细粒度知识;自行车需要车架、车轮、踏板的空间关系合理(横梁缺失正是常见的空间错误);骑乘姿态则涉及物体交互与创意构图。单一简单提示就能暴露模型在结构一致性和细节遵循上的缺陷,且易于跨模型、跨版本横向对比,因此常被开发者当作快速判断模型能力档位的“土办法”。
每月一模型的迭代节奏
Meta AI 目前保持着大约每月发布一个新模型的节奏。Simon Willison 特别指出,从 Muse 1.2 到 1.3 再到 Muse Wonder,每一代之间的提升都是"material"(实质性的)——至少在绘制鹈鹕这件事上是如此。
这种快速迭代策略反映了当前 AI 模型竞争的激烈程度。厂商们不再满足于年度大版本更新,而是通过高频次的小步快跑持续拉高性能天花板。对于开发者和用户来说,这意味着需要更频繁地重新评估模型选型,同时也意味着能力提升的红利正在加速释放。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。