LLM Wiki+Graph RAG+传统RAG:企业知识库选型与实战
传统RAG、Graph RAG与LLM Wiki互补而非替代,企业应分层取证、按需组合。
文章基于一场技术直播,回答企业知识库该选传统RAG、Graph RAG还是LLM Wiki的问题。结论是三者并非替代关系而是互补:传统RAG擅长条款手册、产品参数等局部事实检索;Graph RAG依托实体关系网络,适合金融、医疗等术语密集、关联复杂的领域;LLM Wiki则把少量资料整理成可复用的业务概念、流程与规则。落地上建议分层取证、按需组合,建立文本仓库、Wiki仓库和图数据库三个仓库,由智能体按查询类型分别检索,并以“双路命中”等机制排序。文章还介绍了三明治架构的流式语音智能体实践,并指出行业面试趋严、代码能力是硬门槛。
企业知识库该选传统RAG、Graph RAG还是LLM Wiki?本文基于技术直播内容,拆解三者互补关系,并给出分层取证、按需组合的落地方法。
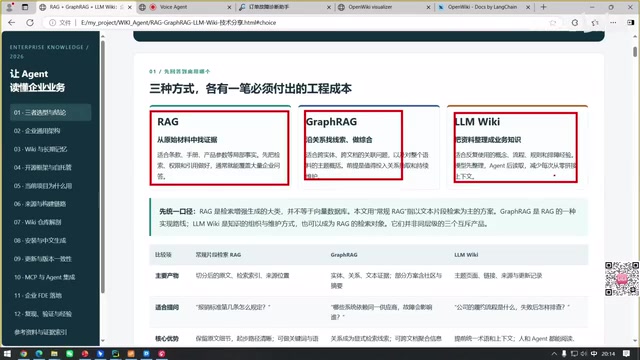
三种知识库方案:不是替代,而是互补
很多企业在构建知识库时,都会面临一个选择题:传统RAG、Graph RAG和LLM Wiki,到底该选哪一个?直播主讲人给出的答案很直接——成年人不做选择,三个都选。但这并不意味着三者可以随意替换,它们之间是相互补充的关系,各自负责一块能力。
具体怎么选,取决于业务需求。可以三个都上,也可以选其中两个或一个。关键是要理解它们各自擅长什么,下面逐一拆解。
传统RAG:定位原文细节的检索利器
传统RAG适合条款手册、产品参数这类局部事实的检索。它的核心作用是从原始材料中找出证据,把检索、权限和引用做好,通常就能覆盖大量企业问答场景。
如果你的企业积累了大量手册、客户操作文档、产品说明书、合同数据等,传统RAG就是性价比最高的选择。它不追求理解复杂关系,而是精准定位原文细节,配合评估和重排机制,满足日常查询需求。
RAG(Retrieval-Augmented Generation,检索增强生成) 是一种将外部知识检索与大模型生成相结合的技术范式。其基本流程是:先将企业文档切分成片段(chunk),通过嵌入模型(embedding model)转换为向量并存入向量数据库;用户提问时,系统将问题同样向量化,在库中做相似度检索,召回最相关的若干片段,再把这些片段作为上下文拼入提示词,交给大模型生成答案。传统RAG的优势在于答案可溯源、可通过引用标注出处,且不需要微调模型即可更新知识。它的局限也很明显:检索以文本片段为单位,难以表达实体之间的多跳关系,对需要跨文档推理的问题效果有限。
Graph RAG:用关系网络串联专业领域
Graph RAG的核心是基于关系去找线索。它特别适合专业术语密集、关联关系复杂的领域,比如银行、金融、物流、医疗等行业。
这些行业里,专业术语之间往往存在复杂的关联关系,比如金融领域的市盈率等指标之间就有业务逻辑上的勾连。把这些实体关系构建成图数据库,智能体就能沿着关系网络找到线索,而不是只做孤立的文本匹配。
如果你的业务需要理解实体之间的关联,Graph RAG就是必要的补充。
知识图谱(Knowledge Graph) 是以“实体—关系—实体”三元组形式组织数据的结构化知识库,可理解为一张语义网络:节点是人物、机构、指标、产品等实体,边是它们之间的业务关系。Graph RAG 在构建阶段通常借助大模型从原始文本中抽取实体与关系,写入图数据库(如 Neo4j、NebulaGraph);查询阶段则把用户问题转化为图查询或子图遍历,沿着关系路径召回证据,再交由大模型组织答案。相比向量检索,图检索擅长多跳推理和关系约束查询,例如“某指标异常会影响哪些下游业务”。代价是图谱构建与维护成本较高,抽取质量直接决定召回效果。
LLM Wiki:把少量资料整理成业务知识
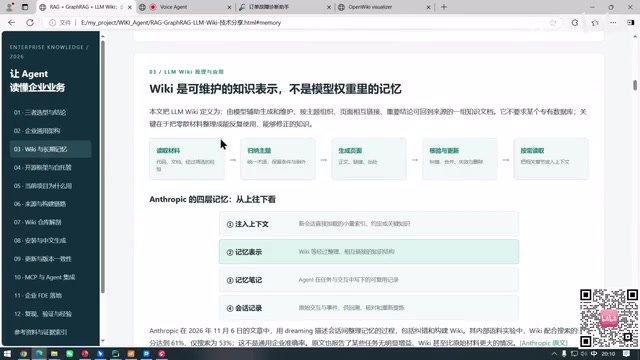
LLM Wiki是相对较新的概念,直播中提到它在2026年4月被提出,6月各厂商才开始全面实现。它擅长把少量资料整理成业务知识,适合反复使用的概念、流程、规则和排障经验。
它的工作方式是:先由大模型帮你做整理,把企业知识做体验化提取,转成Markdown并按目录结构检索,构建完整的证据链;整理完之后,智能体再负责查询读取。
直播中提到的开源项目open wiki,就是完全符合LLM Wiki标准的实现,属于langchain体系下的框架之一(其余三个为deep agent、langchain、langgraph)。
Markdown 目录式检索 是 LLM Wiki 与传统向量检索在组织方式上的关键差异。传统 RAG 把文档切碎后按向量相似度召回,片段之间缺乏结构;LLM Wiki 则先由大模型把资料提炼、改写为结构化的 Markdown 文档,按业务主题建立目录层级,查询时先定位目录与章节,再读取对应内容。这种“先整理、后检索”的方式相当于把知识压缩成更精炼的业务语义单元,适合概念定义、流程步骤、规则约束这类需要整体理解而非片段匹配的内容。由于条目数量通常远少于原始文档,维护和人工审校也更可行,但整理环节依赖大模型的理解质量,需要建立抽检与更新机制。
分层取证,按需组合:企业通用方案
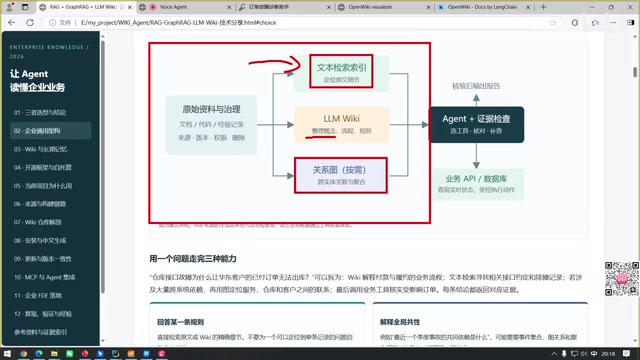
理解了三种方案的特点,落地思路就清晰了:分层取证,按需组合。
具体来说,可以建立三个仓库:第一个是文本仓库,用传统RAG定位原文细节,比如产品手册、合同数据;第二个是Wiki仓库,存放整理好的业务流程、基础概念、安全边界规则,方便智能体查询整体业务逻辑;第三个是图数据库,存放实体之间的关系。智能体根据需求分别检索不同仓库,比如想了解业务线流程就去Wiki仓库,想查具体合同细节就去文本仓库。
直播中展示的多租户知识库中台项目就采用了这种思路。该项目同时使用了向量RAG数据库和Graph RAG图数据库,两个库同时命中时称为“双路命中”,会排在最前面。项目还展示了相关性评分、总耗时、知识图谱调用次数、大模型调用次数、输入输出token和成本等评估数据,以及向量检索和图谱检索的召回情况。
语音智能体:三明治架构的工程实践
除了知识库,直播还演示了一个可落地的语音智能体项目,采用三明治架构,实现了流式输入和流式输出。
实际操作中,用户按住按钮说话,松开后停止监听。语音识别不是等整句话说完才开始,而是在说话过程中就实时进行;回答一出来就开始语音播报,不需要等全部结果生成完毕。这种流式处理让响应速度达到毫秒级别,是目前真正能在企业落地的语音智能体方案。
演示中查询天气时,智能体返回了长沙晴、气温11到14度、北风微风等信息,并提示后续几天有小雨、最低降到两度左右,建议查看最新天气。这个项目展示了语音识别、大模型理解和语音播报的完整链路。
面试变卷,代码能力是硬门槛
直播最后提到当前智能体行业的现状:外面一片哀嚎,找大模型相关工作很累很卷。卷的意思是面试要求变高了。老师不懂代码怎么办?答案很直接——必须看代码。
这也呼应了整场直播的定位:从入门到实战,手把手带你做企业级代码知识与排障Agent。光理解概念不够,能把项目跑起来、看懂日志、调通链路,才是企业真正需要的能力。
相关推荐

Genie 4世界模型上手:像木偶师一样实时导演世界
Google DeepMind 世界模型 Genie 4 深度解析:Special Guest X 实测展示如何用提示词实时导演场景、通过 Project Genie 构建自定义交互应用,以及提示词即种子的可复现设计。

黄仁勋若卸任,英伟达AI帝国将何去何从?
英伟达的AI霸权是否过度依赖黄仁勋个人?本文分析硅谷对CEO的个人崇拜现象,探讨英伟达技术护城河与组织风险,以及AI产业为何需要摆脱救世主叙事。

2026科技诉讼风向标:立法者欲收紧AI与平台责任
2026年科技诉讼成为焦点:美国参议院司法小组委员会听证会推动限制在线平台强制仲裁,并加强对深度伪造创作者的追责,科技平台与AI工具面临责任重构。