LLM本质:逐词预测如何写出代码

LLM本质是逐词预测程序,通过循环续写文本完成写代码等任务。
文章用Python函数补全的例子解释LLM的核心机制:它读取已有文本,为每个可能的续写打分,选一个追加,循环往复。虽然只做“预测下一个词”,但为了预测准确,模型在预训练中掌握了语法、常识和代码写法。Anthropic的研究还发现,模型内部会提前规划韵脚、并行估算加法,说明逐词输出背后有更复杂的内部策略。预训练之后还有助手训练,使模型从续写文本变为遵循指令的助手。对使用者而言,这意味着提供清晰上下文至关重要,且模型输出的是最可能而非核实过的内容,代码应先运行再依赖。
你每天都在用AI写代码,但有没有想过:对面那个大语言模型(LLM)到底是什么?
简短的回答是:它是一个不断添加下一个词的程序。它读取已有文本,算出最可能的下一个词,添加进去,然后重复。整个工作就是这样,但这足以写代码、回答问题、修bug。本文用一段Python代码,带你走完这个循环。
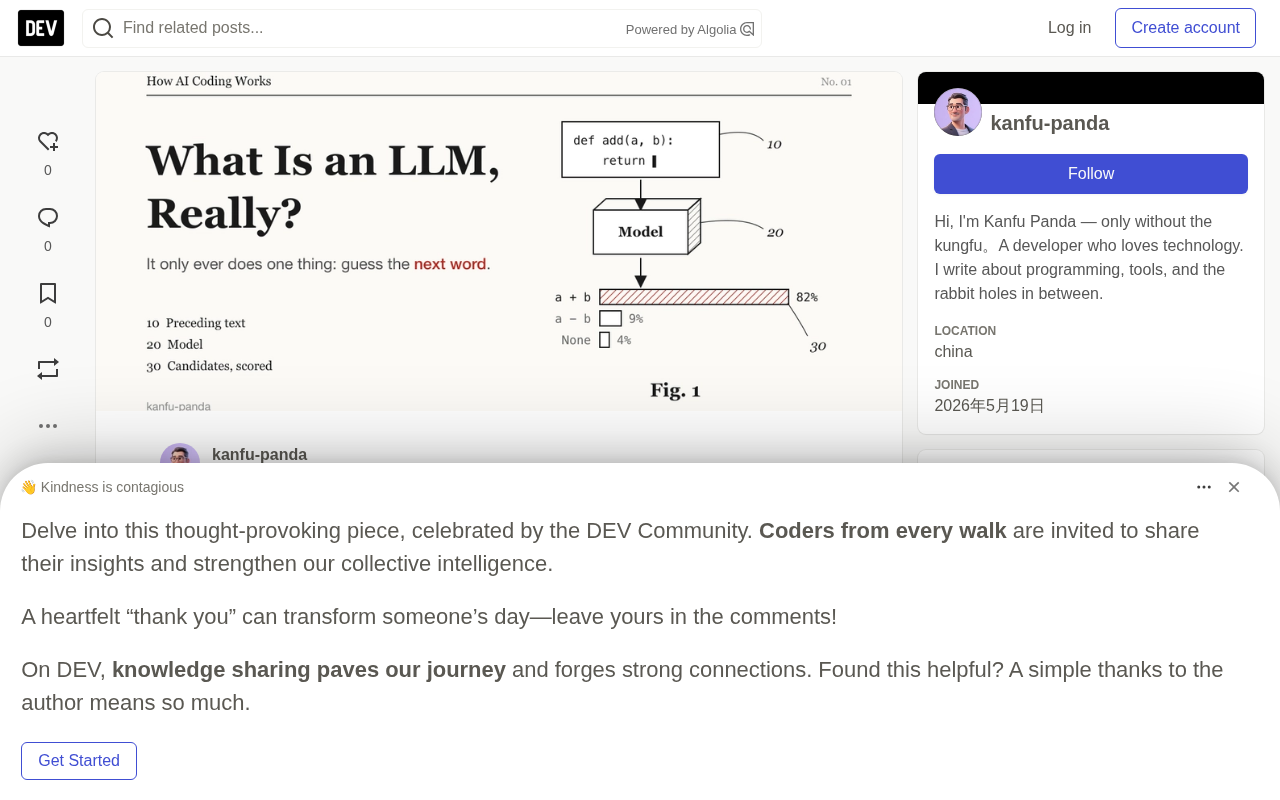
每一步到底在做什么?
看一段写了一半的Python代码,光标停在return后面:
def add(a, b):
    return
接下来是什么?如果你写代码,几乎不用想:a + b。函数叫add,参数是a和b,a + b是自然的选择。
LLM做的是同一件事。它读取光标前的所有文本,给每一个可能的续写打分:a + b得分高,a - b低一些,None更低。然后它选一个,加上去。Anthropic的官方术语表也是这么说的:Claude背后的模型被训练成根据前面的文本预测下一个词。
一个词如何变成整个函数?
一个词本身走不了多远。诀窍在于循环:模型把刚预测的词追加到文本末尾,再用变长的文本预测下一个词。
加上a之后,文本以return a结尾,最可能的下一个片段是+。加上+,它预测b。之后它判断函数写完了,就停下来。整个函数、整个回答,都是这样逐词构建的。你在聊天窗口看到的“打字效果”,就是这个循环在推进。严格来说,每次预测的单位不一定是完整的词,可能是词的一部分或一个符号,这个单位叫token。为了简单,原文统一说“词”。
Token是语言模型处理文本的基本单位,它不完全等同于“词”。一个token可以是一个完整的英文单词、词的一部分(如“un-”或“-ing”)、一个标点符号,或者一个汉字。不同模型使用不同的分词器(tokenizer),例如GPT系列常用BPE(字节对编码)算法,将常见词保留为整体,生僻词拆成子词。模型实际输出的是下一个token的概率分布,而非直接输出“下一个词”。这种设计让模型能处理任意文本,包括代码中的符号和缩进,同时控制词表大小在数万级别。理解token的存在,有助于解释为什么模型有时会“拼错”单词或在代码缩进上出错——它看到的是token序列,而不是人类眼中的字符流。
只预测下一个词,凭什么能写代码?
你可能会想:这不就是手机键盘的自动补全吗?
区别在于猜测需要多准。要在return后面预测出a + b,模型必须知道add意味着加法,以及Python函数怎么写。在更长的代码里,它还得记住前面定义了哪些变量、每个函数做什么。
训练期间,LLM读了海量文本和代码。要把下一个词预测好,唯一的办法就是顺带掌握其中的模式:语法、常识、代码写法。乔治城大学的研究中心CSET也这么解释:像预测下一个词这样简单的任务,会推动模型形成对语言的广泛理解,而这种理解能迁移到许多其他任务上。
还有更令人意外的事:模型并不是纯粹一步一步工作的。2025年,Anthropic发表了一项研究,深入Claude内部看它如何“思考”,其中两个发现值得注意。
第一个关于写诗。研究者让它写一个押韵对句,开头是“He saw a carrot and had to grab it”。如果它真的只一次预测一个词,你会预期它在第二行末尾才去找韵脚。但事实是,在写第二行之前,它已经定好了以“rabbit”结尾,然后朝着这个目标写:“His hunger was like a starving rabbit.”
第二个关于加法。问它36加59等于多少,它说95。问它怎么算的,它描述学校里的方法:先加个位,再进位。但研究者观察内部实际发生的事,发现它同时跑了两条路径,一条估算答案的大致规模,另一条精确算出最后一位数字。模型自己并不知道自己是这样工作的。
把这两点放在一起,图景就清晰了:逐词写作是模型外在的工作方式;为了预测得准,它在内部发展出了自己的方法。这些方法不是谁一行行写进去的,而是模型在训练中学会的,连开发它的公司都需要专门研究才能看见。
预训练(pre-training)是LLM训练的第一阶段:模型在海量无标注文本上反复练习“预测下一个token”,通过梯度下降调整数十亿甚至数千亿参数。这一阶段计算成本极高,通常需要数千块GPU训练数周。预训练完成后,模型具备了广泛的语言能力和世界知识,但还不知道如何“当助手”。接下来的助手训练通常包括监督微调(SFT,用人工标注的问答对教模型模仿有用回答)和基于人类反馈的强化学习(RLHF,用人类偏好奖励模型引导模型生成更符合期望的输出)。Anthropic对Claude的训练也包括类似的“有用、诚实、无害”对齐过程。正是这一阶段让模型从“续写文本”转向“遵循指令”,也是不同厂商模型行为差异的重要来源。
为什么它像助手一样听从指令?
到目前为止描述的培训——读海量文本、练习预测下一个词——叫预训练。只经过预训练的模型擅长续写文本,但不擅长回答问题或遵循指令。Anthropic的术语表直接这么讲。
所以之后还有一轮训练,教模型成为助手:理解你的问题、恰当回答、拒绝不该做的事。我们日常用的Claude经过了这一轮。用术语表的话说,Claude不是一个裸的语言模型,它已经被训练成有用的助手。这一轮训练如何运作是另一个话题,也是本系列的下一篇。
上下文窗口(context window)指模型在一次推理中能读取的最大token数量,包括你的问题、粘贴的代码、对话历史以及系统指令。现代模型的上下文窗口从数万到数十万token不等,相当于几十页到几百页文本。模型在生成每个token时,只能“看到”窗口内的内容,窗口之外的文本不会被考虑。因此,把相关代码、错误信息和明确指令放在窗口内,是提高输出质量的关键。另外,模型生成每个token时是独立采样或取概率最高的token(取决于温度参数),它没有“回头修改”已生成内容的机制,这也是为什么它可能生成看似合理但实际错误的代码——它只是在延续最可能的token序列,而不是在运行或验证程序。
用AI写代码时,这意味着什么?
知道模型是在续写文本后,两件事立刻变得有用。
第一,你给它的一切都是它要续写的文本的一部分。你的问题、粘贴的代码、项目里的指令文件:它全部读取,然后从那里开始写。这段文本越清晰,它越容易正确地续写。比较“给我写个函数”和“写一个名为add的Python函数,接收两个整数并返回它们的和”,后者留给猜测的空间小得多。
第二,它写的是“最可能接下来出现的东西”,而不是它去核实过的内容。大多数时候,最可能的答案也是正确的。但偶尔它会生成一个看起来完全合理、实际上不存在的函数名或参数。所以在依赖之前,先运行代码、读一读。
Codex或DeepSeek也一样吗?
是的。Codex运行在OpenAI的模型上,DeepSeek广告运行在DeepSeek自己训练的模型上。它们都是LLM,都通过逐词续写文本工作。不同的是训练时读了什么、之后如何被训练成助手,以及包裹它们的工具替它们做了什么。无论你用哪个工具,上面两条习惯都适用。
小结
- LLM是一个不断添加下一个词的程序:读取已有文本,选出最可能的下一个词,重复。
- 为了预测得准,它在训练中掌握了语法、常识和代码写法,甚至能提前规划。
- 你给它的一切都会成为它续写的文本,越清晰结果越好;使用前检查它写的代码。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。