LLM代理实测:200重复请求变1次,却发现30秒性能Bug

开源Rust LLM代理基准测试:去重亮眼但真实流量仅省1.5%,并暴露串行Bug。
文章对开源Rust LLM代理tokio-prompt-orchestrator进行了真实基准测试。代理在200个相同请求下将上游调用合并为1次且延迟不变,但回放WildChat真实流量发现精确去重仅节省1.5%,重复主要来自同一用户重试和脚本化请求。熔断器在供应商宕机时将无效调用从89次降至5次,但默认拒绝响应仍被SDK重试,2.0.3版本通过x-should-retry头修复。挂起测试表明熔断器速度受超时设置制约,2.0.3将超时计为失败并增加--timeout参数。测试还暴露了20个不同提示词串行处理耗时30.2秒的Bug,2.0.3引入默认16并发worker池后降至3.0秒。文章最后给出设置真实超时、合并在途调用、用不同提示词压测等可操作建议。
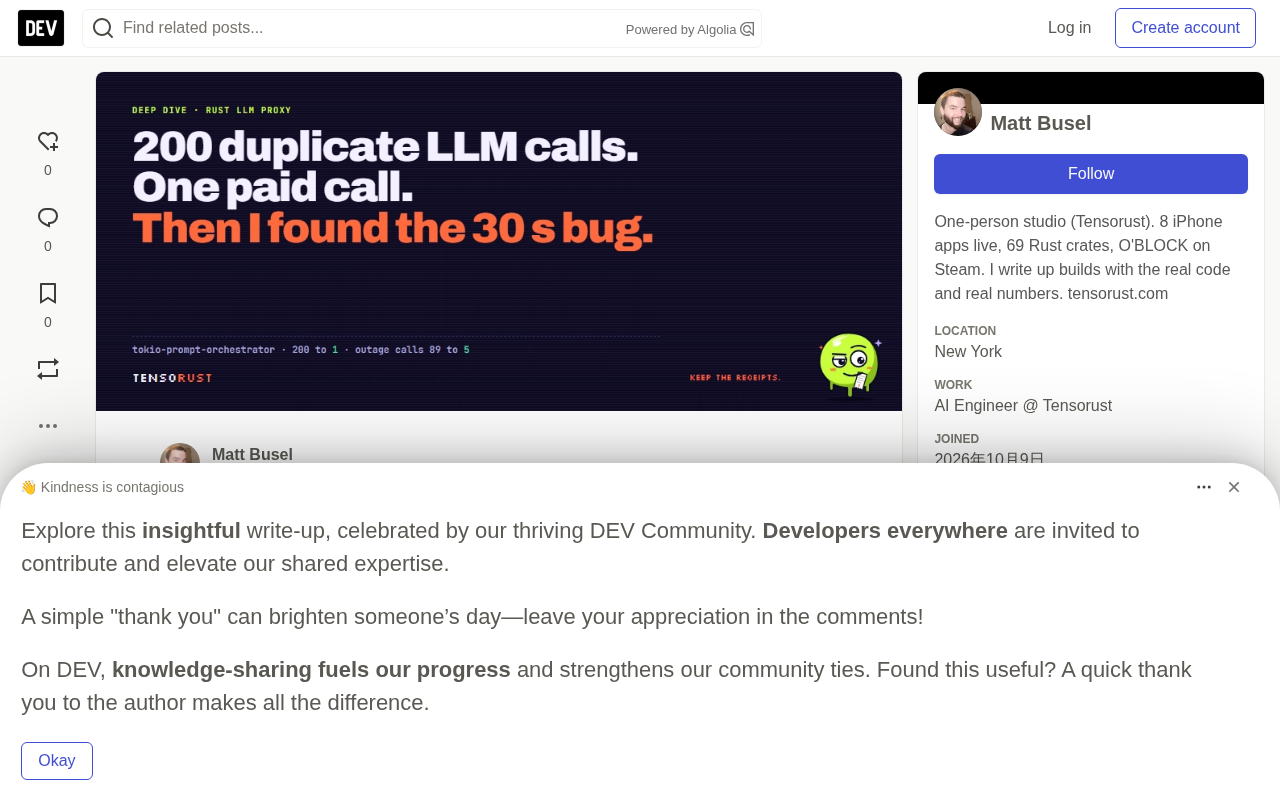
一个开源Rust LLM代理在基准测试中展现了惊人的去重能力:200个相同请求合并为1次上游调用。但同一场测试也暴露了一个作者自己都没发现的严重Bug——服务器串行处理导致20个不同请求耗时30秒,而非预期的1.5秒。
什么是LLM代理,它解决什么问题
LLM代理是位于应用与模型API之间的小型服务器。客户端代码无需改动,只需更改base URL,代理便能合并相同请求、熔断故障供应商、限制支出并记录每次调用。
这个名为tokio-prompt-orchestrator的开源项目采用MIT协议,由作者Mattbusel开发。他在2026年10月进行了一轮真实基准测试,将官方OpenAI SDK置于代理与模拟供应商之间,测量代理的实际表现。
测试的设置很巧妙:同一个SDK、同一份应用代码,唯一的变化是base URL指向直连供应商或指向代理。供应商是一个60行的Node服务器,能说OpenAI和llama.cpp两种格式,支持503和挂起两种故障模式,并精确统计每次到达的调用——这正是供应商向你收费的数字。
测试一:200个相同请求变成1次付费调用
这是代理最亮眼的场景:同一提示词同时发起200次请求。真实世界中,这可能是热门页面的缓存未命中、消息队列重复消费、用户疯狂点击按钮,或者代理框架在慢调用时重试。
直连结果:200次请求产生200次上游调用。
通过代理:仅1次上游调用。 响应头清晰记录了每个请求的命运——1个miss(发起调用),199个joined(等待并共享结果)。最慢响应仍是1.58秒,合并没有带来额外延迟。
代码中有两个值得借鉴的细节。第一,去重键是整个扁平化对话的哈希,而非仅最后一条消息,这样不同聊天中输入相同文字的用户不会共享答案。第二,上游调用在独立的spawn任务中运行——如果第一个调用者挂断,加入的199个请求仍能获得结果。没有这个设计,一个不耐烦的客户端会取消所有人的调用。Go程序员会认出这是singleflight模式。
已完成答案在默认300秒窗口内可复用,存储在带大小限制的moka缓存中,防止内存无限增长。
singleflight 模式:文章提到 Go 程序员会认出这是 singleflight 模式,它指的是在同一时刻将多个对同一 key 的并发请求合并为一次实际执行,其余调用者等待并共享结果的并发原语。核心价值在于消除“惊群”式的重复工作:当缓存未命中或下游服务缓慢时,大量相同请求会同时涌向昂贵资源。实现上通常维护一个 key 到“进行中调用”的映射,首个调用者创建并执行任务,后续调用者挂到该任务上等待;任务完成后立即删除映射,避免缓存陈旧结果。与普通缓存不同,singleflight 只合并在途请求,不改变请求本身的语义,且未命中时几乎零开销。文章中的代理正是用完整对话哈希作为 key,并让上游调用在独立任务中运行,从而保证首个调用者断开后其余请求仍能拿到结果。
真实流量中去重只节省1.5%
但压测是最好情况。作者回放了Allen人工智能研究所的WildChat-1M公开数据集——真实用户与免费ChatGPT前端的对话日志。他取了第一个parquet分片:59,857个对话、172,418个用户轮次、25.3天的流量。
在默认5分钟窗口下,172,418次调用中仅有2,568次(1.49%)是精确重复。窗口拉到24小时也只有4.39%,完整25天仅4.77%。
细分数据更有意思:5分钟内,91%的重复来自同一用户(相同哈希IP)再次发送相同内容——刷新、重新提交、“没回答让我再试一次”。重复最多的请求甚至不是人类:2023年AutoGPT使用的系统提示词(以“CONSTRAINTS: 1. ~4000 word limit...”开头)在5分钟窗口内重复了76次,还有脚本化的填空测试提示词。重复真正集中在代理循环和脚本化请求中。
所以规则是:去重应该默认开启(未命中时零成本),但真正的节省只在机器发送请求的场景出现。若需要处理改写问题的场景,那是语义去重,一个更困难的问题。
测试二:供应商宕机时熔断器拦截94%的无效调用
每2秒一个不同提示词(去重无法帮忙),持续150秒。供应商前15秒健康,15到75秒返回503,然后恢复。
直连:60秒内向已死供应商发了89次调用。 这是30个请求各重试3次——SDK对每个5xx自动重试两次。你的应用在供应商已经摇摇欲坠时把负载翻了三倍。这正是AWS Builders' Library中关于重试的警告:重试对小故障有帮助,对真实宕机则是火上浇油。
通过代理:仅5次调用。 连续5次失败后熔断器打开,后续请求在代理内部被拒绝,完全不触碰供应商。对故障API的调用减少了94%,且无需任何配置。
熔断器是Martin Fowler在2014年描述的经典模式:关闭(调用通过)、打开(拒绝调用)、半开(放行测试恢复)。默认配置为连续5次失败触发,80%近期成功率关闭,60秒后半开探测。
但有两个诚实的注意事项。第一,用户等待错误的时间一样长:两种方式都约1.3秒。代理立即拒绝,但SDK看到503后仍按0.5秒和1秒的退避重试两次。代理在熔断拒绝时未发送x-should-retry: false或Retry-After头——OpenAI SDK其实会遵守这个头。这是个一行修复。
2.0.3版本已修复:熔断拒绝现在携带x-should-retry: false和Retry-After,拒绝请求约1毫秒返回而非1.35秒,p95从1459毫秒降至314毫秒。
第二,恢复有滞后。熔断器在第18.6秒打开,直到最后一次失败后60秒才再次查看,导致78.8秒才恢复流量。供应商75秒已恢复健康,但76秒的请求仍收到503。这是权衡:减少对病态API的调用,代价是更慢回到健康状态。
熔断器模式:文章多次提到熔断器,这里补充其状态机与设计要点。熔断器通常有三种状态:关闭(closed)时请求正常通过,同时统计失败率;当连续失败次数或失败比例超过阈值,进入打开(open)状态,所有请求被立即拒绝而不触碰下游;经过一段冷却时间后进入半开(half-open)状态,放行少量探测请求,若成功则回到关闭,若失败则重新打开。与单纯重试不同,熔断器旨在快速失败、保护已经过载的下游,并给其恢复时间。关键参数包括触发阈值、冷却时长和半开探测数量。文章中的默认配置为连续 5 次失败触发、60 秒后半开,这解释了为何恢复存在滞后:冷却期内即使供应商已恢复,请求仍会被拒绝,这是用可用性换取对病态依赖的保护。
测试三:挂起的供应商考验超时设置
更隐蔽的故障是供应商接受连接但永不响应。同样的负载,但这次供应商挂起。
没有一方快速失败。直连的p95等待为53.7秒,宕机期间第一个请求等了59.7秒,直到供应商在75秒丢弃卡住的连接、SDK重试才通过。若供应商永不丢弃,SDK默认10分钟超时会让每个请求挂10分钟、重试3次。
通过代理p95为53.6秒,基本相同。 只有2次调用到达挂起的供应商(直连为30次),但熔断器从未打开——llama.cpp worker 30秒超时,熔断器需要5次失败,即150秒挂起才触发,宕机在触发前已结束。
2.0.3增加了--timeout参数并将超时计为熔断失败。 之前pipeline的超时包裹了熔断调用,被pipeline取消的挂起调用根本不算失败。使用--timeout 5后,熔断器在挂起约13秒时打开,最慢等待从66.3秒降至11.4秒,挂起期间请求的中位等待从34.9秒降至1毫秒。代价是这些请求快速失败并返回503而非一分钟后成功——这正是熔断器的意义。
最实用的教训:熔断器的速度不能超过你的超时设置。 30秒超时下的5次失败意味着2.5分钟挂起后才起作用。如果你的模型通常5秒响应,把超时设在实际p99附近(比如15到20秒),而非默认的30秒、120秒或10分钟。
p95 延迟与超时设置:文章反复用 p95 衡量等待时间,p95 指 95% 的请求完成时间不超过该值,属于尾延迟指标。相比平均值,p95 更能暴露少数极慢请求对用户体验的影响。超时设置应与实际延迟分布匹配:若模型正常 p99 在 15 到 20 秒,超时设在 20 秒左右能在挂起时快速失败,又不会误杀正常慢请求。SDK 默认超时往往长达 10 分钟,对交互式应用不可接受。文章强调“熔断器的速度不能超过超时设置”,因为熔断器依赖失败计数,而挂起请求只有在超时后才会被计为失败;超时越长,达到触发阈值所需的总挂起时间越长。把超时计为熔断失败,并缩短超时,才能让熔断器在供应商挂起时及时打开。
发现的Bug:一次只发一个上游调用
为检查并发,作者同时发送20个不同提示词,供应商每次耗时1.5秒。去重帮不上忙,纯粹考吞吐。
直连:每个答案1.5秒。通过代理:阶梯式上升,1.5秒、3.0秒、4.5秒……直到30.2秒。 代理做了同样的20次调用,但严格串行。服务器二进制将每个上游调用序列化。
2.0.3已修复:服务器现在同时运行最多16个上游调用(--concurrency),同样20个不同提示词在默认设置下3.0秒完成,--concurrency 32时1.5秒——与直连相同。相同提示词仍共享一次调用:200请求的群体仍是1次上游调用。
原因在src/stages.rs。推理阶段是一个Tokio任务,从channel取出请求后await模型才取下一个。库其实已有修复方案spawn_pipeline_with_config,运行一个worker池共享channel,由inference_workers决定大小。但它为向后兼容默认为1,而orchestrator服务器二进制走的是更简单的spawn_pipeline_with,始终单worker。README中的演示(12请求、3次模型调用)从未捕捉到这个问题,因为它是为展示去重而建,而去重恰好掩盖了问题。
这是对自己代码做基准测试最刺痛也最有价值的部分:去重和熔断的数字符合预期,阶梯图不然——那是任何陌生人在第一小时就会撞上的问题。
Tokio 任务与 worker 池:文章指出推理阶段是一个 Tokio 任务,从 channel 取出请求后 await 模型才取下一个,导致串行。Tokio 是 Rust 的异步运行时,任务(task)是由运行时调度的轻量级并发单元,await 表示当前任务让出执行权等待 I/O,但若单个任务内部顺序地 await 每个上游调用,整体吞吐仍受限于该任务的串行循环。要并发处理多个请求,需要多个任务共享同一个 channel,即 worker 池:每个 worker 独立地从 channel 取请求并 await,从而同时推进多个上游调用。文章提到的 spawn_pipeline_with_config 正是启动一个由 inference_workers 决定大小的 worker 池,而服务器二进制误用了单 worker 的简化入口,造成 20 个不同提示词阶梯式串行。修复后默认 16 个 worker,使吞吐恢复到与直连相当。
给你的项目的可操作建议
大部分改进不需要作者的crate。任何调用LLM API的应用都应按收益顺序做这些事:
-
设置真实超时。 SDK默认10分钟。测量你所用模型的p99延迟并略高于它。Node中:
new OpenAI({ timeout: 20_000 });Python中:OpenAI(timeout=20.0)。这一个设置决定宕机让用户等20秒还是10分钟。 -
了解重试在宕机时的行为。 2次重试意味着对挣扎中的供应商施加3倍负载。保留重试应对小故障,但前面放个能察觉真实宕机并停止调用的东西(熔断器),并让它在拒绝时说“别重试”。
-
合并相同的在途调用。 如果系统中任何东西能同时发送同一请求(队列、代理、重试、定时任务、缓存未命中),一个基于完整对话哈希的singleflight map就能把N次调用变成1次。多数语言30行代码,未命中时零成本。
-
别指望缓存把聊天账单减半。 真实聊天流量中精确重复仅1.5%。把精力花在供应商端的提示词缓存、简单调用用更小模型、更短的提示词上。
-
用不同提示词压测你的代理,而非相同提示词。 相同提示词的测试会美化任何带有去重的代理。作者自己的演示就这么做了,并掩盖了20倍减速。
如需现成方案:cargo install --locked tokio-prompt-orchestrator --features web-api,tantivy(获取2.0.3修复版),然后用OPENAI_BASE_URL=http://127.0.0.1:8080/v1指向它。它支持OpenAI和Anthropic API,官方SDK无需改动即可工作。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。