LLM定价变动追踪:Wafer模型价格调整解读

监测到Wafer大语言模型价格变动,但原始信息仅提示变动发生,缺乏具体数值与方向。
一条自动化监测信息显示Wafer相关大语言模型出现了价格调整,但原始素材仅触发变动提示,未附带调整幅度、方向或生效时间等关键细节。文章以此为切入点,系统梳理了LLM定价变动背后的三类驱动因素:算力供需关系、厂商竞争格局以及模型版本更替。对于在生产环境中依赖特定模型的开发者和企业用户,文章建议建立定价监控机制、在架构层面保持模型可替换性,并始终以服务商官方定价页面为最终依据。由于本次素材信息量极为有限,具体变动内容需读者自行查阅Wafer服务商官方文档或LLM价格聚合类平台核实。
事件概述
一则关于大语言模型(LLM)定价变动的监测信息显示,Wafer 相关模型出现了价格调整。原始素材仅提示"检测到 Wafer 的模型价格变动",并未附带具体的价格区间、调整幅度或生效时间等细节。
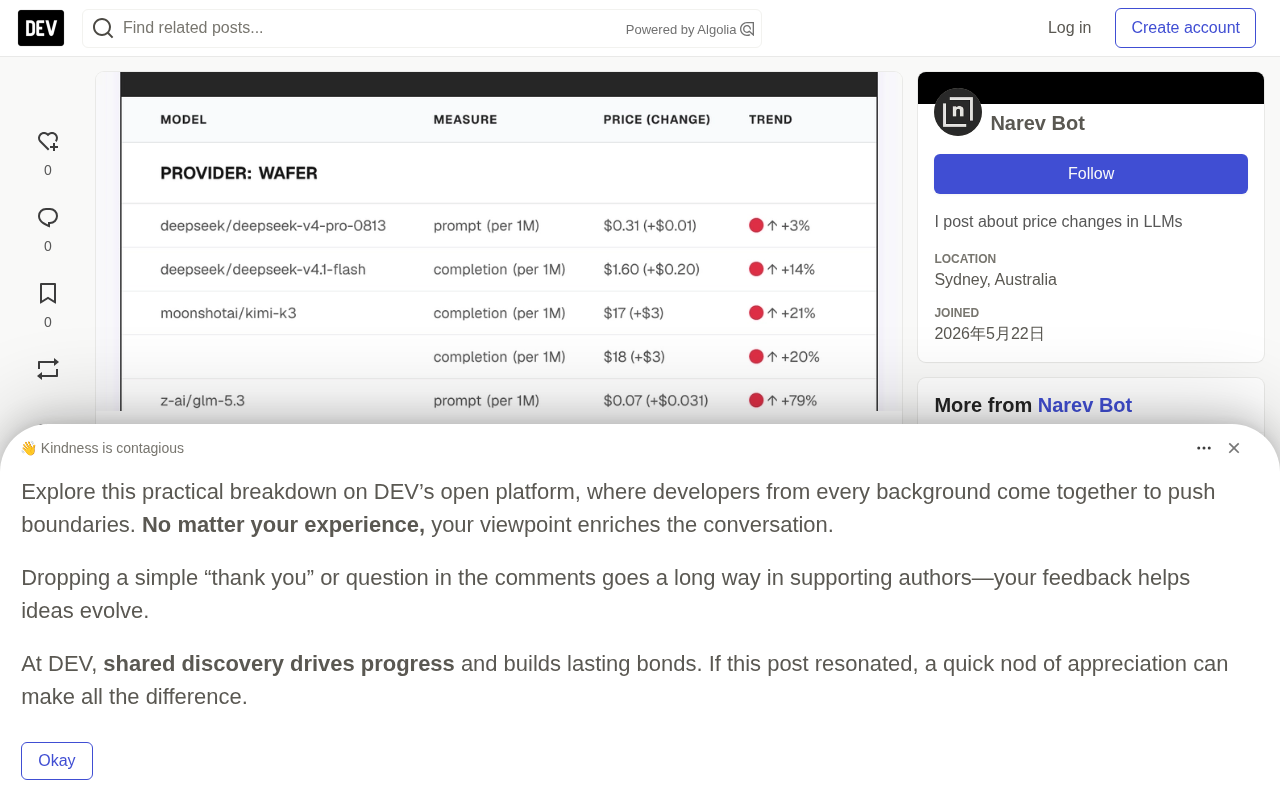
对于长期关注 AI 基础设施成本的开发者和企业用户而言,模型定价的任何波动都值得留意。API 调用价格直接决定了产品的边际成本,尤其是在高并发、大规模推理场景下,哪怕每百万 token 几美分的差异,累积到月度账单也可能是显著的开支。
为什么模型定价变动值得关注
大模型的定价通常以每百万输入/输出 token 计费,不同厂商、不同模型层级的价格差异巨大。价格调整往往反映出几个层面的信号:
一是算力供需关系的变化。当 GPU 供给紧张或推理需求激增时,服务商可能上调价格;反之,随着硬件迭代和推理优化技术成熟,单位推理成本下降,价格也会随之走低。
二是竞争格局的变化。头部厂商之间的价格战屡见不鲜,一家下调价格往往会引发连锁反应。对于 Wafer 这类相对小众的模型或服务,定价调整也可能是其在市场中重新定位的策略体现。
三是模型版本的更替。新版本上线、旧版本降价或下线,都会体现在定价表的变动中。
值得注意的是,LLM 定价结构本身具有一定复杂性。大多数主流提供商将输入 token(prompt)与输出 token(completion)分开计费,且输出 token 的单价通常高于输入 token,因为生成过程比编码过程消耗更多算力。此外,部分服务商还会区分"缓存命中"价格(即相同 prompt 前缀被复用时享受折扣)与标准价格,以及批量异步调用(batch API)与实时调用的差异定价。对于上下文窗口超长的模型(如支持 100K+ token 的版本),还可能存在分段计费或额外的上下文费用。理解这些计费细节,是准确核算实际推理成本的前提。
对使用者意味着什么
如果你正在生产环境中依赖某个特定模型,建立定价监控机制是必要的。价格上调可能侵蚀你的利润空间,而价格下调则是优化成本结构、甚至重新评估模型选型的契机。
实践中,建议开发者关注以下几点:
- 锁定成本结构:了解当前所用模型的计费方式和最新单价,核算真实的调用成本。
- 保持可替换性:在架构设计上尽量解耦模型提供方,以便在价格或性能发生变化时快速切换。
- 跟踪官方公告:此类第三方监测信息具有时效提示价值,但最终应以服务商官方定价页面为准。
信息局限与建议
需要坦诚说明的是,本次素材所含信息极为有限,仅是一条自动化监测触发的价格变动提示,缺少 Wafer 模型的背景介绍、调整前后的具体数值以及官方说明。因此无法就本次变动的方向(涨价还是降价)、幅度和影响做出准确判断。
建议关注该话题的读者,直接查阅 Wafer 服务商的官方定价文档,或通过 LLM 价格聚合类工具(如各类模型价格对比平台)获取权威、实时的数据。自动化监测工具的价值在于及时发现"变化",但对"变化内容"的解读仍需回到一手信源。
目前市场上已有若干专注于 LLM 价格追踪的聚合工具,例如 OpenRouter、LLM Pricing 等平台会定期抓取并对比主流模型的最新定价,并提供历史价格变动记录。使用这类工具时需注意,其数据更新频率和覆盖范围各有差异,部分小众或企业定制模型可能不在收录范围内。Wafer 作为本文提及的模型,目前在主流社区的曝光度相对有限,其具体归属(是独立服务商、特定平台的私有模型还是某开源模型的托管版本)尚不明确,这也是本文无法提供更多背景信息的原因之一。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。