LLM定价调整追踪:Inceptron、OpenInference等四家服务商变动

四家LLM服务商出现定价变动,提示开发者需将推理成本纳入持续监测与多供应商策略。
近期监测数据显示,Inceptron、OpenInference、Relace、Wafer四家大语言模型服务商发生了价格调整,但原始披露未给出具体涨跌幅度。文章以此为切入点,分析了模型定价波动背后的驱动因素——包括GPU算力成本、模型优化技术进步和市场竞争格局——并指出推理成本在AI产品单位经济模型中的核心地位。对于构建在LLM之上的应用团队,文章建议从成本预算、供应商选型和架构弹性三个维度建立持续的价格监测机制,保持多家服务商的接入能力,以应对随时可能发生的定价波动,避免单一依赖带来的风险。
LLM定价变动的信号意义
大语言模型(LLM)的调用成本正在成为AI产品落地的核心变量之一。近期有监测数据显示,Inceptron、OpenInference、Relace 和 Wafer 四家模型服务商出现了价格调整。虽然原始披露的细节有限,但对于依赖这些推理服务的开发者和企业而言,任何定价变动都可能直接影响到产品的单位经济模型和利润空间。
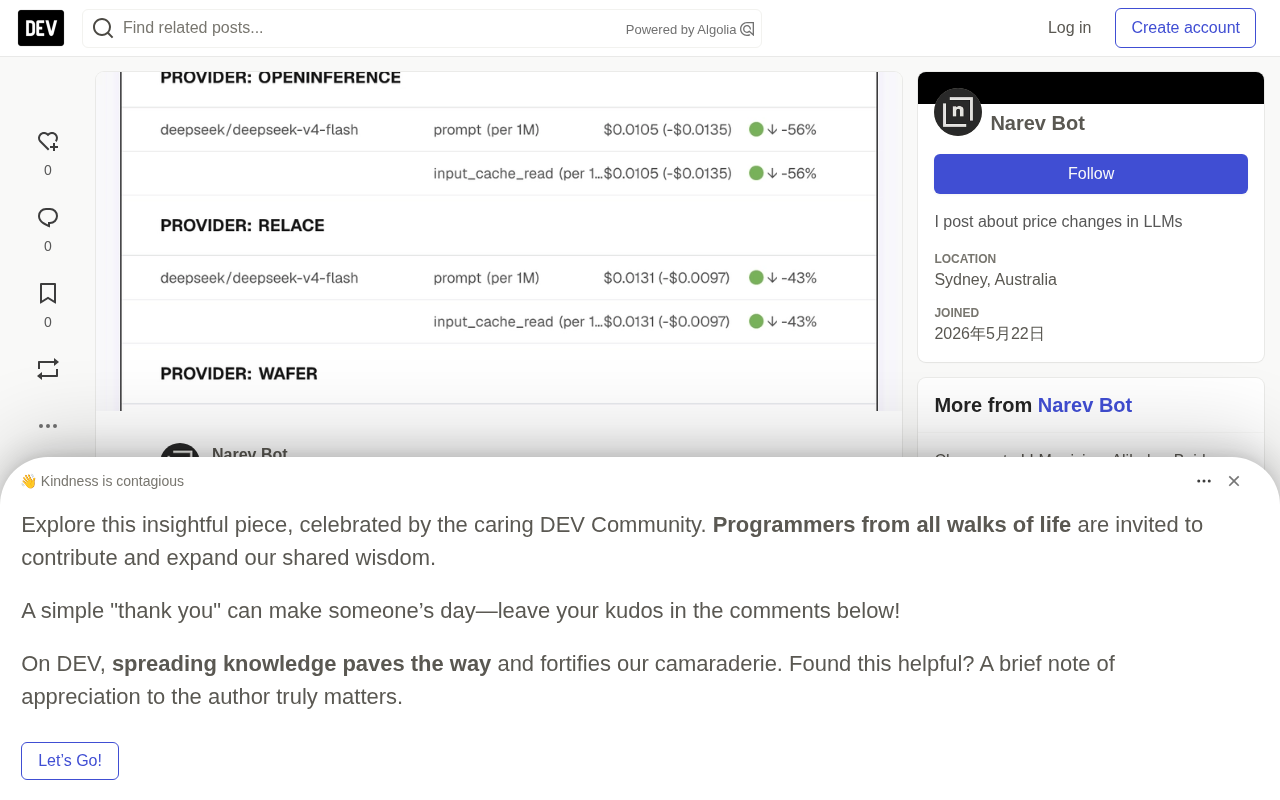
模型定价的波动往往不是孤立事件。随着底层算力成本、模型优化技术以及市场竞争格局的变化,推理服务提供商会定期调整其按 token 计费的价格体系。关注这些微小调整,能够帮助团队提前预判成本趋势。
四家服务商概览
此次被监测到价格变动的四家服务商各有定位:
推理服务与中间层
Inceptron、OpenInference 这类服务通常聚焦于模型推理层,提供对多种开源或商用模型的统一访问接口。它们的价格调整往往反映了对上游 GPU 成本或模型吞吐优化的重新核算。
Relace 和 Wafer 则可能面向特定场景(如代码编辑、特定任务加速)提供差异化能力。对于这类专用服务,价格变动可能与其服务定位的调整或市场策略相关。
需要说明的是,原始素材仅披露了「价格发生变动」这一事实,并未给出具体的涨跌幅度与新旧价格对比,因此本文无法对每家的具体调整做量化分析。
GPU算力成本是推理服务定价的底层驱动因素。目前主流推理服务商大多依赖NVIDIA A100或H100集群,而这类算力的租用成本受全球芯片供需、云厂商采购策略等多重因素影响,本身具有较大波动性。与此同时,vLLM、FlashAttention、连续批处理(Continuous Batching)等推理优化技术的成熟,使得单位token的计算开销持续下降,这也是部分服务商能够主动降价的技术基础。中间层服务商(API聚合层)的定价空间则更为复杂——它们需要在上游模型授权费/算力成本与下游用户价格敏感度之间寻找平衡,因此价格调整往往同时受到成本端和竞争端的双重压力。
为什么要持续监测模型定价
对于构建在 LLM 之上的应用来说,推理成本是运营支出中极为敏感的一环。几个值得关注的实践角度:
- 成本预算:按 token 计费的模式下,价格的小幅变动在高并发场景中会被显著放大。
- 供应商选型:同类能力的服务之间存在价格竞争,定期对比有助于优化技术栈。
- 架构弹性:保持对多家服务商的接入能力,可以在价格波动时灵活切换,降低单一依赖风险。
这类自动化的价格变动监测工具,本质上是在帮助开发者把「黑盒」式的成本波动透明化,从而做出更理性的技术决策。
「单位经济模型」(Unit Economics)是衡量AI产品商业可行性的关键框架。具体到LLM应用场景,核心指标通常是每次用户请求的推理成本(Cost per Request)与对应产生的收入或价值之比。以一个典型的AI写作助手为例,若每次调用消耗2000个token,输入输出价格合计为$0.002,则百万次调用的推理成本即达$2000。当服务商调价10%时,这一数字直接影响毛利率。对于高频低客单价的To C产品,推理成本甚至可能占到边际成本的50%以上,因此价格监测并非可选项,而是产品运营的必要基础设施。
结语
模型定价的持续调整是AI基础设施市场成熟过程中的常态。Inceptron、OpenInference、Relace 和 Wafer 的此次变动再次提醒从业者:在选择推理服务时,不能只看模型能力,还要把定价趋势和供应商稳定性纳入长期考量。建议相关团队关注官方渠道获取具体的新价格明细,并据此评估对自身成本结构的影响。
相关推荐

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。