LLM访问控制:别让AI代理的权限链成为泄密通道

LLM访问控制的关键不在提示词,而在工具调用执行前的逐调用授权与默认拒绝。
文章指出,多数团队把LLM访问控制误当作提示词问题,靠系统提示和输入审核来约束代理,但真正的攻击利用的是代理已持有的工具权限。AI代理由模型、循环和工具组成,每次工具调用都是对真实系统的操作,安全边界在运行时而非模型输出。检查用户或检查提示词都无法阻断攻击,唯一有效的检查点是工具调用执行前的策略评估。文章用读文档、写工单、发通知三个工具组成的链条说明:每一步单独合理,组合起来却构成数据外泄路径,无需漏洞利用或越狱。有效机制是逐调用授权、默认拒绝、决策与审计合一,顺序为策略先于执行。监控日志写在调用之后,不能替代执行前控制。
LLM访问控制:别让AI代理的权限链成为泄密通道
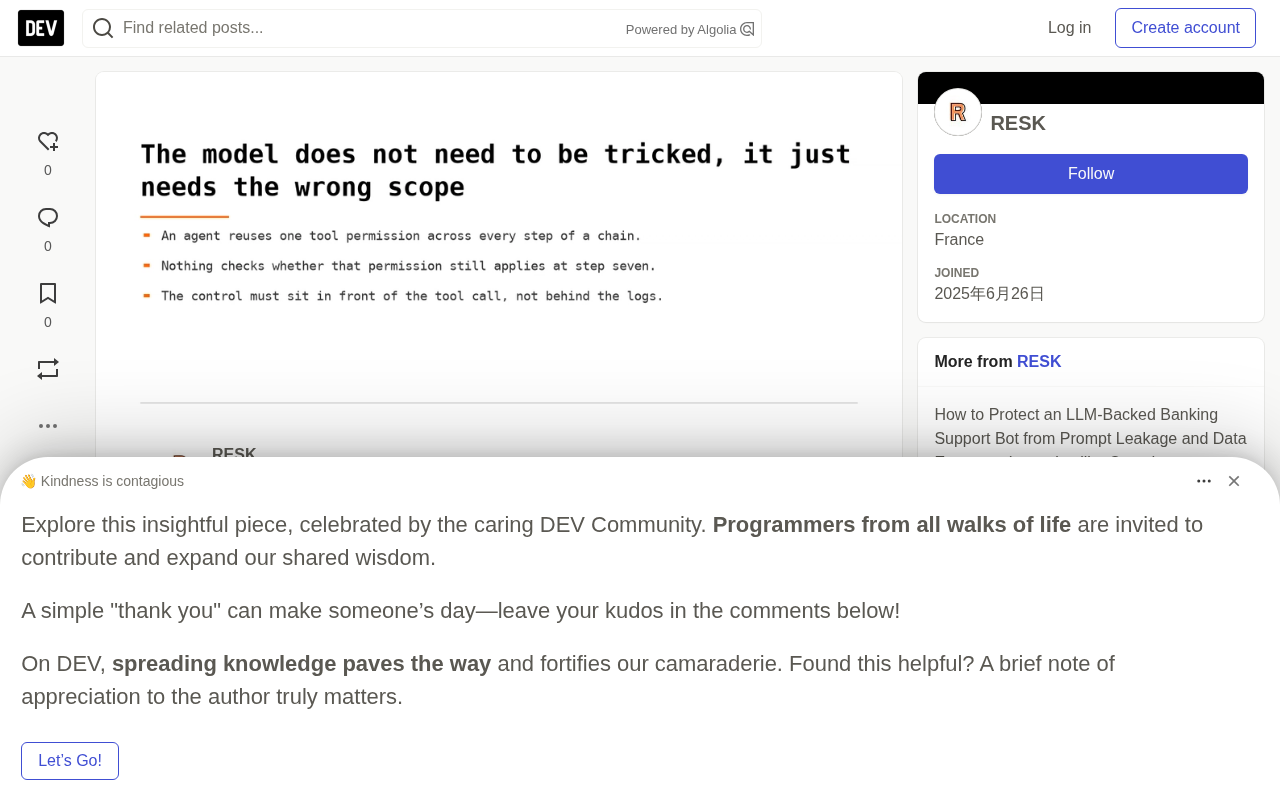
大多数团队把LLM访问控制当作提示词问题来处理:加一句“不要做X”的系统提示,再套一层输入审核,就认为万事大吉。但真正得手的攻击很少走提示词这条路,它们利用的是代理已经握在手里的权限。
什么是AI代理安全?
AI代理安全是一个约束性学科:它关注的是,当LLM系统被赋予工具、凭证和数据之后,系统实际能做什么。这跟模型安全是两回事——模型安全管的是模型“说什么”,代理安全管的是系统“执行什么”。
一个代理可以拆成三部分:模型、循环、一组工具。模型提出动作,运行时执行,结果回到上下文,循环继续。每一次工具调用,都是对真实系统的一次真实操作。安全边界就在这里:不是模型产出的文本,而是运行时愿意替它发起的调用。
这也是为什么单纯依赖提示词约束行不通——提示词是输入,不是强制机制。一个被训练得乐于助人的模型,会用上你告诉过它的任何工具。
最小权限原则(Principle of Least Privilege)最早由 Saltzer 和 Schroeder 在 1975 年提出,是操作系统与信息安全领域的基石之一:任何主体只应获得完成其当前任务所必需的最小权限,且权限应在任务完成后收回。在传统系统中,这一原则通过进程沙箱、文件权限位、能力(capability)模型等机制落地。放到 LLM 代理场景,难点在于“当前任务”本身是动态演化的——模型在循环中不断提出新动作,权限边界若绑定到会话而非单次调用,就会随链条延长而不断被放大。因此最小权限在代理安全中必须细化为“逐调用最小权限”,否则一个开始时只需读一个文件的代理,最终可能拥有写入工单、发送通知等一整套能力。
访问控制该设在哪一层?
工程师真正要问的问题比“怎么做访问控制”要窄:检查点放在哪里,检查什么内容?
常见答案有三个,但只有最后一个经得起攻击考验。
检查用户:认证人类,签发令牌,让代理带着令牌行动。这行不通,因为代理要跨多个步骤、多个工具行动,而人类令牌是为人类会话划定的范围,不是为一连串自动化调用准备的。
检查提示词:指示模型待在范围内。这同样行不通,因为指令是输入,不是执行。模型不会因为一句“别越界”就真的不越界。
检查工具调用:在每次调用执行前,对照策略进行评估。这是唯一站在真实边界上的做法。
监控应当与第三种做法并列,而不是替代它。日志对检测和取证很有必要,但日志行是在调用发生之后才写下的。如果你唯一的控制手段是监控,那你的事件响应就只是一场阅读练习。
攻击面长什么样:三个工具的链条
设想一个代理带着三个工具:文档读取器(限定在一个文件夹)、工单创建器(可写入一个项目)、通知发送器(可触达外部地址)。
现在设想一条链:第一步读取文档,第二步把内容总结成工单,第三步通知某个频道。每一步单独看都合理,失败出在组合上。
放在可读文件夹里的一份文档,包含了引导总结步骤的文本,让代理写入了本不该传播的内容。工单步骤把它写下来,通知步骤把它发出去。没有哪个工具被滥用,没有凭证被盗,模型也没有被越狱——它只是按顺序、用它拥有的权限,做了“有帮助”的事。
这就是为什么这类攻击不是理论问题。它不需要新颖的漏洞利用,只需要代理持有的权限比任何单一步骤所需的都宽,以及一条足够长的链让组合效应显现。而这两点,恰恰是大多数代理部署的默认状态。
同样的模式适用于任何能读的工具加任何能写的工具。读加写加一个循环,就是一条数据外泄路径——除非有什么东西把它打断。
阻断机制:逐调用授权与最小权限
机制是:在工具边界上实行逐调用授权,并贯彻最小权限原则。具体来说包含三个属性。
权限附着在调用上,而不是会话上。 代理不会带着一份宽泛的授权走完整条链。每次工具调用都要对照“该调用在当前步骤、当前数据下被允许做什么”来评估。
默认拒绝。 没有被显式授予本次调用的工具不会执行。这反转了常见模型——过去是代理拥有一个工具箱,策略是一组禁令;现在应该是白名单式授权。
决策在执行前做出,并与调用一起记录。 策略检查和审计记录是同一个事件,因此你监控到的就是你实际执行的,而不是两套需要对账的数据流。
顺序很重要:策略在前,执行在后,日志作为决策的一部分。如果日志是工具跑完之后才写的,那你只有监控,没有控制。
据RESK官方文档描述,其reskSecure组件在代理工具调用上强制执行最小权限,每次调用在执行前对照策略评估,默认拒绝,授权范围绑定到调用本身;ReskPoints则提供执行点,把检查放在代理运行时与工具之间的边界上,而不是事后观察流量的旁路组件。两者合起来实现的正是上述顺序:策略决策、执行、反映实际执行决策的审计记录。
从提示词到策略的迁移清单
如果你目前依赖的是“提示词指令 + 日志”,缺口就在调用被提出到调用被执行之间的那个窗口。控制应该放在那里。
- 列出代理能调用的每个工具,以及每个步骤实际需要的权限范围。
- 移除常驻授权,把权限绑定到调用,而不是会话。
- 对当前调用未显式授权的工具,默认拒绝。
- 在执行前评估策略,而不是之后。
- 让审计记录成为策略决策的一部分,使监控反映执行情况。
- 把“读 + 写 + 循环”当作一条外泄路径来处理,直到被证明不是。
- 审查链条,而不只是单个工具——权限蔓延往往在组合处显现。
- 用一份试图引导链条的文档做测试,确认调用被阻断,而不是只被记录。
AI代理安全的核心不是让模型变得更“听话”,而是让运行时在每次工具调用时都不越权。提示词负责意图,策略负责边界——两者不能互相替代。
背景补充
策略执行点(Policy Enforcement Point, PEP)与策略决策点(Policy Decision Point, PDP)是经典访问控制架构(如 XACML、NIST 零信任参考架构)中的一对概念:PDP 负责根据策略对请求作出允许或拒绝的判断,PEP 负责在真实资源边界上拦截请求并执行该判断。把这一模型映射到代理运行时,工具调用执行前的检查就是 PEP,策略引擎就是 PDP。关键在于 PEP 必须位于代理运行时与工具之间的必经路径上,而不能是旁路观察者——旁路的日志或流量镜像无法阻断正在发生的调用。此外,决策结果需要作为审计事件回写,才能保证“执行了什么”与“记录了什么”是同一事实。
间接提示注入(Indirect Prompt Injection)是这类链条攻击的常见触发方式:攻击者并不直接与模型对话,而是把恶意指令藏在代理会读取的外部内容里——文档、网页、邮件、工单描述。当代理读取这些内容时,其中的文本被当作上下文的一部分,可能引导后续步骤执行攻击者期望的动作。它与直接提示注入的区别在于,攻击面从对话输入扩展到了代理所触及的所有数据源。防御上,仅靠输入过滤难以穷尽,因为合法文档中可以自然嵌入看似合理的指令;更可靠的做法是承认“被读取的内容不可信”,并在工具调用边界上限制这些内容能触发哪些后续操作。
默认拒绝(Default Deny)与白名单式授权是安全设计中的另一条基本原则:未显式允许的一律禁止,而不是列出禁止项、其余放行。后者的问题在于禁止列表永远不完整,攻击者只需找到未被列出的路径。对代理而言,默认拒绝意味着工具不是“默认可用、按需禁用”,而是“默认不可用、按调用显式授权”。这要求部署时先枚举每个工具在每个步骤所需的最小权限,并接受“未授权即失败”的行为变化——代理可能因此拒绝一些原本能完成的动作,但这正是边界生效的表现。审计记录与策略决策合一,则保证了拒绝和允许都留下可追溯的依据,便于事后复核策略是否过宽或过窄。
相关推荐

AGENTS.md 实战指南:让编程 Agent 真正好用
AGENTS.md 和 CLAUDE.md 能显著提升编程 Agent 表现,但研究发现用错反而让成本上升 20%。本文详解该写什么、该删什么、200 行与 32KB 的硬边界、Monorepo 嵌套规则及安全提醒。

花旗AI编程代理Devon:年省30%技术外包费,1.4万工程师已使用
花旗集团利用AI编程代理Devon,一年内削减30%技术供应商费用,1.4万工程师使用,产品发布提速30%-40%。本文分析其对IT外包行业的冲击及未来人机协作模式。

从生日派对到千亿AI帝国:新一代PayPal黑帮崛起
2015年一张生日派对合影,十年后催生Scale AI、Cognition AI等千亿估值AI公司。解析新一代PayPal黑帮的创业路径、互相投资生态,以及Peter Thiel的Founders Fund如何完成代际传承。