LLM工具调用评审的推导鸿沟:DeRef如何修复
研究发现工具调用裁判存在“推导鸿沟”,并提出DeRef解耦推导与评判来修复。
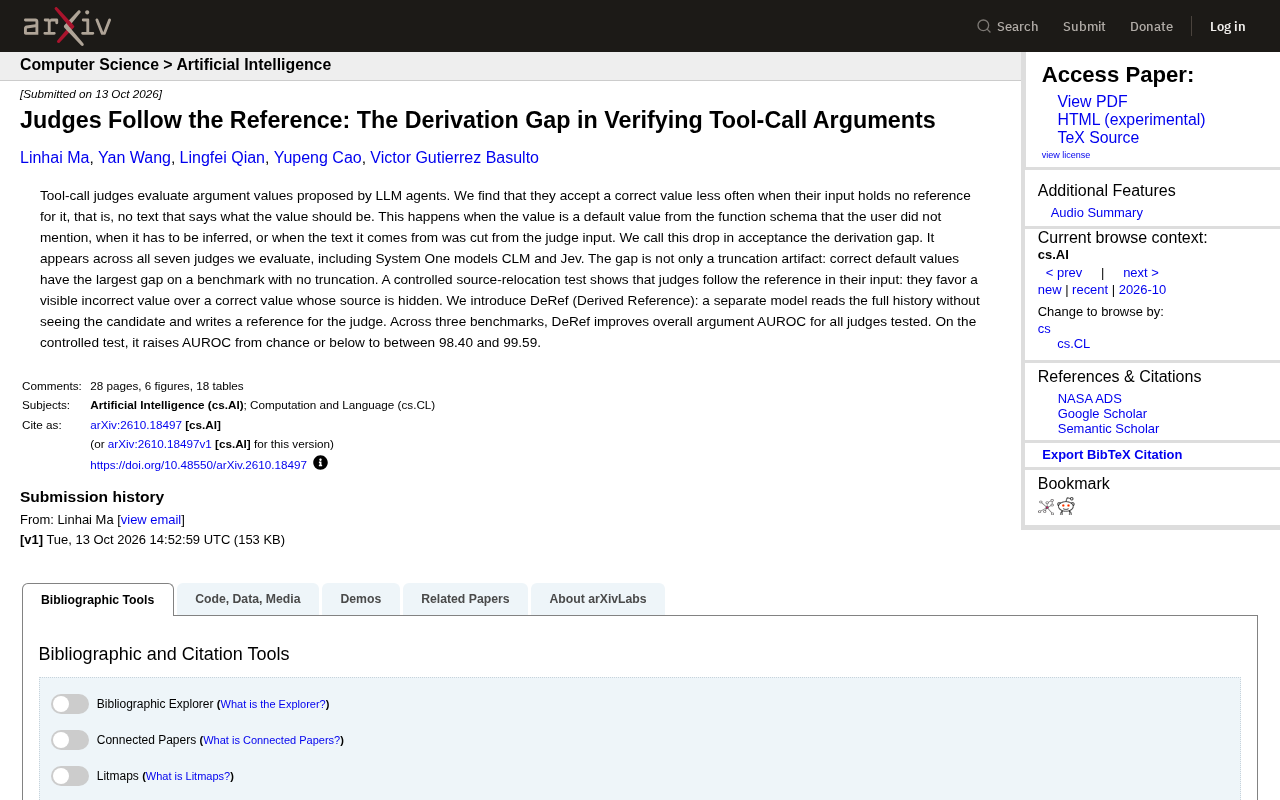
文章介绍了一项关于 LLM Agent 工具调用裁判的新研究。研究者发现,当裁判输入中缺少某个参数值的显式参考文本时,即使该值完全正确,裁判接受它的概率也会显著下降,这一现象被命名为“推导鸿沟”。该缺陷出现在全部七种被评估的裁判模型上,且并非输入截断所致——在无截断基准中,来自 schema 默认值的正确值反而表现出最大鸿沟。受控的“来源迁移”实验进一步证明,裁判倾向于接受输入中可见的错误值,而拒绝来源被隐藏的正确值,说明它们是在“跟随参考”而非独立验证。为此研究者提出 DeRef 方案:用独立模型从完整对话历史中生成参考文本,裁判只需比对。DeRef 在三个基准上提升了所有裁判模型的 AUROC,受控实验中更高达 98.40–99.59。
LLM Agent 在执行任务时,经常需要调用外部工具。工具调用的参数值是否正确,往往由一个"裁判模型"(judge)来把关。但一项新研究发现,这些裁判存在一个系统性缺陷:当输入中找不到某个值的"出处"时,即使这个值完全正确,裁判也更倾向于拒绝它。研究者将这一现象命名为"推导鸿沟"(derivation gap)。
什么是推导鸿沟
工具调用裁判的工作流程通常是:给定对话历史,判断 LLM Agent 提出的参数值是否正确。理想情况下,裁判应该基于对函数 schema、对话上下文和任务目标的理解做出判断。但实际表现并非如此。
研究发现,当裁判的输入中缺少某个值的直接"参考文本"——也就是没有一段文字明确说出这个值应该是什么——裁判接受正确值的概率会显著下降。这种情况出现在三种场景中:值来自函数 schema 的默认值但用户从未提及;值需要从上下文中推理得出;或者包含该值的文本被截断在裁判输入之外。
这个下降幅度被定义为"推导鸿沟"。它出现在研究者评估的全部七种裁判模型上,包括 System One 系列的 CLM 和 Jev。
函数 schema 是工具调用机制中的基础概念。在 LLM Agent 场景下,每个外部工具(如搜索、计算、数据库查询)都需要向模型声明自己的接口定义,这份定义就是函数 schema。它通常以 JSON Schema 格式描述工具的名称、用途、以及每个参数的名称、数据类型、是否必填和默认值。例如一个天气查询工具可能声明 location 为必填字符串、unit 为可选字符串且默认值为 celsius。Agent 在决定调用某工具时,必须生成一份符合该 schema 的参数对象。裁判模型判断参数是否正确时,schema 本身也是重要依据之一——因为默认值往往只存在于 schema 中,对话历史里从未被用户或 Agent 明确提及。这正是推导鸿沟最容易出现的场景:值是正确的,但唯一“支持”它的文本来源在裁判看不到的地方。
不只是截断问题
一个自然的假设是:推导鸿沟只是输入截断导致的伪影——信息被切掉了,裁判当然判断不了。但实验数据否定了这个解释。
在一个完全没有截断的基准测试中,正确的默认值反而表现出最大的推导鸿沟。这意味着问题不在于信息丢失,而在于裁判从根本上依赖输入中的显式参考文本,而非独立验证值的正确性。
研究者设计了一个受控的"来源迁移"实验来验证这一点。实验结果非常直接:裁判会倾向于接受一个输入中可见的错误值,而拒绝一个来源被隐藏的正确值。换句话说,裁判在"跟随参考"——它们判断的依据不是值本身对不对,而是输入里有没有支持这个值的文字。
AUROC(Area Under the Receiver Operating Characteristic curve,ROC 曲线下面积)是评估二分类判别模型性能的常用指标。ROC 曲线以假阳性率(FPR)为横轴、真阳性率(TPR)为纵轴,绘制不同判定阈值下的表现;曲线下面积即 AUROC,取值范围为 0 到 1。0.5 相当于随机猜测,1.0 代表完美区分。在裁判模型场景中,正类是“参数值正确”、负类是“参数值错误”,AUROC 衡量的是裁判给正确值打分高于错误值的概率。使用 AUROC 而非简单准确率的好处在于它不受判定阈值和正负样本比例影响,便于在不同基准和不同模型之间横向比较。因此文中用 AUROC 从随机水平提升到 98 以上,说明裁判几乎能把正确值和错误值完全分开,是非常显著的改进。
DeRef:让独立模型生成参考
针对这一问题,研究者提出了 DeRef(Derived Reference)方案。核心思路很简洁:用一个独立的模型读取完整对话历史(但不看候选值),然后为裁判写出一段"参考文本",说明各个参数值应该是什么。裁判再基于这段参考文本来做判断。
这种设计将"推导"和"评判"两个步骤解耦。独立模型负责从上下文中推导出正确的参考值,裁判只需要做比对工作,而不必自己从零推导。
DeRef的效果
在三个基准测试上,DeRef 对参与测试的所有裁判模型都提升了参数判断的 AUROC(曲线下面积,衡量二分类判别能力的指标)。
更引人注目的是受控实验的结果:在来源迁移测试中,DeRef 将 AUROC 从随机水平或更低,提升到了 98.40 至 99.59 之间。这说明当裁判获得了可靠的参考文本后,其判断能力接近完美。
对工具调用评测的启示
这项研究揭示了一个容易被忽视的问题:我们评估 Agent 工具调用能力时,裁判模型的可靠性直接决定了评估结论的可信度。如果裁判系统性地倾向于"有据可查"的值而拒绝"需要推理"的正确值,那么那些需要复杂推理才能得出的正确参数,可能在评估中被错误地标记为失败。
DeRef 方案的价值不仅在于提升了裁判准确率,更在于它指出了一个通用的改进方向——不要让裁判同时承担"推导"和"验证"两个职责。将推导步骤交给专门的模型,让裁判专注于比对,能显著提升整个评估流程的可靠性。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。