LLM能自主发现隐藏物理定律吗?新研究给出答案

LongChang框架测试12个LLM在修改物理定律世界中的自主发现能力,仅GPT-6-Astra发现率16.7%。
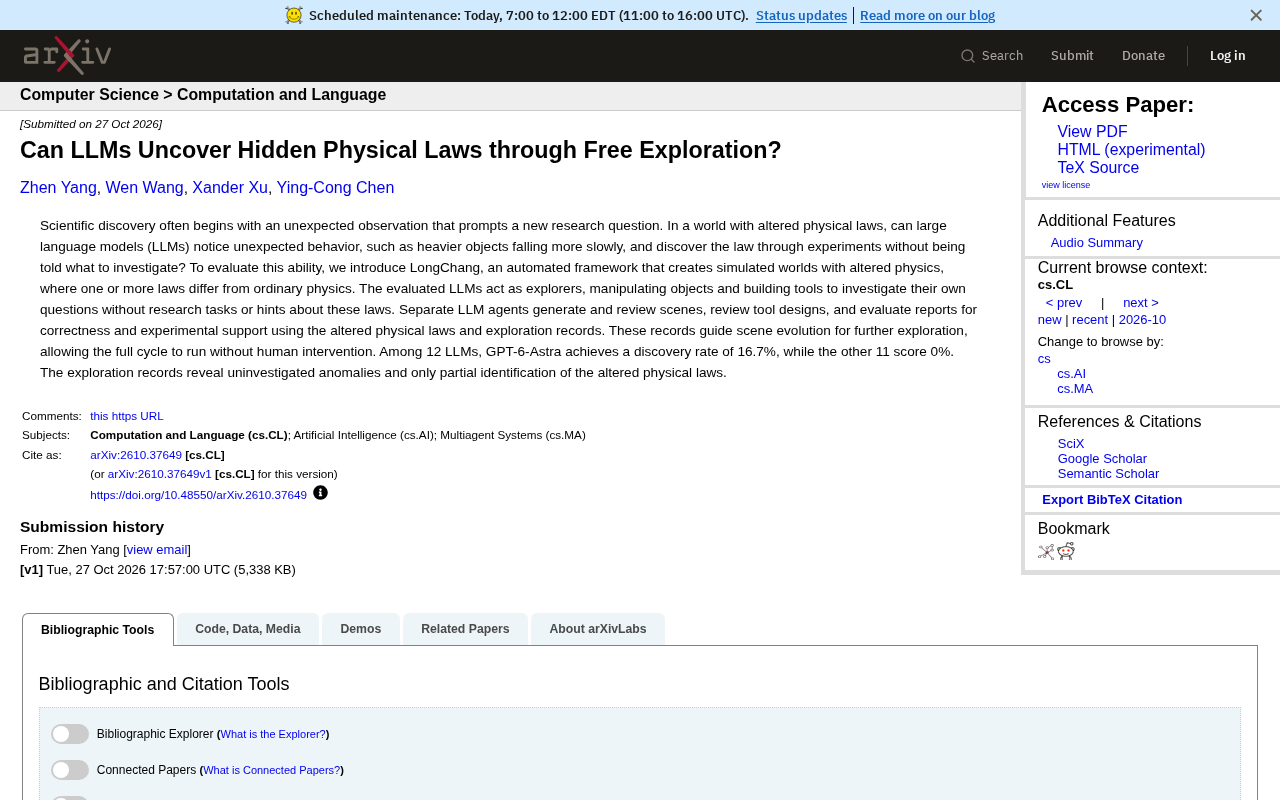
研究构建了LongChang自动化框架,生成物理规律被修改的模拟世界,让LLM在无任务提示下自由探索并尝试发现隐藏定律。测试12个模型后,仅GPT-6-Astra取得16.7%的发现率,其余均为0%。探索记录显示,模型常忽视异常现象,且只能部分识别改变后的定律,核心瓶颈在于主动问题生成与假设整合。框架采用多智能体分工实现全自动闭环评估,模拟同行评议,为测量LLM科学发现能力提供了可扩展平台。
科学发现常常始于一个意外的观察,它促使研究者提出新的问题。那么,如果世界运行的物理规律被悄然改变,大型语言模型(LLM)能否像人类科学家一样,注意到反常现象(比如更重的物体反而下落得更慢),并通过自主实验来揭示背后的定律?一项新研究对这个问题给出了初步的探索性回答。
一个没有研究任务的“异世界”实验场
为了评估LLM的自主发现能力,研究者构建了名为LongChang的自动化框架。该框架会生成一系列物理规律被修改的模拟世界——其中一条或多条定律与日常物理不同。被评估的LLM扮演“探索者”的角色:它们可以操纵物体、制造工具,并自主决定研究什么问题,整个过程不会被给予研究任务或关于这些定律的任何提示。
为了确保探索流程的闭环和客观性,LongChang还部署了独立的LLM智能体,分别负责生成和审查场景、审核工具设计,以及依据被改变的物理定律和探索记录来评估报告的正确性与实验支持度。这些探索记录会进一步引导场景演化,使得整个探索循环无需人工干预即可持续运行。
多智能体系统(Multi-Agent System) 是由多个具备一定自主性的智能体组成的计算系统,每个智能体拥有独立的感知、决策和行动能力,并通过通信与协作完成单个智能体难以胜任的任务。在LLM语境下,多智能体系统通常指让多个LLM实例分别扮演不同角色(如生成者、审查者、评估者),通过结构化交互实现分工与制衡。这种架构的核心优势在于:一方面,角色分离可以降低单一模型的主观偏差,使评估更接近“同行评议”的客观性;另一方面,各智能体可以并行处理不同子任务,提高整体流程的效率和可扩展性。LongChang正是利用这一思路,将场景生成、工具审查和报告评估拆解给不同智能体,从而构建无需人工干预的自动化评估闭环。
发现率仅16.7%:多数模型交了白卷
研究团队对12个LLM进行了测试。结果相当严峻:只有GPT-6-Astra取得了16.7%的发现率,即成功发现了被修改的物理定律;其余11个模型的发现率均为0%。这意味着在自由探索的设定下,绝大多数LLM未能主动识别出异常现象并进一步推导出隐藏的物理规律。
这一数据揭示了当前LLM在开放式科学发现任务上的巨大差距。即使模型具备一定的推理和规划能力,它们仍然难以在没有明确目标引导的情况下,持续地追踪反常线索并设计有效的实验来验证假设。
探索记录里的线索:异常被忽视,定律仅部分识别
除了发现率,研究者还分析了探索记录,以理解模型为何失败。记录显示,模型经常会遇到未被调查的异常现象——它们观察到了奇怪的结果,却没有跟进研究。此外,即使模型们有所行动,它们对改变后的物理定律也仅能实现部分识别,无法完整推导出背后的规律。
这些发现说明,LLM在自主科学发现中的一个核心瓶颈在于“问题生成”:它们可能能够执行预设的实验任务,但难以从被动观察中主动提出值得深究的研究问题,并将零散的线索整合成完整的定律描述。
假设生成(Hypothesis Generation) 是科学发现过程中的关键环节,指研究者基于观察到的现象提出可检验的解释性命题。在开放式科学发现中,假设生成与“问题生成”紧密相连:科学家首先需要从纷繁的观察中识别出值得深究的异常,再将其转化为明确的假设,进而设计实验加以验证。对人类科学家而言,这一过程往往依赖直觉、领域知识和类比推理;而对LLM来说,假设生成要求模型不仅理解当前观察,还要判断其与预期规律的偏差,并主动构建可证伪的候选解释。文章指出多数模型在遇到异常时“没有跟进研究”,本质上就是假设生成环节的缺失——模型缺乏将异常信号转化为研究问题的内在驱动力和推理机制。
自动评估框架与多智能体协作的意义
LongChang框架的设计本身也值得关注。它通过多个分工明确的LLM智能体(场景生成与审查、工具设计审查、报告评估)来实现全自动的评估循环,避免了人工标注和干预带来的瓶颈。这种架构为未来研究LLM的科学推理能力提供了一个可扩展的测试平台,也展示了多智能体协作在复杂评估任务中的潜力。
同时,该框架强调报告需要得到实验证据的支持,这在一定程度上模拟了科学共同体中的同行评议过程,使得评估更加严格和贴近真实科研场景。
同行评议(Peer Review) 是科学共同体中确保研究质量的核心机制,指由同一领域的独立专家对研究论文的方法、证据和结论进行批判性审查。其关键特征包括:审查者与作者相互独立、评估基于可复现的证据、结论需经得起质疑。LongChang要求探索报告必须得到实验记录的支持,并由独立LLM智能体依据改变后的物理定律进行审核,这在结构上模拟了同行评议的“证据支撑”与“独立审查”原则。这种设计的意义在于,它将评估标准从“答案是否正确”扩展到“结论是否有充分实验依据”,从而更贴近真实科研场景中对科学严谨性的要求,也使得自动评估结果更具可信度。
展望:LLM距离自主科学家还有多远?
这项研究传递出的信息是双面的。一方面,LLM在自由探索中自主发现物理定律的能力仍然非常有限,尤其是主动异常检测和假设生成方面存在明显短板。另一方面,LongChang这样的框架为系统性地测量和追踪这一能力提供了工具,有助于推动模型向更自主的科学发现方向演进。
未来的改进方向可能包括:增强模型对意外结果的敏感度、鼓励更主动的实验设计、以及提升从部分观察中归纳完整定律的推理能力。对于AI研究者而言,这项研究也提示,仅仅扩大模型规模或提升基准测试成绩,并不自动转化为开放式科学发现的能力。
相关推荐

Ollama+RAG本地知识库搭建实战:AnythingLLM喂饭教程
基于B站教程整理,详解Ollama+AnythingLLM搭建本地RAG知识库的完整流程:从通用大模型的知识局限、RAG检索增强生成原理,到文档上传、向量化入库与效果验证的实操步骤。

Ollama保姆级教程:本地免费跑大模型入门指南
Ollama是一款开源的本地大模型管理工具,支持免费下载部署DeepSeek等模型,提供命令行和Web UI,跨平台且能自动调度GPU/CPU资源,适合AI开发入门与私有化部署。

给Claude装上"手":Exoproc开源MCP服务器实现活体进程钩子
Exoproc是一个开源MCP服务器,让Claude Code通过线程劫持直接挂钩活跃Windows x64进程,绕过EDR实现动态分析。静态反编译给Claude眼睛,动态钩子给它双手。