LLM评估新框架:自置信度与LLM辅助审计的统计效率
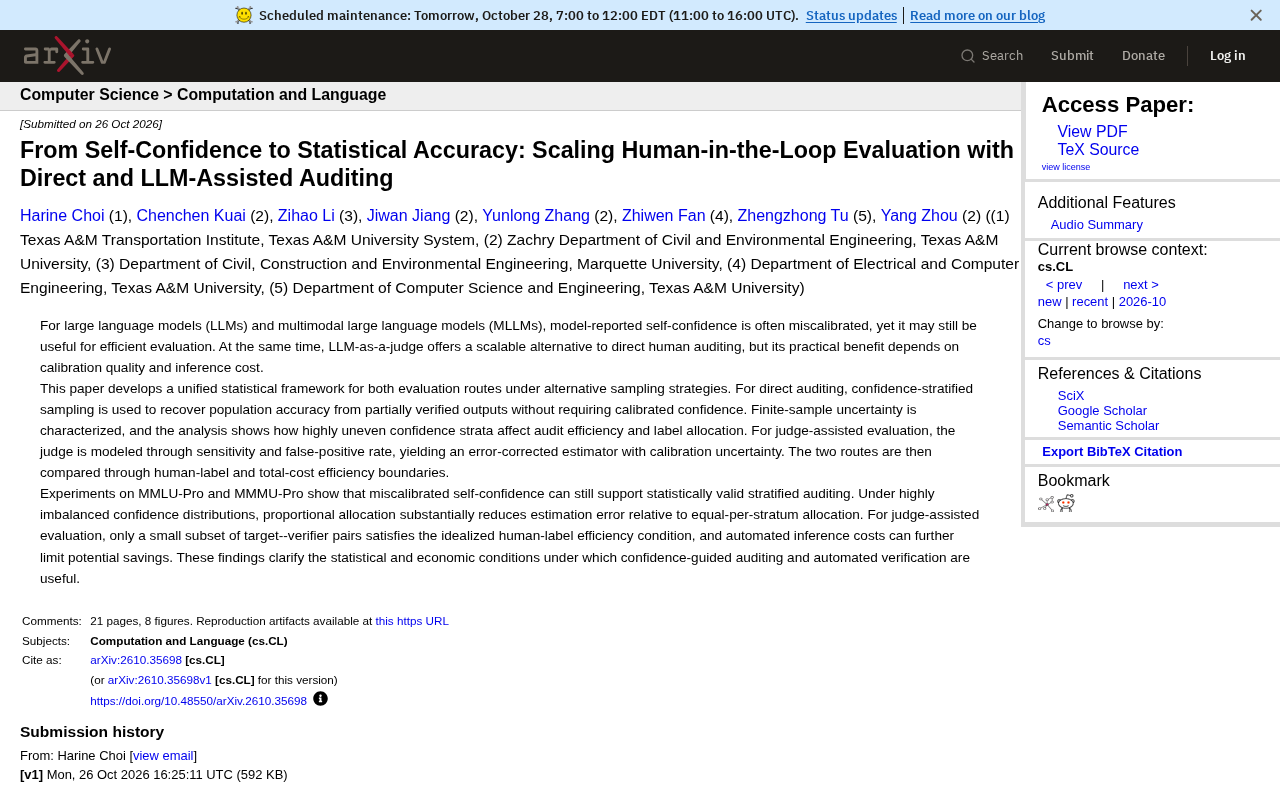
论文用统一统计框架厘清置信度分层审计与LLM法官评估各自有效的条件。
文章介绍了一项针对大模型评估成本与准确性矛盾的研究。模型自报置信度往往校准不佳,人工审计又难以规模化,而 LLM-as-a-judge 虽可扩展却并非普适降本方案。论文为直接审计与法官辅助评估建立统一统计框架:前者采用置信度分层采样,证明即使置信度未校准也能恢复总体准确率,且在分布高度不均衡时按比例分配优于每层等量分配;后者通过敏感性和假阳性率对法官建模,得到带校准不确定性的误差校正估计量。两条路线借人工标签效率与总成本效率边界比较,结论是只有少数目标-验证器对满足理想效率条件,推理成本会进一步压缩节省空间。
大型语言模型(LLM)和多模态大模型(MLLM)的评估正面临一个根本矛盾:模型自报的置信度往往校准不佳,但人工审计又难以规模化。一篇最新论文提出了统一的统计框架,试图回答一个关键问题——在什么条件下,置信度引导的审计和LLM-as-a-judge自动验证才能真正节省成本且保证准确性?
问题背景:置信度不可靠,但可能仍有用
模型自报的置信度通常存在校准偏差,高置信度不等于高准确率。然而论文指出,即便校准不完美,置信度仍可能用于高效评估——前提是采用正确的采样策略。
话说回来,LLM-as-a-judge 提供了一种可扩展的人工审计替代方案,但其实际收益取决于校准质量和推理成本。两条评估路径各有优劣,此前缺乏统一的统计比较框架。
置信度校准(calibration)衡量的是模型自报概率与实际正确率之间的一致性。一个校准良好的模型,在置信度为 0.8 的样本中应有约 80% 确实正确。实践中 LLM 普遍存在过度自信,即高置信度区间的实际准确率明显低于自报值,这通常用期望校准误差(ECE)或可靠性图来度量。需要区分的是,校准关注“概率数值是否可信”,而判别力关注“高置信度样本是否确实比低置信度样本更可能正确”。即便校准存在偏差,只要置信度保持一定的排序判别力,就仍能作为分层抽样的辅助变量使用——这正是论文论证置信度“不可靠但仍有用”的统计逻辑起点。
统一统计框架:直接审计与法官辅助评估
论文为两种评估路线建立了统一的统计框架,分别处理不同的采样策略。
直接审计:置信度分层采样
对于直接人工审计,研究者采用置信度分层采样,从部分验证的输出中恢复总体准确率,且不要求置信度本身已校准。框架刻画了有限样本不确定性,并分析了高度不均衡的置信度分层如何影响审计效率和标签分配。
实验在 MMLU-Pro 和 MMMU-Pro 上进行,结果显示:校准不佳的自置信度仍能支持统计上有效的分层审计。在置信度分布高度不均衡时,按比例分配(proportional allocation)相比每层等量分配(equal-per-stratum allocation)显著降低了估计误差。
分层采样(stratified sampling)是一种经典的抽样设计:先把总体按某个辅助变量划分为若干互不重叠的层,再在各层内独立抽样,最后按层大小加权合并估计量。它的核心价值在于降低估计方差——当层内单位同质性较高时,抽样误差会显著小于简单随机抽样。应用到模型评估时,置信度分数天然可作为分层变量,高置信度层与低置信度层的准确率通常差异很大。但分层采样要求各层的样本量配置合理:按比例分配使每层抽样比例一致,适合层大小悬殊的情形;等量分配则让每层抽取相同数量,在层间方差相近但层大小差异大时会浪费预算。原文所讨论的分配方式之争,正是这一抽样设计理论在 LLM 评估场景下的直接体现。
法官辅助评估:带校准不确定性的误差校正
对于法官辅助评估,论文通过敏感性和假阳性率对法官建模,得到一个带校准不确定性的误差校正估计量。随后,两条路线通过人工标签效率和总成本效率边界进行比较。
关键发现是:只有一小部分目标-验证器对满足理想化的人工标签效率条件,自动推理成本可能进一步限制潜在节省。这意味着 LLM-as-a-judge 并非普适的降本方案,其经济性高度依赖于具体场景。
LLM-as-a-judge 指让一个语言模型充当评审,对另一个模型的输出自动判定对错或质量。它便宜、可并行,但判决本身有误差:可能把正确输出误判为错误(假阳性),也可能放过错误输出(假阴性)。误差校正估计量的思路是,先在一小批人工标注样本上估计法官的敏感性和假阳性率,再用这些参数反推真实准确率,从而修正法官的系统性偏差。这里的关键风险是误差校正中的“校准不确定性”——敏感性和假阳性率本身是估计值,带有抽样误差,会传导到最终准确率的置信区间中。若法官在某些细分群体上表现差异大,这种不确定性还会被放大,因此论文强调必须把校准不确定性纳入估计量,而不是把法官判决当成无误差的真值使用。
实践启示:何时该用哪种评估路线
论文的贡献在于厘清了置信度引导审计和自动验证各自有用的统计与经济条件。对于实践者而言,这意味着:
- 不要因为置信度未校准就放弃分层采样,按比例分配可以在不均衡分布下有效降低误差;
- 引入 LLM 法官前应评估目标-验证器对是否满足效率条件,并计入推理成本;
- 两条路线并非互斥,统一框架允许根据成本边界做混合决策。
这项研究为 Human-in-the-Loop 评估的规模化提供了可操作的统计基础,而非简单断言某条路线更优。
相关推荐
CodeMode:让AI代理写代码代替调用工具,token成本直降90%
探索CodeMode如何让AI代理通过编写代码在沙箱中执行,替代传统逐个调用工具的方式,从而减少token消耗高达90%,并分析其实现要点与适用场景。
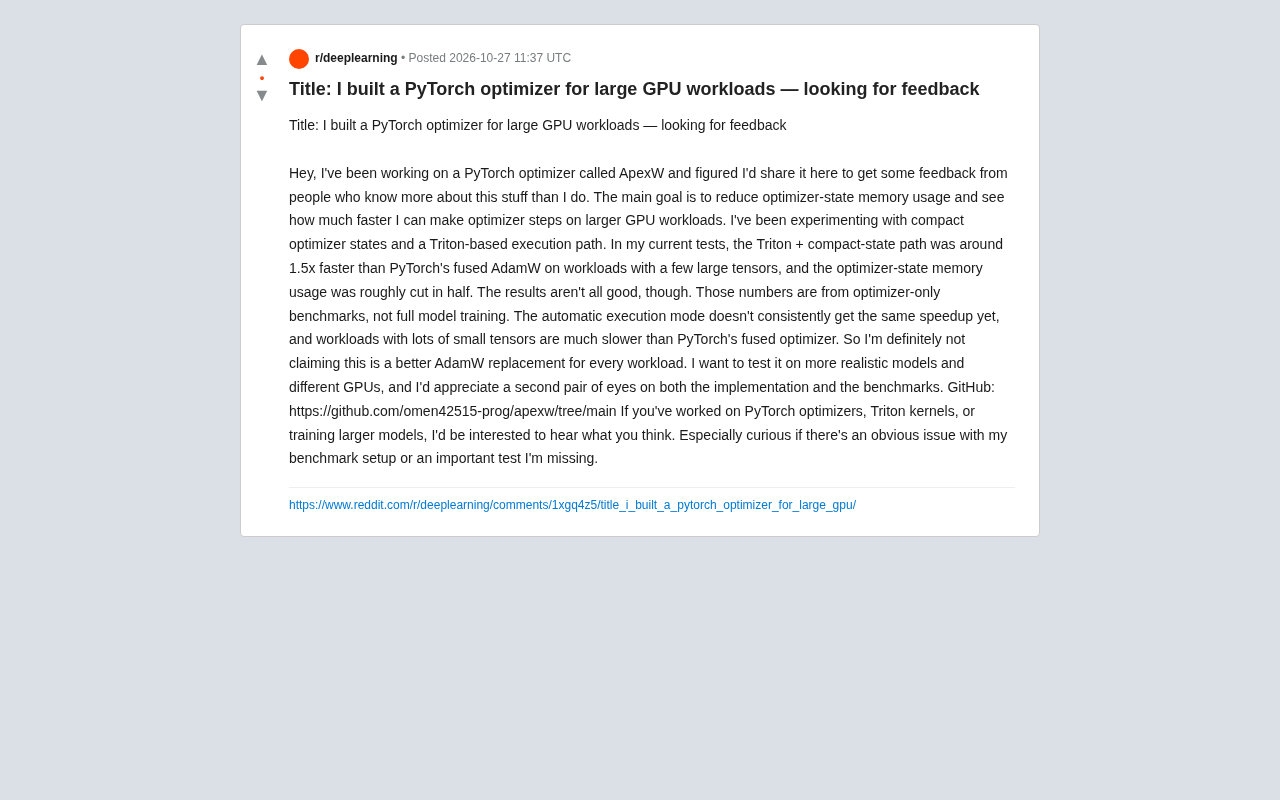
开发者自研PyTorch优化器ApexW:显存减半、提速1.5倍
开发者发布PyTorch优化器ApexW,采用紧凑优化器状态与Triton执行路径,在仅优化器基准中比fused AdamW快约1.5倍、状态显存约减半,但小张量与自动模式仍有明显短板,作者公开征集基准与实现反馈。
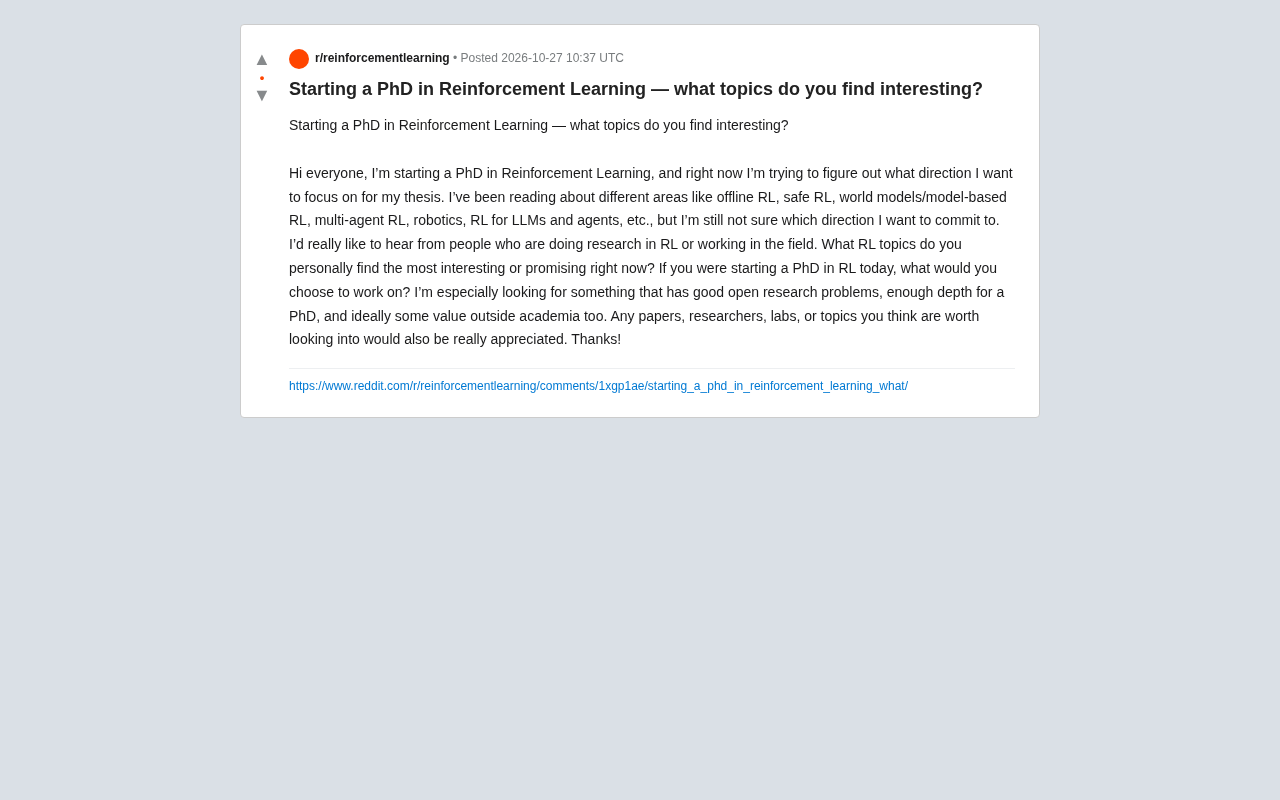
RL博士研究方向怎么选?六大前沿领域深度解析
RL博士研究方向怎么选?本文深度解析RL for LLMs、离线RL、安全RL、世界模型、多智能体RL和机器人RL六大前沿方向的开放问题、优势与风险,并提供兴趣匹配、产业价值平衡、导师匹配和技能可迁移性四个选择框架,帮助博士生做出明智决策。