LLM强化学习:重要性采样比真的必要吗?LGPO给出否定答案

LGPO用似然门控替代重要性采样比,省去旧策略似然计算,训练时间减少约18%且更鲁棒。
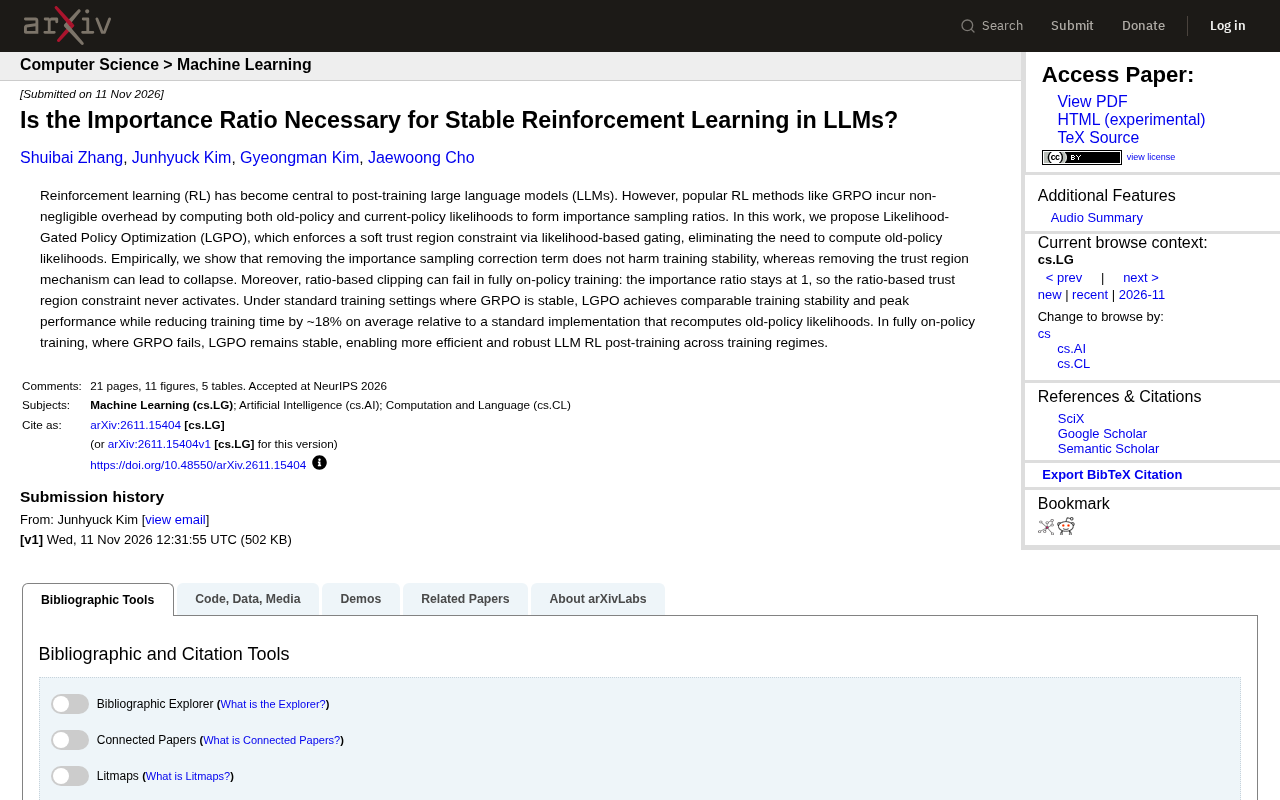
文章介绍了一项来自RSS的研究,该研究质疑了LLM强化学习后训练中重要性采样比的必要性。传统GRPO等方法需要同时计算旧策略和当前策略的似然来构造重要性采样比并进行裁剪,带来显著的双倍计算开销。研究提出LGPO(Likelihood-Gated Policy Optimization),用基于似然的门控实现软信任域约束,彻底省去旧策略似然计算。实证表明,去除重要性采样修正不损害稳定性,真正维系稳定的是信任域约束本身;而在完全on-policy场景中,重要性采样比恒为1导致比率裁剪失效,GRPO可能崩溃,LGPO仍保持稳定。在标准设置下LGPO性能与GRPO相当,训练时间平均减少约18%,实现了性能与效率的双赢。
强化学习后训练的效率瓶颈
强化学习(RL)已经成为大语言模型(LLM)后训练的核心环节。在众多RL方法中,GRPO(Group Relative Policy Optimization)因其简洁有效而被广泛采用。然而,这类方法有一个不太起眼却代价不菲的环节:为了构造重要性采样比(importance sampling ratio),需要同时计算旧策略(old-policy)和当前策略(current-policy)的似然值。这种双重计算带来了不可忽视的开销。
一篇来自RSS的最新研究直接质疑了这一设计前提:重要性采样比,真的对LLM的稳定RL训练必要吗?
GRPO(Group Relative Policy Optimization)是 DeepSeek广告 团队在 DeepSeekMath 论文中提出的一种强化学习算法,其核心思想是放弃 PPO 中独立的价值网络(critic),转而用同一问题下多条采样回复的组内平均奖励作为基线来估计优势函数。这一改动显著降低了显存占用和计算复杂度,使 RL 训练在 LLM 规模上变得可行。GRPO 的损失函数中保留了 PPO 式的概率比裁剪项,因此每次参数更新时仍需同时获取采样时旧策略与当前策略对同一 token 序列的 log-probability,这正是文中所述双倍似然开销的来源。
重要性采样(importance sampling)是统计学中用于从一个分布下采样的数据估计另一个分布下期望值的技术,其修正权重即为重要性采样比 $r_t(\theta) = \pi_\theta(a_t|s_t) / \pi_{\theta_{old}}(a_t|s_t)$。在 PPO 系方法中,该比率用于修正策略更新前后分布偏移带来的梯度偏差,并通过裁剪 $r_t$ 到 $[1-\epsilon, 1+\epsilon]$ 区间来构造信任域。在 LLM 的 RL 后训练里,这意味着训练引擎必须保留一个不参与梯度更新的旧策略副本,或缓存其前向计算的 log-prob,从而带来额外的显存与计算开销。
LGPO:用似然门控替代重要性采样
该研究提出了Likelihood-Gated Policy Optimization(LGPO),其核心思路是用基于似然的门控(likelihood-based gating)来施加软信任域约束,从而彻底省去旧策略似然的计算。
传统重要性采样比的作用是纠正新旧策略之间的分布偏移,并通过裁剪(clipping)将策略更新限制在信任域内。LGPO的观察是:这两件事其实可以解耦——信任域约束不必依赖重要性采样比来实现。通过似然门控,LGPO能够在不需要旧策略似然的前提下,维持策略更新的稳定性。
去除重要性采样修正,训练依然稳定
实证结果给出了相当反直觉的结论:去掉重要性采样修正项并不会损害训练稳定性;相反,去掉信任域机制才可能导致训练崩溃(collapse)。这说明在LLM的RL后训练中,真正维系稳定性的是信任域约束本身,而非重要性采样比这个中间变量。
这一发现具有直接的方法论意义:既然重要性采样比不是稳定性的必要条件,那么为计算它所付出的双倍似然开销,至少在部分场景下是可以省掉的。
信任域(trust region)约束是策略梯度方法中的一类稳定性机制,其目标是限制每次更新后新策略与旧策略之间的分布差异,避免因步长过大导致策略性能骤降。TRPO 用 KL 散度的硬约束实现信任域,PPO 则用比率裁剪作为其近似实现。在 LLM 的 RL 训练中,由于奖励信号稀疏且策略空间维度极高,信任域约束对防止训练崩溃尤为关键,但如何以更低成本施加这一约束一直是工程上的权衡点。LGPO 的似然门控本质上是用当前策略对采样 token 的绝对似然水平来间接控制更新幅度,从而绕开了对旧策略分布的显式依赖。
全on-policy场景下,比率裁剪为何失效
研究还揭示了一个更微妙的失效模式。在完全on-policy的训练中,策略更新与采样策略一致,重要性采样比恒等于1。此时,基于比率的裁剪机制永远不会被激活——信任域约束形同虚设。
换句话说,GRPO所依赖的比率裁剪,在它本该发挥作用的on-policy场景里反而失灵了。而此时一旦失去有效的信任域约束,训练就可能走向崩溃。这也解释了为何GRPO在完全on-policy训练中会失败,而LGPO凭借基于似然的门控机制仍能保持稳定。
On-policy 与 off-policy 是强化学习中区分数据来源的两个基本概念。On-policy 指用于更新策略的数据必须由当前策略实时采样产生,数据使用一次即弃;off-policy 则允许使用历史策略甚至其他策略产生的数据,通常配合经验回放缓冲区。PPO 本质上是一种近端策略优化方法,通过重要性采样比在两者之间取得折中,允许多个 epoch 的小批量更新。当训练严格 on-policy、每个数据批次只更新一次时,旧策略与当前策略完全一致,比率恒为 1,裁剪项退化为恒等映射,信任域约束实际上不再起作用——这正是文中指出的失效机制。
性能与效率的双赢
在GRPO本身表现稳定的标准训练设置下,LGPO达到了与GRPO相当的训练稳定性和峰值性能。更关键的是效率:相对于需要重新计算旧策略似然的标准实现,LGPO平均减少约18%的训练时间。
这个数字的意义在于,它是在不牺牲性能的前提下获得的纯效率收益。对于大规模LLM后训练而言,训练时间的压缩直接转化为算力成本的节约。而在GRPO失效的完全on-policy训练场景中,LGPO不仅保持稳定,还打开了更高效的训练范式。
对LLM RL后训练的启示
这项工作的价值不止于一个更快的优化器。它重新审视了LLM强化学习中被默认接受的设计约定:重要性采样比作为PPO系方法的经典组件,其必要性在LLM语境下值得重新评估。
当信任域约束可以通过更轻量的方式实现时,围绕重要性采样比构建的整套计算流程——旧策略似然的前向计算、比率裁剪逻辑——都有了被简化的空间。LGPO的实证表明,这种简化不仅可行,还能在更宽的训练场景中保持鲁棒性。对于正在构建RL后训练流水线的团队而言,这是一个值得关注的方向。
相关推荐

@ai-sdk/harness-fx 1.0.107 发布:依赖 MCP 升级,补丁更新
@ai-sdk/harness-fx 1.0.107 版本发布,主要更新依赖 @ai-sdk/mcp 至 2.0.103。了解这次补丁更新的内容、对 AI SDK 开发者的影响以及升级建议。

硅谷怎么了?O'Reilly长文引发Hacker News热议
O'Reilly Radar 发表《What Happened to Silicon Valley?》,在 Hacker News 获 302 分、153 条评论。文章梳理这场关于硅谷创新生态与文化变迁的公共讨论,分析为何技术社区对硅谷身份的追问再次升温。
马杜罗被捕后,委内瑞拉何去何从?
委内瑞拉前总统马杜罗被美军抓捕后关押于布鲁克林监狱,2027年将在纽约受审。本文梳理其执政历程、美国指控、选举争议及委内瑞拉当前权力真空与石油博弈。