LLM如何预测下一个Token?拆解大模型生成机制

大模型逐个预测下一个token,循环生成文本,采样策略决定多样性。
文章拆解了大语言模型生成文本的核心机制:预测下一个token。首先澄清LLM处理的最小单位是token而非单词,token可以是词、子词或标点,切分由tokenizer决定。接着描述生成循环:处理上下文→计算下一token概率分布→按策略选择token→加入文本→再次预测,直到停止。预测能力来自大规模训练中学到的统计模式,Transformer的self-attention帮助捕捉token间关系。文章用词频统计的Python小程序演示核心思想,同时强调真实LLM依赖神经网络参数。最后解释temperature等采样策略改变选择随机性但不增加知识,并讨论下一token预测与"理解"之间的关系:流畅不等于真实,需辩证看待模型能力边界。
LLM如何预测下一个Token?拆解大模型生成机制
当你让ChatGPT补全一句话、解释一个复杂概念,甚至写出一整篇故事时,很容易产生一种错觉:它似乎真的理解了你的问题,然后"变"出了一个答案。但大语言模型(LLM)背后的核心机制其实朴素得令人意外——它只是在预测下一个token最可能是什么。
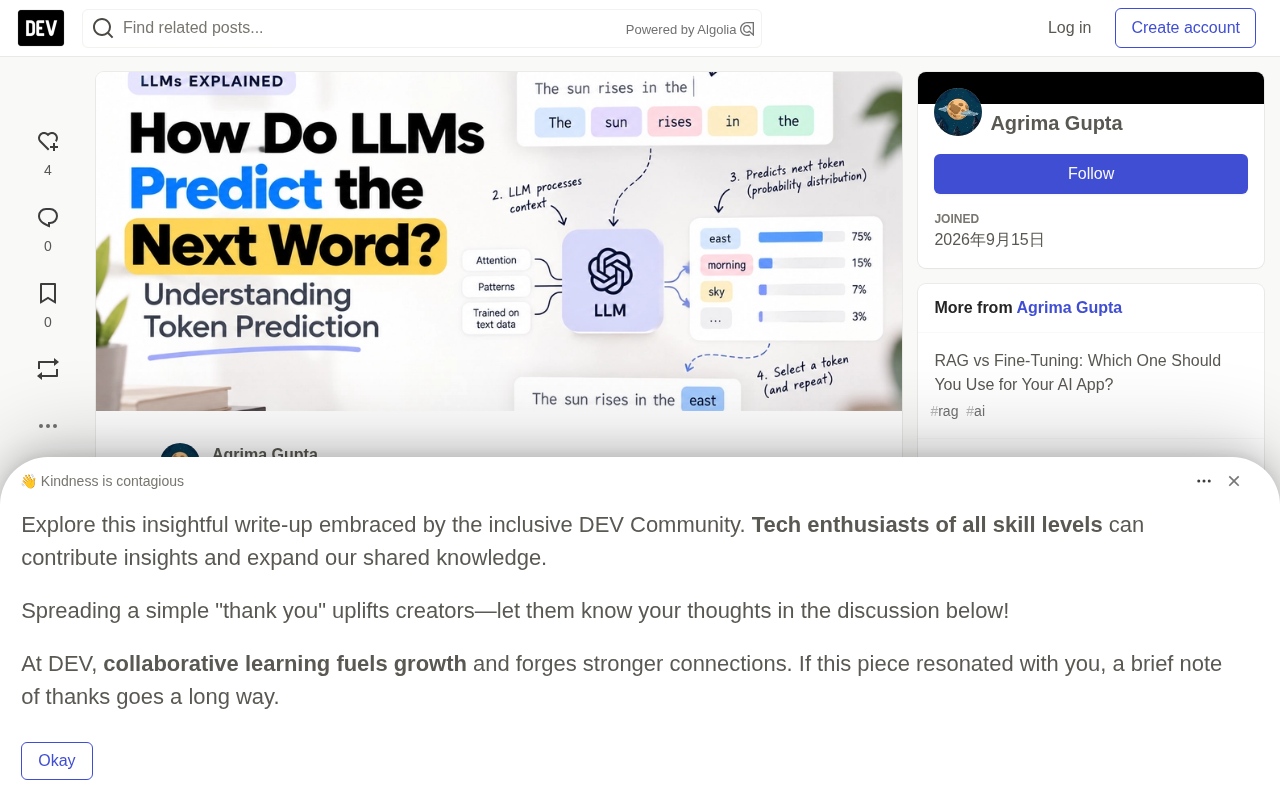
这个说法听起来简单,甚至有点"扫兴",但它恰恰是理解现代对话式AI的关键入口。本文将从token的定义、预测流程、训练来源、采样策略几个层面,把这条看似朴素的机制拆开讲清楚。
Token不是单词:大模型的最小处理单位
我们习惯说LLM在预测下一个"词",但这个表述并不准确。大多数LLM实际处理的是token——它可以是一个完整单词、单词的一部分、标点符号,或者一段其他文本片段。
以句子 Machine learning is fascinating! 为例,它可能被切分成类似 ["Machine", " learning", " is", " fascinating", "!"] 的token序列。具体的切分方式取决于模型所使用的tokenizer(分词器)。
为什么不直接以完整单词为单位?因为tokenization让模型能够用一套可控规模的词表,同时覆盖常见词、生僻词、标点和多语言文本。如果只用完整单词,词表会膨胀到难以管理的程度,而遇到未见过的词时模型就会束手无策。所以当我们说"预测下一个词"时,严格来说是在说"预测下一个token"。
分词器(tokenizer) 是大模型处理文本的入口组件,其核心算法常见的有 BPE(Byte Pair Encoding,字节对编码)、WordPiece 和 SentencePiece 等。以 BPE 为例,它从单个字符出发,反复统计语料中最高频的相邻符号对并将其合并为新符号,经过多轮迭代后形成一个兼顾常见词整体保留与生僻词拆分为子词的词表。这种数据驱动的构造方式使得 tokenizer 的词表规模通常控制在数万到十余万之间,同时保证任何输入文本都能被切分为词表内的 token 序列(极端情况下退化为字节级切分)。值得注意的是,tokenizer 一旦训练完成就固定下来,模型训练和推理必须使用同一个 tokenizer,否则 token 与模型参数之间的对应关系会被破坏。不同模型家族(如 GPT 系列、Llama 系列)的 tokenizer 各不相同,因此同一句话在不同模型下的 token 数量和切分方式可能差异明显。
预测是怎么发生的:从概率分布到逐个生成
假设你输入 The sun rises in the ...,接下来可能是什么?east、morning,还是别的什么?
模型会处理你提供的文本,基于训练中学到的模式,估算各个候选token作为下一个token的概率。原文给出了一个简化示例(明确说明数字仅作说明、并非真实模型输出):
| 可能的下一token | 示例概率 |
|---|---|
| east | 75% |
| morning | 15% |
| sky | 7% |
| 其他token | 3% |
模型根据生成策略从中选择一个token。如果选中 east,文本就变成 The sun rises in the east。关键在于,它不会就此停止——而是用更新后的文本再次预测下一个token,如此循环往复。
整个流程可以概括为一个循环:
输入Prompt
    ↓
处理已有Token
    ↓
计算下一Token概率
    ↓
选择一个Token
    ↓
加入文本
    ↓
再次预测
    ↓
直到生成停止
当你问"用简单的话解释机器学习"时,模型就是一个token接一个token地生成,每个新token都会成为后续预测的上下文。一段完整的回答,就是这样由单次预测不断累积而成。
这些概率从哪来:训练与Transformer架构
LLM并不是一开始就内置了所有可能答案的清单。在训练过程中,它处理海量文本,学习token之间如何基于上下文产生关联的统计模式——哪些词经常一起出现、句子如何组织、解释性文字怎么写、问题通常如何被回答。
现代LLM普遍采用Transformer架构,通过self-attention(自注意力)等机制处理token之间的关系。训练时,模型不断调整内部参数以提升预测准确度,逐渐学到能生成有用文本的复杂模式。
原文特别强调,这比"查找最常见的下一个词"要复杂得多:预测结果依赖于上下文以及模型参数中编码的模式,而不是简单的频率查表。
Self-attention(自注意力) 是 Transformer 的核心运算:对于序列中的每个 token,模型会将其映射为 Query、Key、Value 三组向量,然后用该 token 的 Query 与所有 token 的 Key 做点积并归一化,得到一组注意力权重,再据此对所有 Value 加权求和。这样每个位置的表示都能直接聚合序列中任意位置的信息,而不像循环神经网络那样必须逐步传递。多头注意力(multi-head attention)则并行运行多组这样的运算,让模型同时关注不同类型的关联模式。此外,由于自注意力本身不包含顺序信息,Transformer 需要额外注入位置编码(positional encoding),使模型能够区分 token 的先后次序——这对"预测下一个 token"至关重要,因为语法和语义高度依赖词序。
用一个Python小程序感受"预测"的本质
为了直观理解,原文给出了一个不依赖神经网络的极简例子——用词频统计做下一词预测:
from collections import defaultdict, Counter

sentences = [
    "machine learning is useful",
    "machine learning is powerful",
    "machine learning is fascinating",
    "deep learning is powerful"
]

next_words = defaultdict(Counter)

for sentence in sentences:
    words = sentence.split()
    for i in range(len(words) - 1):
        next_words[words[i]][words[i + 1]] += 1

context = "machine learning is"
last_word = context.split()[-1]
print(next_words[last_word].most_common())
输出为 [('useful', 1), ('powerful', 1), ('fascinating', 1)]。这个小程序统计了训练句子中 is 后面跟着哪些词,由于三个候选在这个极小数据集里各出现一次,计数相同。
原文明确提醒:这并不是现代LLM的内部工作方式,它只是演示"利用此前观察到的模式来估计下一个可能内容"这一核心思想。真实LLM使用的是学习到的神经网络参数,在其token词表上生成带上下文的概率分布。
为什么ChatGPT每次回答都不一样?
如果模型估算的是概率,为什么不总是选概率最高的那个?因为文本生成可以采用不同的采样策略。
使用贪心解码(greedy decoding) 时,模型每一步都选择得分最高的token;而使用采样(sampling) 时,模型会按概率在候选token中做选择。
其中一个常见设置是temperature(温度),它改变采样时token概率分布的集中或分散程度。较低温度通常让选择更可预测,较高温度则通常允许更多变化。回答事实性问题时,你可能希望输出更稳定;写创意故事时,你可能想要更多样的表达。
有意思的是,temperature并不会给模型"增加知识",它改变的只是token的选择方式。
除 temperature 外,还有两个常被提及的采样参数。top-k 采样在每一步只保留概率最高的 k 个候选 token,再在这 k 个中按概率重新归一化后采样,从而直接截断长尾的低概率候选;top-p(nucleus)采样则动态选取累积概率达到 p 的最小候选集合,候选数量随分布形态自适应变化。实践中常见做法是同时设置 temperature 与 top-p。另外,模型输出的原始分数是 logits,需经 softmax 函数转换为概率分布,temperature 正是在 softmax 之前对 logits 做缩放:温度趋于 0 时分布趋于尖锐(接近贪心),温度升高则分布趋于平坦。这解释了为什么 temperature 只改变选择方式而不改变模型所学到的知识。
只会预测token,是不是意味着它什么都不理解?
这是最值得深思的问题。
下一token预测确实描述了许多LLM训练与生成文本的基本方式。但要在多样化的上下文中学会预测token,模型可能需要在内部参数中表征语法、概念、关系乃至世界的某些方面。
另一边,流畅的文本并不能证明每句话都真实,也不能证明模型的理解方式与人类完全一致。LLM可以给出令人信服的答案,同时犯下事实错误。它的输出取决于训练数据、上下文、模型设计和生成过程。
把这两面都放在一起看,才能对"预测下一个token"这个机制有恰如其分的认识:它既是理解现代对话式AI的基础,也提醒我们不要过度神化模型的能力边界。
核心要点
- LLM处理的最小单位是token而非单词,token可以是词、子词、标点或文本片段,具体切分由tokenizer决定。
- 生成过程是一个循环:处理上下文→计算下一token概率→选择token→加入文本→再次预测,直到停止。
- 预测能力来自大规模训练中学习到的统计模式,Transformer架构的self-attention帮助模型捕捉token间关系。
- temperature等采样策略决定token如何被选中,但不会为模型增加知识,只改变选择的随机性。
- 下一token预测不等于"什么都不理解",但也绝不保证输出真实无误,流畅与正确是两回事。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。