LLM验证器跨抽象边界可靠性测试:抽象导致31%判断失效

LLM验证器在抽象边界下判断传输失败率高达31%,恢复溯源可修复85.5%的失败。
研究提出“Verification Transport”框架,系统测量LLM验证器在执行证据跨越抽象边界时的判断一致性。实验构建同一冻结执行过程的原生、抽象和恢复三种视图,覆盖四个基准、七种验证器骨干和四种协议。结果显示,在宏抽象和委派边界下,传输失败率高达约31%,即近三分之一判断发生改变。不同协议失效模式不同:直接验证更易产生错误判定,证据 grounded 和审议式协议倾向弃权,因此较低失败率不必然代表更高可靠性。恢复执行溯源可修复85.5%的传输失败,但溯源有损时恢复率下降。研究建议在多种抽象视图下测试验证器,并将传输失败率纳入可靠性指标。
LLM驱动的验证器正成为评估智能体执行质量的重要工具,但其可靠性通常只在单一轨迹表示下被衡量。现实部署中,同一执行过程常常通过组合工具、委派边界或压缩历史来呈现,验证器能直接观察到的证据随之改变。那么,当执行证据跨越抽象边界时,验证器的判断还能保持一致吗?一项名为“Verification Transport”的研究首次系统性地测量了这一问题。
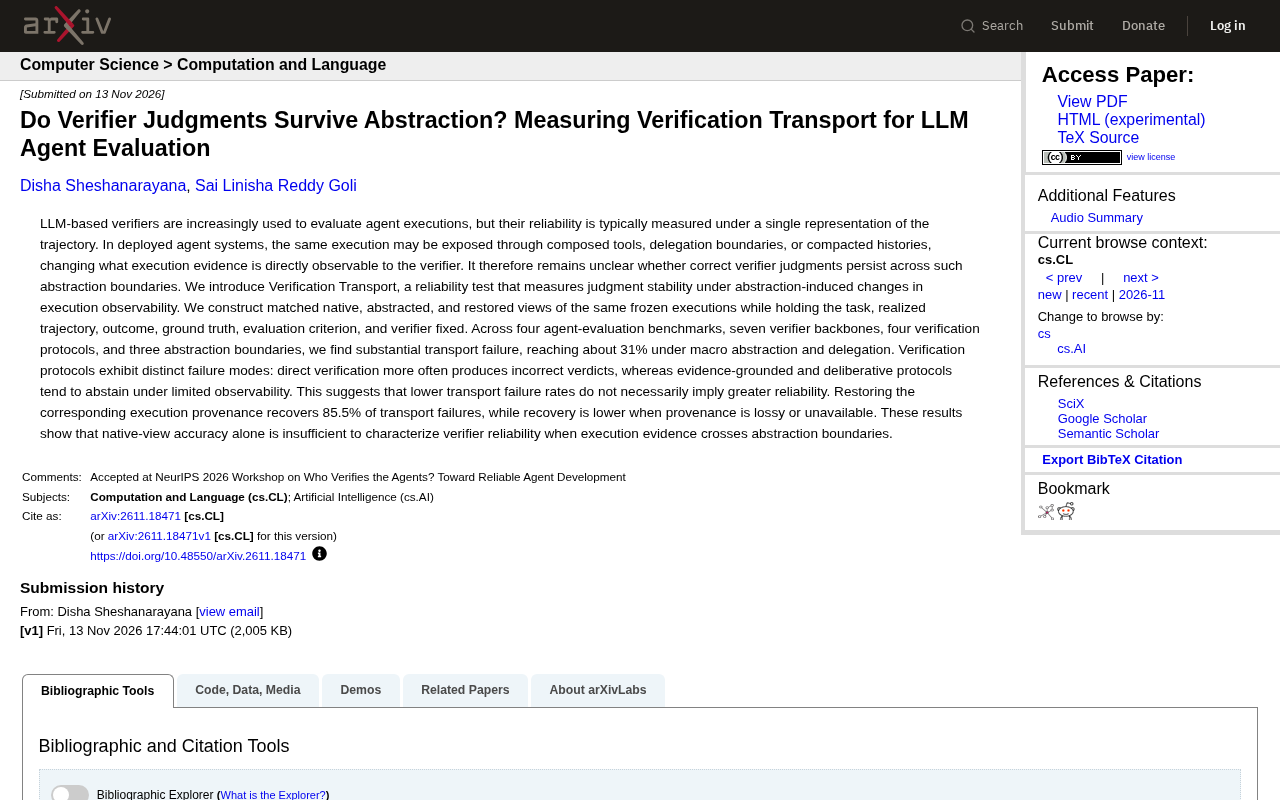
抽象边界如何破坏验证可靠性
研究团队构建了同一冻结执行过程的三种视图:原生视图(native)、抽象视图(abstracted)和恢复视图(restored)。在保持任务、轨迹、结果、真实标签、评估标准和验证器固定的前提下,他们测量判断在抽象诱导的观察性变化下的稳定性。
实验覆盖四个智能体评估基准、七种验证器骨干、四种验证协议和三种抽象边界。结果显示,在宏抽象和委派边界下,传输失败率高达约31%。这意味着,即使验证器在原生视图下表现良好,一旦执行证据被抽象,近三分之一的判断会发生改变。
这一发现对智能体评估实践构成直接挑战。当前多数评估流水线默认验证器在压缩或组合视图下仍能保持判断一致,但数据表明这一假设并不成立。
宏抽象(macro abstraction) 与 委派边界(delegation boundary) 是本文实验中最主要的两种抽象边界类型。宏抽象指将多个低层工具调用或步骤合并为一个高层语义单元(例如把“读取文件—解析内容—提取字段”压缩为“提取字段”),从而减少验证器可见的中间状态。委派边界则出现在多智能体系统中:主智能体将子任务交给子智能体执行,验证器若只观察主智能体的轨迹,就看不到子智能体内部的决策与证据。这两类边界都会改变验证器可直接观察到的证据集合,是导致传输失败的主要来源。理解它们的区别有助于判断在何种系统架构下验证器最易失效。
不同验证协议的失败模式差异显著
研究揭示了验证协议在抽象下的不同失效方式。直接验证(direct verification)更常产生错误判定——验证器在信息不完整时仍强行给出结论。而基于证据的协议和审议式协议(evidence-grounded and deliberative protocols)在观察性受限时倾向于弃权(abstain),而非冒险给出错误答案。
这一差异带来一个反直觉的结论:较低的传输失败率并不必然意味着更高的可靠性。直接验证可能因为“总是给出答案”而显得失败率较低,但其中包含的错误判定更多;审议式协议虽然弃权率上升,却避免了错误结论。评估验证器时,必须区分“错误”与“弃权”两种失败模式。
弃权(abstain) 指验证器在证据不足或观察受限时选择不给出“通过/不通过”的二元判定,而是输出“无法判断”或要求更多信息。在本文的语境中,弃权是一种被显式允许的协议行为,与错误判定相对。直接验证协议通常被设计为必须给出结论,因此即使面对被抽象压缩的轨迹也会强行判定,导致错误率上升;而证据 grounded 协议要求判定必须有可追溯的证据支撑,审议式协议则通过多轮推理检查证据充分性,二者在观察性受限时更可能弃权。评估时若只统计“判定错误率”而忽略弃权率,会系统性高估直接验证协议的可靠性。
恢复执行溯源可挽回大部分失败
研究进一步测试了恢复执行溯源(execution provenance)的效果。当对应的溯源信息被恢复时,85.5%的传输失败得以修复。然而,当溯源信息有损或不可用时,恢复率显著降低。
这一结果指向一个工程实践方向:智能体系统在设计抽象机制时,应有意识地保留可恢复的溯源线索。组合工具调用、委派链和压缩历史不应丢弃原始执行证据的映射关系,否则验证器将永久失去做出正确判断所需的信息。
对智能体评估的启示
这项研究传递的核心信息是:原生视图下的准确率不足以刻画验证器的可靠性。当执行证据跨越抽象边界时,验证器可能系统性地失效。对于构建智能体评估体系的团队,这意味着需要在多种抽象视图下测试验证器,并将传输失败率纳入可靠性指标。
同时,验证协议的选择需要与抽象程度匹配。在高抽象、低观察性的场景下,强制给出判定的协议可能带来更多错误;允许弃权并保留溯源的协议虽然看似“保守”,却更可能维持判断质量。
随着智能体系统日益复杂,抽象边界不可避免。验证器能否跨越这些边界保持判断一致,将直接影响评估结果的可信度。Verification Transport提供了一个可操作的测试框架,值得在部署验证器前纳入评估流程。
相关推荐

AI代打电话?Muse让语音助手替你预约
Muse推出AI代打电话功能,仅限美国付费订阅用户。本文分析语音助手切入电话场景的产品逻辑、付费墙策略与语音代理的想象空间及隐私隐忧。
谷歌PaperOrchestra:多智能体框架自动化写AI论文
谷歌研究院开源 PaperOrchestra 多智能体框架,将 AI 研究论文写作拆解为文献、方法、实验等子任务,由不同智能体协作编排完成,GitHub 已获 2093 星,今日新增 313 星。

Marimba:0.6B小模型如何用单一编码器处理语音问答
Marimba 是一个基于 Qwen3-ASR-0.6B 编码器的轻量语音问答模型,支持流式处理、本地运行,可作为轮次检测器接入 Pipecat、LiveKit 和 Vapi,在特定任务上超越大模型。