LLM重排序器全程静默失败:120 tokens引发的AI测试盲区

一个LLM重排序功能因max_tokens被思考耗尽而静默失效,测试全绿却从未运行。
schemagate 作者记录了一次典型的 LLM 静默失败:重排序功能因 `max_tokens=120` 被 Claude 5 系列的 thinking 过程全部消耗,模型从未产出回答,而捕获异常的 fallback 又悄然返回数学排序结果,导致功能 100% 失效却无任何外部表现。问题根源不在模型或测试质量,而在于测试套件只验证了"失败是安全的",从未验证"模型确实给出了回答"。修复后(max_tokens 提升至 1024、加入拒绝低预算的 fake model、记录模型是否作答),reranker 在 Spider 和 BIRD 上的正确表命中率分别从 80.3%/88.6% 跃升至 96.5%/96.7%,McNemar 检验 p 值达 1e-49。核心教训是:安全 fallback 必须记录触发日志,测试需覆盖成功路径。
一个看似完备的LLM重排序功能,在测试全绿的情况下实际上从未运行过。schemagate作者记录了一次典型的"静默失败"事故——问题不在模型,而在测试只验证了失败是安全的,从未验证成功是否真的发生。
schemagate是什么
schemagate解决的是text-to-SQL场景中的一个核心痛点:当数据库有数百张表时,应该让模型看到哪几张。
它的做法是先用纯数学方法筛选——BM25、embedding、表名匹配——再通过RRF(Reciprocal Rank Fusion)融合排序。如果用户提供了API key,系统会调用LLM对前20个候选表重新排序,这就是reranker环节。
这个架构的出发点很合理:数学方法成本低、确定性高,LLM则在模糊语义上更擅长。用数学先粗筛、LLM再精排,是当前RAG和检索系统中常见的混合策略。
RRF(Reciprocal Rank Fusion,倒数排名融合) 是一种无需训练即可组合多个排序结果的经典方法。它对每个候选文档在每一路召回中的排名取倒数(常用公式为 1/(k + rank),k 通常取 60),再把同一文档在多路结果中的得分相加得到最终分数。其优点是不同检索器返回的分数尺度差异(例如 BM25 的分数范围与余弦相似度完全不同)被彻底绕开,只依赖排名,因此鲁棒且无需归一化。在 schemagate 中,BM25、embedding、表名匹配三路各自给出候选表列表,RRF 负责把它们融合成一个统一的粗筛顺序,再交给 LLM 精排。理解 RRF 有助于把握整条流水线:它决定了 LLM reranker 能看到的候选集边界——如果某张正确的表在 RRF 阶段就掉出前 20,后续靠 LLM 重排也无法挽回。
事故现场:三次调用,零次回答
作者用同样的三个问题,分别在开启和关闭--rerank的情况下测试,使用的是claude-haiku-5-5。三次结果完全一致。
一致的排序结果本身不是问题——如果数学方法已经排对了,重排序自然不会改变结果。作者因此加了日志,包裹provider层记录每次调用。
日志显示:模型确实被调用了。但它从未给出任何回答。
根因:120 tokens全被"思考"吃掉了
问题出在一行代码上:
reply = provider.complete(SYSTEM, prompt, max_tokens=120)
对于一个只需要返回3, 1, 7, 2, 5这样的排序结果,120 tokens绰绰有余。写代码时确实是够用的。
但Claude 5系列模型在回答前会先进行内部推理(thinking),这部分推理消耗的token同样计入max_tokens。120个token全部被思考过程用完,模型在写出第一个数字之前就被截断了。
provider层抛出了错误。reranker按设计捕获了它:
except Exception:
    return list(docs)   # never worse than the maths alone
然后返回数学排序结果。没有崩溃,没有警告,用户看到的和没开--rerank完全一样。
Extended Thinking(扩展思考)与 max_tokens 的关系 是理解此类故障的关键。Anthropic 的 Claude 3.7 及之后系列引入了 thinking 能力:模型在给出最终可见回答前,会生成一段内部推理内容。在 API 层面,这段推理(以 thinking block 形式返回)与最终回复共享同一个 max_tokens 预算。也就是说,max_tokens 是"思考 + 输出"的总量上限,而非仅限制可见回复的长度。如果思考阶段就把预算耗尽,模型会在未写出任何答案前被截断,API 可能返回不完整响应或直接报错。许多早期为纯补全模型编写的代码把 max_tokens 设得很小(如 120),在切换到带 thinking 的模型后就会无声无息地失效。规避方法通常是显式提高 max_tokens,或使用独立的 thinking.budget_tokens 参数为推理单独分配预算。
为什么测试没抓住这个bug
tests/test_rerank.py的测试质量并不差:
- 模型报错时,排序不变 ✓
- 模型返回垃圾内容时,排序不变 ✓
- 模型不能提升调用者无权访问的表 ✓
全部通过。
问题在于:每一个测试验证的都是"失败是安全的",没有任何一个测试验证"模型确实给出了回答"。
当fallback机制被设计成对用户完全透明时,100%的功能失效和正常运行在外部表现上完全一致。这是AI系统中一类特别隐蔽的故障模式——不是崩溃,而是悄悄退化到降级路径。
静默降级(Silent Degradation)与可观测性 是这类故障背后的通用模式。当一个功能的 fallback 被设计为对用户完全透明时——例如捕获异常并返回一个"永远不会更差"的基线结果——系统在外部行为上就抹平了正常运行与彻底失效的差异。这类故障不会触发崩溃告警,也不会改变 API 返回结构,只会让质量悄悄退化到基线水平。在 AI 系统中它尤其常见,因为模型调用本身具有随机性,结果波动容易被误认为"本来就该这样"。对抗手段是把"降级路径是否被触发"提升为一级指标:用结构化日志、计数器或 trace 记录每次 fallback、每次模型空回复、每次超时。只有当降级的触发次数出现在监控面板上,绿色才代表真正健康。
修复方案
三处改动堵住了这个漏洞:
max_tokens从120提升到1024。 给thinking和输出都留足空间。
测试中加入了fake model,当max_tokens低于512时拒绝回答。 如果有人再次调低这个值,测试会直接失败——把"模型必须有机会回答"变成了可执行的约束。
benchmark现在记录模型是否在每个问题上给出了回答,而不仅仅记录最终分数。
作者在已发布的PyPI包上验证了修复效果:1.4.4版本3个问题中只有1个得到模型回答,改变了0个排序;1.5.0版本3个问题全部得到回答,改变了2个排序。
修复后的真实性能
功能真正跑通后,作者第一次在公开benchmark上测量了reranker的效果。测试条件相当严苛:Spider dev的全部876张表和BIRD dev放在同一个池子里,模型不知道问题属于哪个数据库。一张表只有全部出现在正确SQL用到的表集合中,才算命中top 5。
| 数据集 | 问题数 | 纯数学排序 | 重排序后 | 仅重排序正确 | 仅数学正确 |
|---|---|---|---|---|---|
| spider | 1034 | 80.3% | 96.5% | 169 | 1 |
| bird | 1534 | 88.6% | 96.7% | 125 | 1 |
配对McNemar检验,Spider上p值约1e-49,BIRD上约1e-36。这是benchmarks文件中最大的单项提升。
需要明确这些数字的边界:衡量的是正确表是否进入了prompt,而非最终SQL是否正确;仅使用了一个模型;Spider和BIRD是公开数据集,模型可能在训练中见过;reranker只重排数学方法已经入选的表,且它看到的是表名和简短摘要,不是答案SQL。
最大的收获
应该测试的是"模型有机会回答",而非"模型没回答时安全"。如果你的功能依赖一个可能静默降级的fallback,日志里必须能看到它何时被触发。否则功能可以100%损坏,你的仪表盘依然一片绿色。
schemagate可以通过pip install "schemagate[ai]"安装体验,MCP server中设置SCHEMAGATE_MCP_RERANK=1即可启用重排序。代码和完整benchmark在GitHub上开源。
相关推荐
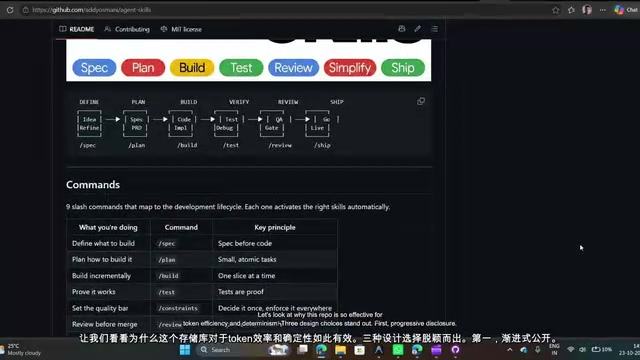
别再往CLAUDE.md塞两万行:10个技能砍掉上下文成本
与其往CLAUDE.md塞两万行规则,不如用渐进式披露的技能体系。本文拆解10个Claude Code技能:Addy Osmani Agent Skills、Graphify语义知识图谱、Superpowers子代理编排、LSP插件等,教你削减token成本并提升代码质量。

苹果iPhone Duo折叠屏开箱:万元级新物种值不值?
苹果首款折叠屏iPhone Duo开箱上手:顶配近5000加元,哑光内屏成最大亮点,折痕控制出色,护照式宽矮比例引领新形态。本文梳理屏幕、铰链、手感和价格的完整体验。
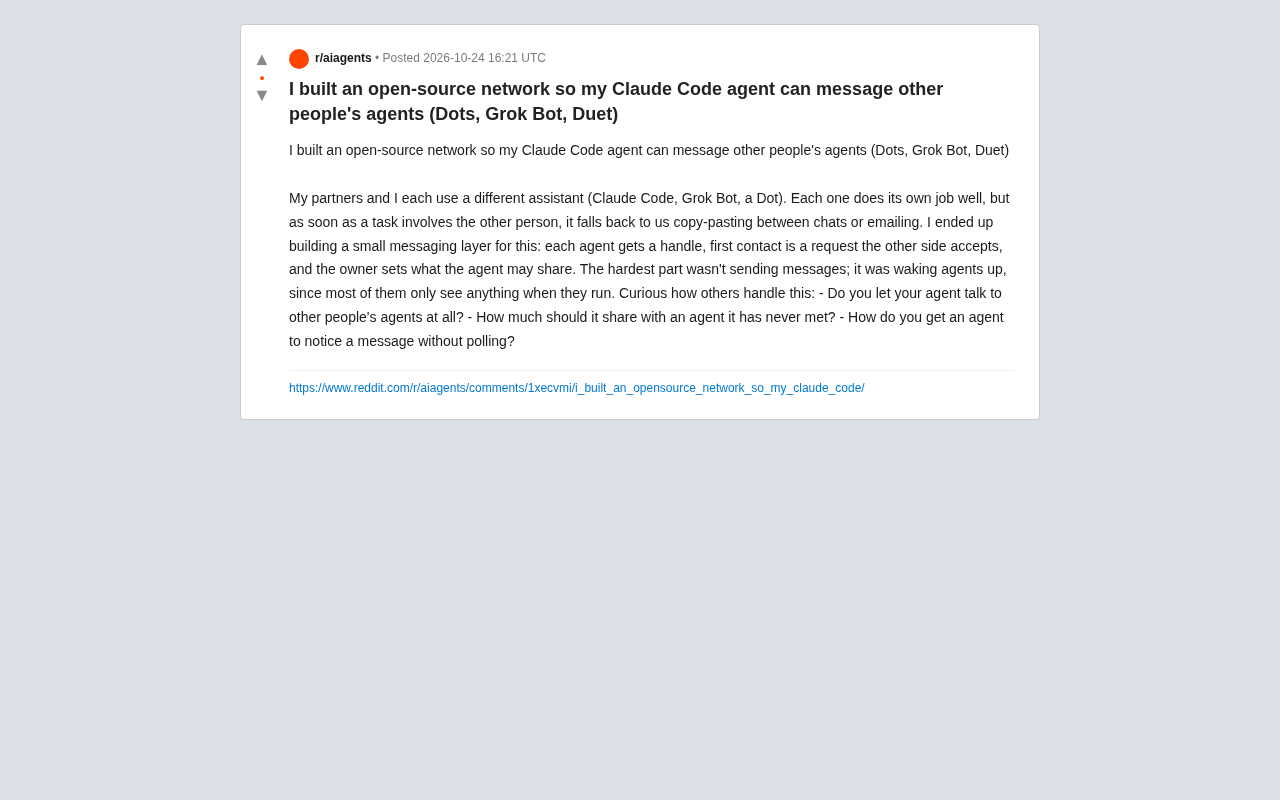
开源智能体消息网络:让Claude Code与其他AI助手直接对话
开发者构建开源消息层,让Claude Code、Grok Bot等AI智能体直接通信。项目采用句柄与握手机制控制权限,但唤醒休眠智能体成为最大技术挑战。探讨智能体互操作性的未来与信任边界。