LLM重试如何省Token?大上下文Agent工作流的优化策略
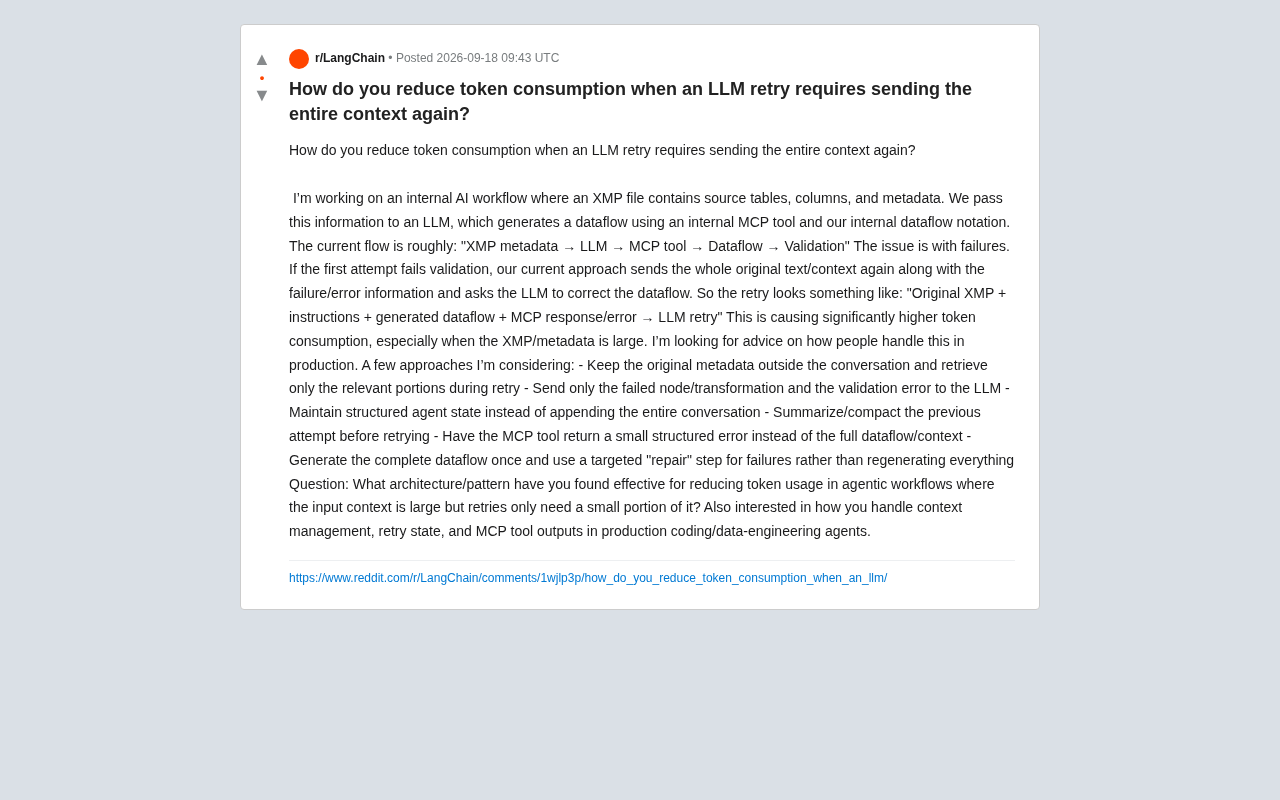
LLM重试时全量重发上下文导致Token暴涨,解法是将生成与修复解耦并配合外置检索与结构化状态管理。
在生产级AI Agent工作流中,LLM生成结果验证失败后的重试策略往往隐藏着高昂的Token成本——每次将完整上下文重新发送,会使消耗成倍膨胀。文章以XMP元数据处理工作流为例,揭示了"大输入生成 vs 小范围修复"这一核心矛盾:生成阶段需要完整元数据,但修复往往只涉及局部节点。针对这一问题,文章梳理了六种优化路径,包括上下文外置检索、只发送失败节点、结构化状态管理、历史摘要压缩、精简MCP工具输出以及生成与修复分离。综合来看,最有效的生产模式是将"重上下文生成"与"轻量定向修复"作为两类不同操作解耦处理,配合可寻址的外部存储和结构化状态驱动,才能在保证质量的同时将重试成本压至最低。
在构建生产级AI Agent工作流时,一个常被忽视却代价高昂的问题浮出水面:当LLM生成结果验证失败、需要重试时,如果每次都把完整上下文重新塞回去,Token消耗会迅速膨胀。一位工程师在Reddit上分享了他遇到的真实困境,并抛出了一系列可能的解决方案,引发了对Agent上下文管理的深入讨论。
问题场景:验证失败后的重试黑洞
这位开发者正在搭建一个内部AI工作流,用于处理XMP文件——其中包含源表、列以及元数据。整体流程大致是:
XMP元数据 → LLM → MCP工具 → 数据流(Dataflow) → 验证
痛点集中在失败处理环节。当首次生成的数据流未能通过验证时,当前的做法是把原始文本上下文全部重发,再附上错误信息,让LLM重新修正。也就是说,重试请求变成了:
原始XMP + 指令 + 已生成的数据流 + MCP返回的错误 → LLM重试
当XMP元数据体积很大时,这种"全量重发"策略会导致Token消耗成倍增长。一次验证失败可能只涉及某个节点的小错误,却要为整个上下文再次付费——这在生产环境中既不经济也不优雅。
核心矛盾:大输入 vs 小修复
这个问题的本质,是Agent工作流中一个普遍存在的结构性矛盾:输入上下文很大,但重试通常只需要其中一小部分。
生成阶段确实需要完整的元数据来理解表结构和字段关系,但修复阶段往往只针对某个失败的转换节点。把整个上下文当作"原子单位"反复传递,等于在每次微调时都重新支付一次全量成本。识别并打破这种绑定,是优化的关键切入点。
六种候选优化路径
原帖作者列出了他正在考虑的几个方向,每一个都对应着不同的架构取舍:
1. 上下文外置 + 按需检索
把原始元数据保留在对话之外(例如存入外部存储或向量库),重试时只检索相关的那部分。这本质上是把RAG思想引入重试环节,避免让静态大文本占据对话窗口。
RAG(Retrieval-Augmented Generation,检索增强生成)是一种将外部知识库与LLM结合的架构模式:在推理时根据当前问题动态检索相关片段,而非把全部知识预先塞入上下文。将这一思想迁移到重试场景时,原始的XMP元数据或表结构文档会被切分、向量化后存入向量数据库(如Pinecone、Weaviate或pgvector),重试请求仅附带与失败节点相关的若干片段,而非整份元数据。这样做的代价是需要维护一套检索管道,且检索质量直接决定修复效果——如果相关上下文未被召回,LLM可能因信息不足而生成错误的修复方案。因此,检索策略(如相似度阈值、召回数量)需要与验证错误的粒度对齐调优。
2. 只发送失败节点与验证错误
不再回传整个已生成的数据流,而是精准定位到出错的那个节点或转换,连同验证错误一起发给LLM。这是最直接的"减法",前提是错误信息能够被精确定位到局部。
3. 维护结构化Agent状态
用结构化的状态对象来管理流程,而不是简单地把整段对话不断追加(append)。结构化状态让你可以选择性地组装每次请求所需的字段,而非线性堆积历史记录。
结构化Agent状态的思想来源于状态机(State Machine)设计范式。与普通对话历史的线性追加不同,状态机将流程中的关键变量——如当前节点、已验证通过的转换列表、待修复的失败节点集合——显式地建模为可查询、可更新的字段。LangGraph、LlamaIndex Workflows等主流Agent框架均提供了内置的状态管理抽象,允许开发者定义每个节点的输入输出模式。在重试场景中,框架可根据状态中的failed_nodes字段自动裁剪请求上下文,只传入必要字段,而不是把整个messages列表原样复制给下一次LLM调用。这种方式还天然支持断点续跑和可观测性,是生产级Agent工作流的推荐基础设施。
4. 摘要压缩历史尝试
在重试前对上一次的尝试做摘要或压缩(compact),保留决策要点,丢弃冗余细节。这在长对话Agent中是常见手法,但需注意压缩可能丢失关键约束。
5. 让MCP工具返回精简的结构化错误
改造MCP工具,让它返回一个小而结构化的错误对象,而不是把完整的数据流或上下文再吐回来。工具层的输出设计直接影响Agent循环的Token效率,这一点在实践中常被低估。
6. 一次生成 + 定向修复
完整生成数据流只做一次,之后针对失败点执行专门的"repair"步骤,而不是每次都重新生成整体。这种"生成与修复分离"的模式,把昂贵的全量操作限制在必要时刻。
生产实践中的架构思考
把这些方案综合来看,一个更健壮的生产模式其实是它们的组合:
生成与修复解耦。 首次生成是一个重上下文操作,理应消耗较多Token;但修复应当是一个轻量、局部、定向的操作。两者用不同的Prompt模板和上下文组装策略,是最值得优先落地的改造。
上下文的持久化与索引化。 原始元数据不应作为对话历史的一部分反复传输,而应作为可寻址的外部资源。LLM在修复时只需要一个引用和错误定位,加上按需拉取的相关片段。
工具输出的"最小充分性"。 MCP工具返回结果时,应遵循"够用即可"原则——只回传Agent做出下一步决策所必需的信息。结构化错误(如错误码、失败节点ID、期望值)远比整段文本高效。
状态而非对话。 用显式的状态机或状态对象来驱动重试逻辑,能让你完全掌控每次请求的Token构成,避免对话历史无限膨胀带来的隐性成本。
小结
这个案例揭示了Agent工程中一个反直觉的真相:Token优化往往不是靠更聪明的Prompt,而是靠更好的架构边界划分。 把"大上下文生成"和"小范围修复"当作两个不同性质的操作来对待,配合外置检索、结构化状态和精简的工具输出,才能在保证修复质量的同时把重试成本压到最低。对于任何在生产环境运行编码或数据工程Agent的团队来说,这都是值得认真设计的一环。
背景补充
MCP(Model Context Protocol)是由Anthropic主导推出的开放协议,旨在标准化LLM与外部工具、数据源之间的交互接口。类似于Web开发中的REST API规范,MCP定义了工具如何向模型暴露能力、如何传递调用结果。在Agent循环中,MCP工具的返回值会直接进入下一轮LLM的上下文,因此其输出体积对Token消耗有直接影响。一个设计良好的MCP工具应当将错误信息序列化为精简的结构体,例如{"error_code": "TYPE_MISMATCH", "node_id": "transform_3", "expected": "string", "got": "int"},而非返回完整的错误堆栈或原始数据流。这种设计需要在工具开发阶段就将"Agent消费效率"纳入考量,而非仅关注功能正确性。
相关推荐
Claude Code国内实战指南:从安装到MCP的完整上手路径
Claude Code 国内使用完整指南,涵盖 Windows 安装、PyCharm/VSCode 等 IDE 集成、内置命令与记忆机制、三种权限模式、MCP 工具自定义及 Skills 技能系统,帮助开发者快速上手 AI 辅助编程。
免费领取一年Google AI Pro:Gemini学生优惠保姆级教程
谷歌Gemini重开学生免费计划,新老用户均可免费领取一年Google AI Pro会员。本文梳理保姆级教程:三种页面情况处理、Plus改Pro技巧、绑卡订阅与取消自动续费全流程及风险提示。
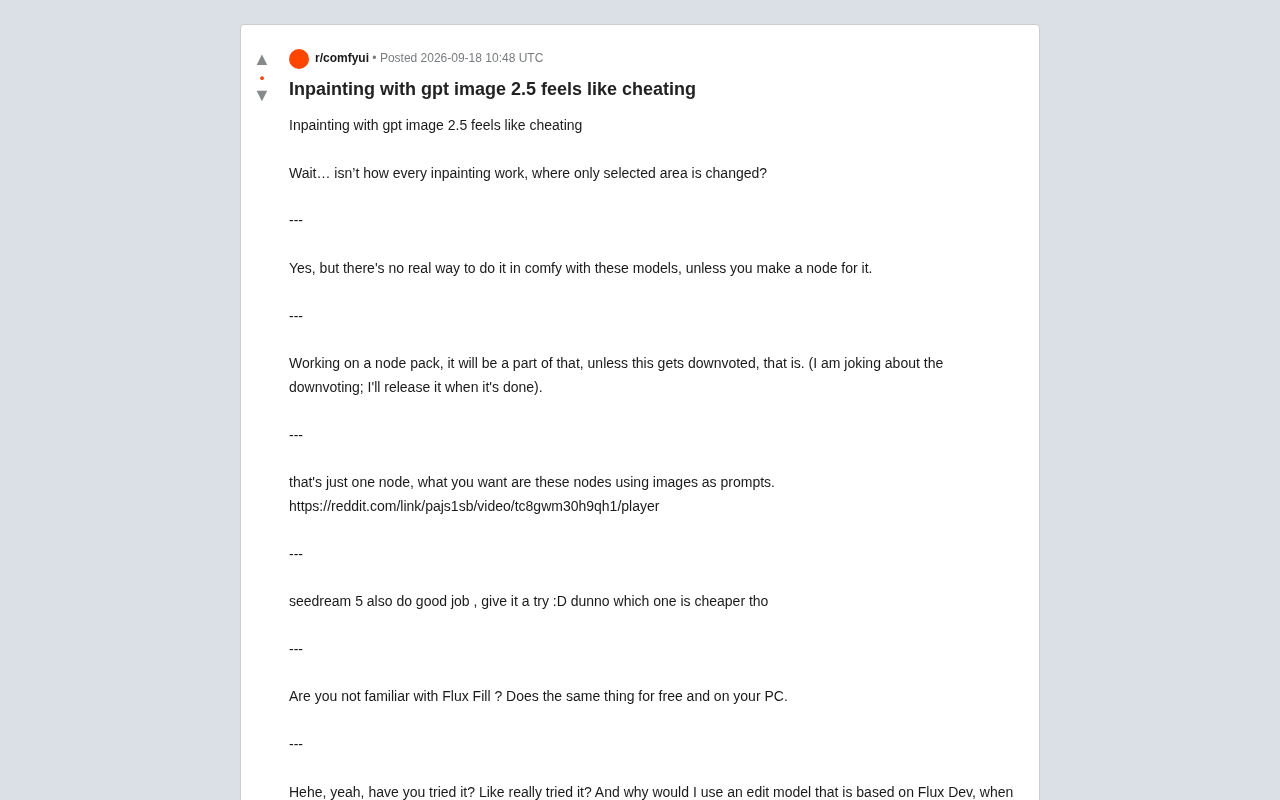
GPT Image 2.5 局部重绘实测:ComfyUI 里像开挂
Reddit 社区热议 GPT Image 2.5 局部重绘(Inpainting)效果惊艳如"开挂",本文对比其与 Flux Fill、Seedream 5 等方案的差异,并探讨如何将商业模型接入 ComfyUI 节点工作流。