Loop Engineering:让AI自动写代码并合并PR的工程范式
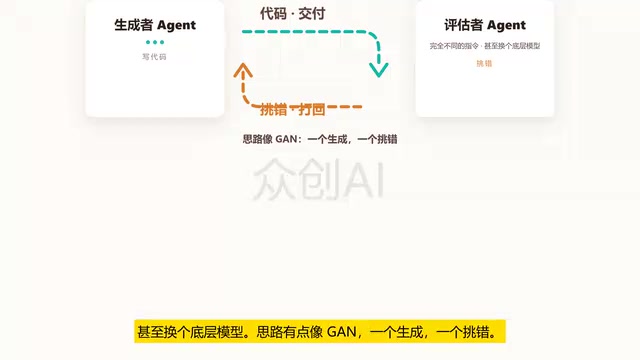
Loop Engineering 让人退到循环外做系统设计者,用独立评估者守住质量下限。
文章提出 Loop Engineering 这一正在成形的工程范式:人从循环内部的操作员转变为循环外部的系统设计者,不再逐句给 Agent 写提示词,而是构建一个能自行发现任务、分发、验证、持久化状态并调度下一轮的系统。它以 Stripe 每周合并 1300 多个机器生成的 PR 为例,说明可靠性来自确定性关卡与人工最终审查。文章拆解了一轮 Loop 的五个动作(发现、交接、验证、持久化、调度)与六个部件,强调最难的是放入一个能说「不」的独立评估者,因为生成者无法可靠地给自己打分。五种失控模式分别对应跳过某一步,并伴随验证债、理解腐烂、认知屈服、Token 爆炸四张隐形账单。最后给出三条纪律:每日抽样阅读、先设预算上限、永远保留人工介入入口。
当生成变得几乎免费,判断力就成了最稀缺的资源。Loop Engineering 不是让 AI 替你写代码,而是让你设计一个能替自己写提示词、能自我验证、能在该停时停下来的系统。
Stripe 内部有个叫 Minions 的系统,每周合并超过 1300 个 PR——不是人写的,机器自己写、自己跑测试、自己开 PR,人只负责最后看一眼。触发方式轻到在 Slack 里加个机器人或点个 emoji,剩下的系统自己转。这套实践最近有了名字:Loop Engineering。
它的核心不是某个新工具,而是一种角色转变:人从循环内部的操作员,变成循环外部的系统设计者。你写的不再是给 Agent 的下一句话,而是一个能自己发现任务、分发、验证、存状态、启动下一轮的系统。
从 Prompt 到 Loop:四层工程栈的演进
过去两年的「某某 Engineering」,可以理解为一层层往上叠的楼。Prompt Engineering 管一句话怎么写;Context Engineering 管这一轮窗口里放什么;Harness Engineering 管单次运行带哪些工具、什么算完成。这三层有个共同前提:人还坐在键盘前,一轮一轮按回车。
Loop Engineering 把这个前提干掉了。2026 年 6 月的某一周,三个人几乎同时点了火:Peter Steinberg 说别再直接给 Coding Agent 写提示词,去设计能替你写提示词的 Loop;Boris Cherney 也早就让 Loop 持续下指令;Eddie Asmani 在 6 月 7 日把这些收束成文章,正式命名。一周内同一方向,通常不是巧合,而是底层工具刚好过了某个阈值——Coding Agent 已经靠谱到能没人看管地干非平凡的活,主流工具支持了定时运行、并行隔离、子 Agent、外部连接,单次成本又低到反复跑不心疼。
一轮 Loop 的五个动作与六个部件
一轮 Loop 有五个动作:发现、交接、验证、持久化、调度。支撑它们的是六个部件:自动化、工作流、技能、连接器、子 Agent、外部记忆。
Eddie Asmani 的「早晨分诊 Loop」是个好例子:每天早上定时任务自己醒来,一个分诊 Skill 去读昨天失败的 CI、开着的 Issue、最近的 Commit,把值得处理的写进一个 Markdown 状态文件;每个问题开一个隔离的 Git WorkTree,一个子 Agent 草拟修复,另一个专门挑毛病;连接器负责开 PR、更新工单;搞不定的扔进待处理箱等人。状态文件留着,第二天接着干。没有一步需要人推着走,但它会在该等人的地方停下来。
这句话是整套东西的灵魂——好的 Loop 不是全自动,而是知道在哪里交还控制权。
Git WorkTree 是 Git 自 2.5 版本起提供的特性,允许从同一个仓库同时检出多个工作目录,每个 WorkTree 拥有独立的分支和文件状态,但共享同一份对象数据库。对 Loop 而言,这意味着多个子 Agent 可以各自在一个隔离目录里修改代码,互不覆盖彼此的编辑,也不会因为切换分支而打断正在运行的任务。这正是「交接」这一步避免「缠绕 Loop」的底层机制:隔离而不是排队,让并行成为可能。需要注意的是,WorkTree 只隔离文件系统与分支状态,不隔离网络端口、数据库或外部服务,因此多 Agent 并行时仍需在更高层做资源级隔离(如独立容器或独立测试数据库),否则冲突会从文件系统转移到运行时。
最难的部分:在 Loop 里放一个能说「不」的 Agent
Loop 最难的不是让它跑起来,而是在里面放一个能说不的东西。而写代码的那个 Agent 恰恰最不可能说不。Anthropic 的工程师 Prithvi Rajasekaran 有个扎心观察:你让 Agent 给自己刚写的代码打分,它往往自信地夸自己。这不是模型不聪明,是给自己作业打分的结构性问题——它回头看自己的输出,看到的不是结果,而是自己刚说服自己的那条推理链。
放到 Loop 里,这个问题指数级放大。如果每一轮够不够好都由刚写完代码的 Agent 自己判断,Loop 就会一轮轮点头,以机器的速度偏离真实质量。解法不是提醒它「请严格自查」,而是结构性地换个裁判:一个 Agent 写,另一个 Agent 带完全不同的指令去审查,甚至换个底层模型。思路有点像 GAN,一个生成,一个挑错。
这里有个反直觉的结论:把一个独立评估者配得足够挑剔,比让生成者对自己苛刻容易得多,因为大模型天生盲目自信。更狠的是,评估者不能只读代码——只读代码,它判断的是「看起来对不对」,不是「跑起来对不对」。所以要给它接工具,比如 Playwright MCP,让它真的打开页面、点按钮、截图、查 DOM。判断基础就从「这段 JSX 看着还行」变成「我点了按钮,页面确实跳了,这是截图」。Claude Code 的 Goal 把这个结构产品化了:给 Agent 一个明确的停止条件,每轮之后由一个新的小模型判断条件成不成立,不成立就继续下一轮,而不是把球踢回给人。
Loop 的下限由评估者决定。生成者决定它能产出什么,评估者决定它不会放过什么。
GAN(生成对抗网络) 是 Ian Goodfellow 于 2014 年提出的一类深度学习框架,由生成器(Generator)和判别器(Discriminator)两个网络组成:生成器负责制造假样本,判别器负责分辨真假,二者在对抗中共同进步,最终生成器能产出判别器难以分辨的逼真样本。这里借用其核心思想——让「生成」与「评判」由两个独立的、目标对立的角色承担。在 Loop Engineering 的语境下,写代码的 Agent 相当于生成器,审查 Agent 相当于判别器;关键不在于两个 Agent 多聪明,而在于评判者的目标与生成者的目标被结构性地区分开来,从而避免同一条推理链自己说服自己。与 GAN 不同的是,这里的判别器还要接入真实执行环境(如 Playwright MCP)来验证行为,而不是仅凭静态观察下判断。
五种失控的 Loop:跳过哪一步,就掉进哪个坑
失败比成功更常见,也更有启发。每一种失控的 Loop,都对应五个动作里某一步被跳过:
- 跳过验证 → 点头 Loop:跑几百轮,从没对自己说过不,错误以机器速度积累。
- 跳过持久化 → 健忘 Loop:窗口一刷新全忘了,每天早上都从同一个地方重新开始。
- 跳过调度 → 手动 Loop:demo 当天惊艳,人忘记跑的那天安静死掉。
- 跳过发现 → 盲目 Loop:每天还得人为任务清单,只自动化了「做」,没自动化「找」。
- 跳过交接 → 缠绕 Loop:五个 Agent 同时改同一个目录,编辑互相覆盖,合并现场一团糟。
匆忙搭出来的 Loop,最容易先装上「发现」和「交接」这两个能出可见输出的部件,然后跳过验证、持久化、调度这些真正保命的东西。看起来自动化了,其实是个没人看、没人能停、只会点头的高速垃圾生成器。
Loop 还有几张不会自己清掉的隐形账单:验证债——PR 合了不代表对了,问题藏在测试没覆盖的地方;理解腐烂——Loop 交付你没写过的代码越快,你脑子里的系统地图落后越多;认知屈服——Loop 越可靠,人越容易放弃自己的意见;Token 爆炸——一个 bug 可能整夜空转,最后留下的不是修好的代码,而是一张陌生的账单。这四个还会互相强化:越为验证的输出越多,人越不理解;越不理解,越容易放弃判断;越放弃判断,Loop 越没人看管地跑;跑得越久,花得越多,产生更多未验证的输出。
Playwright MCP 是 Microsoft 的 Playwright 浏览器自动化框架与 Model Context Protocol(MCP)结合的服务器实现。MCP 是 Anthropic 于 2024 年底提出的开放协议,用于让模型以标准化方式调用外部工具和数据源;Playwright MCP 则把「打开页面、点击、填表、截图、读取 DOM 与无障碍树」这些浏览器操作封装成模型可调用的工具。对 Loop 中的评估者来说,它的价值在于把判断基础从静态代码审查升级为真实行为验证——评估者可以亲自按下按钮并截图,确认页面是否如预期跳转,而不是推测「这段代码看起来应该能跑」。这也是「验证」环节能被结构性执行、而不依赖生成者自觉的技术前提之一。
三条纪律:把刹车装进系统里
第一,每天留一点时间抽样读 Loop 产出的东西。 强迫自己解释每个改动为什么这么做。解释不了,就是你的理解已经落后于代码库了。这个信号最好在安静的早晨发现,而不是在生产事故里。
第二,先设预算,再谈自动化。 单次预算、每日预算、最大重试次数——这些上限不是省钱,是熔断器。一个没有 cap 的 Loop,相当于把花钱权限交给了他自己的 bug。
第三,永远保留一个人工介入的入口。 不是人每次都会介入,而是他让人保留介入的能力。把每扇门都焊死的人,真正需要进去的那天,会发现自己没有钥匙。
Stripe 的 1300 个 PR 为什么可靠
回到 Stripe 的案例,它可靠的原因特别朴素:模型被夹在一堆确定性步骤之间,规则能解决的绝不交给概率模型。Linter 是硬编码关卡,Agent 跳不过去。1300 个 PR 最后仍然有人 review——人没有离开,只是从写代码的位置换到了审查的位置。
想上手的话,别一上来就学 Stripe。第一个 Loop 应该小到几乎不像个系统:先跑一个定时分诊,把发现写进状态文件,加一个独立评估者,设好预算,留好人工审查点。端到端跑通,检查机制真的抓到过一次错误,再谈扩大规模。Loop 要先证明自己能停住一个坏 Agent,才有资格运行更多 Agent。
Loop 让生成变得接近免费——代码、计划、PR、修复都可以大量产生。但判断仍然稀缺:哪个方案对,哪条线该停,哪个输出能跑但方向是错的。这些 Loop 给不了。它能生成一百个选项,但它只能判断「看起来合理」。而看起来合理和实际上正确之间那道缝隙,就是工程师往后最值钱的地方。
Loop 是个放大器。你带进去的是理解,它放大理解;你带进去的是懒惰,它放大懒惰。同一套系统,一个人用它加速自己已经掌握的工作,另一个人用它逃避理解。六个月后,后者只是自己都读不懂的机器的守门人。
所以那句话值得刻在工位上:停止亲自给 Agent 写提示词,去设计替人写提示词的系统。但要像一个打算继续当工程师的人那样去设计它,而不是像一个只想按下启动键的人。评估者、状态文件、预算上限、人类审查点,其实是同一件事的四种实现——让人保留对一台高速说 yes 的机器说 no 的能力。
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。