绿灯却空转两个月:AI Agent流水线的"成功"陷阱
一条零产出的自动化流水线靠"没有异常即成功"的判断逻辑隐身两个月
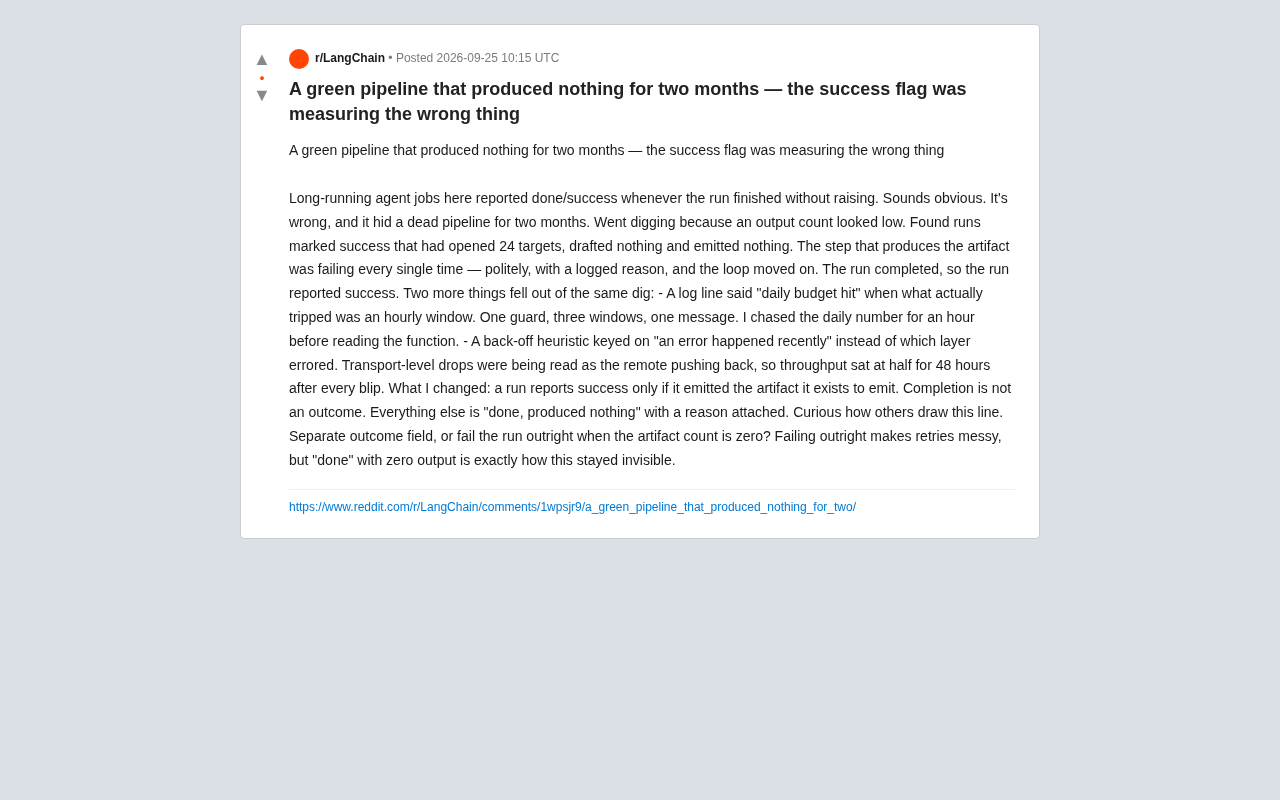
一位工程师发现他负责的 Agent 流水线连续两个月报告 success,仪表盘全绿,实际产出为零。根因在于系统把"进程正常退出"等同于"任务成功",而真正生成产物的那一步每次都在静默失败——记一条日志,然后循环继续。排查过程中还牵出两个隐蔽 Bug:一条日志写着"触及每日预算"实为小时窗口限制,误导排障整整一小时;退避机制把传输层网络抖动误判为服务端限流,每次小波动都会让吞吐量腰斩持续 48 小时。文章核心结论是"Completion is not an outcome"——成功的定义应从过程正确性转移到结果有效性,同时呼吁错误日志精确对应真实触发条件、退避策略区分错误来源,并定期用产出数据而非状态标志交叉验证系统健康度。
一条"永远成功"的流水线
一位工程师在 Reddit 上分享了一个让人后背发凉的运维故事:他负责的长时运行 Agent 任务连续两个月报告 success,仪表盘一片绿灯,但实际上什么产出都没有。
问题的根源看似平淡,却极具代表性——只要运行结束时没有抛出异常,任务就被标记为 done/success。听起来天经地义,实际上大错特错。这条逻辑掩盖了一条已经死掉的流水线整整两个月,直到作者偶然发现某个输出计数偏低,才开始深挖。
挖下去的结果触目惊心:那些被标记为 success 的运行,打开了 24 个目标(targets),却一个草稿都没写、一条结果都没输出。真正生产产物(artifact)的那一步每次都在失败——而且失败得很"礼貌":它记录了一条原因日志,然后循环继续往下走。运行跑完了,于是运行报告成功。
完成不等于结果
这个案例最核心的教训,作者用一句话点破:Completion is not an outcome(完成不是结果)。
在自动化系统里,我们常常把"进程正常退出"等同于"任务达成目标"。但这两者是完全不同的两件事。一个 Agent 的存在意义是产出某个具体的 artifact——如果它没有产出,哪怕整个流程从头到尾没有报错、优雅地跑完了所有步骤,它本质上也是失败的。
作者最终的修改方案很直接:一次运行只有在真正产出了它该产出的 artifact 时,才报告成功。 其他所有情况都归为"done, produced nothing(完成但零产出)",并附上原因。
这看似只是改了一个判断条件,实则是把"成功"的定义从过程正确性(没崩溃)转移到了结果有效性(有产出)。对任何依赖自动化 Agent 的系统而言,这个转变至关重要。
顺藤摸出的两个隐藏 Bug
在这次排查中,作者还牵出了另外两个典型的"误导性信号"问题,同样值得所有做工程的人警惕。
一条日志骗了他一小时
日志里写着 daily budget hit(触及每日预算),但实际触发的其实是每小时窗口的限制。原因是:一个守卫逻辑管着三个时间窗口(日/时等),却共用了同一条错误信息。作者盯着"每日额度"这个数字追查了一个小时,直到去读了函数源码才恍然大悟。
教训:错误信息必须精确对应真实触发条件。一条含糊的日志,可能让排障者在错误的方向上浪费大量时间。
退避策略读错了信号
更隐蔽的是退避(back-off)机制的问题。它的判断依据是"最近是否发生了错误",而不区分是哪一层出的错。结果,传输层(transport-level)的网络抖动被误读成远端服务在主动限流施压。每次出现一次小抖动,系统就以为对方在"推回",于是把吞吐量压到一半,并且持续 48 小时。
这意味着一次微不足道的网络波动,会让整条流水线的效率腰斩整整两天——而没人知道为什么。
退避(back-off)机制是分布式系统中用于应对过载或错误的一种经典策略:当系统检测到失败信号时,主动降低请求频率或吞吐量,以避免雪崩效应。最常见的是指数退避(exponential back-off),每次退避后等待时间翻倍,直到恢复正常。这一机制的前提假设是:错误信号能准确反映"对端服务在承压"。而文中描述的问题恰恰在于这个假设被打破——传输层(transport-level)的网络抖动,例如偶发的TCP超时或连接重置,与服务端主动返回的限流响应(如HTTP 429 Too Many Requests)在行为层面表现相似,却成因完全不同。前者只需短暂等待即可恢复,后者才真正需要长时间退避。当系统不加区分地把两者都视为"服务端在推回(push back)",就会对一个本质上健康的远端服务实施不必要的长时间惩罚,而根本原因可能只是一次路由抖动。
该如何划这条线?
作者在帖子结尾抛出了一个值得深思的工程设计问题:零产出的运行,到底该怎么标记?
他给出了两种思路,各有取舍:
- 独立的 outcome 字段:保留
completion状态,另设一个字段专门记录"是否产出"。好处是语义清晰,坏处是需要下游系统主动去读这个字段——否则又会退回到"只看是否完成"的老路。 - 零产出直接判失败:干脆让 artifact 数量为零的运行报告为失败。好处是简单粗暴、不会被忽略;坏处是重试逻辑会变得混乱——因为很多"零产出"其实是合理的(比如今天真的没有可处理的数据),把它们全判失败会触发不必要的重试。
作者自己也承认两难:直接判失败让重试变脏,但"done 却零产出"恰恰就是这个 Bug 隐身两个月的原因。
这一设计困境在工程实践中有一个更通用的名称:语义状态建模问题。传统的任务状态机通常只区分 pending、running、success、failed 四态,隐含假设是"成功完成"与"达成业务目标"等价。但在 Agent 化系统中,任务往往具有条件性产出——有些运行本来就可能合理地产出零结果(如今日无新数据),这使得单纯的二元成功/失败语义不再够用。引入独立的 outcome 字段,本质上是将"执行状态"与"业务结果"解耦,类似于 HTTP 协议中状态码与响应体分离的设计哲学:200 OK 只代表请求被正确处理,具体是否返回了有效内容需由调用方进一步判断。代价是下游系统必须主动消费这个额外字段,否则解耦形同虚设。
给自动化系统的启示
这个真实故事对当下大量 Agent 化、自动化的工程实践都有普适意义:
第一,成功标志要衡量结果,而非过程。 定义 success 时,问自己一句:这个任务存在的意义是什么?没达成那个意义就不算成功。
第二,错误信息必须与真实触发原因一一对应。 共用的、笼统的日志消息,是排障时间的隐形杀手。
第三,退避与重试策略要区分错误来源。 网络层抖动和服务端限流是完全不同的信号,混为一谈会导致系统对自己做出错误的"自我惩罚"。
第四,绿灯不等于健康。 定期用产出数据(而非状态标志)去交叉验证系统是否真的在工作,才能避免"看起来一切正常"的死寂。
一条永远绿的流水线,有时比一条报红的流水线更危险——因为没人会去看一个看起来正常的东西。
相关推荐
多轮对话攻破AI客服:没有恶意消息,护栏为何失效?
一次针对AI客服代理的红队测试发现:即使没有任何单条恶意消息,通过长达数十轮的缓慢对话,模型也会逐步偏离安全策略,而护栏从未触发。本文解析多轮对话越狱的机制与防御思路。
荷兰政府基于NixOS打造微软替代方案DAWO
荷兰政府推出基于NixOS的开源项目DAWO,试图替代微软办公与云生态,推进数字主权。本文解析其技术选型逻辑、摆脱供应商锁定的动因,以及社区对政府开源迁移的争议。
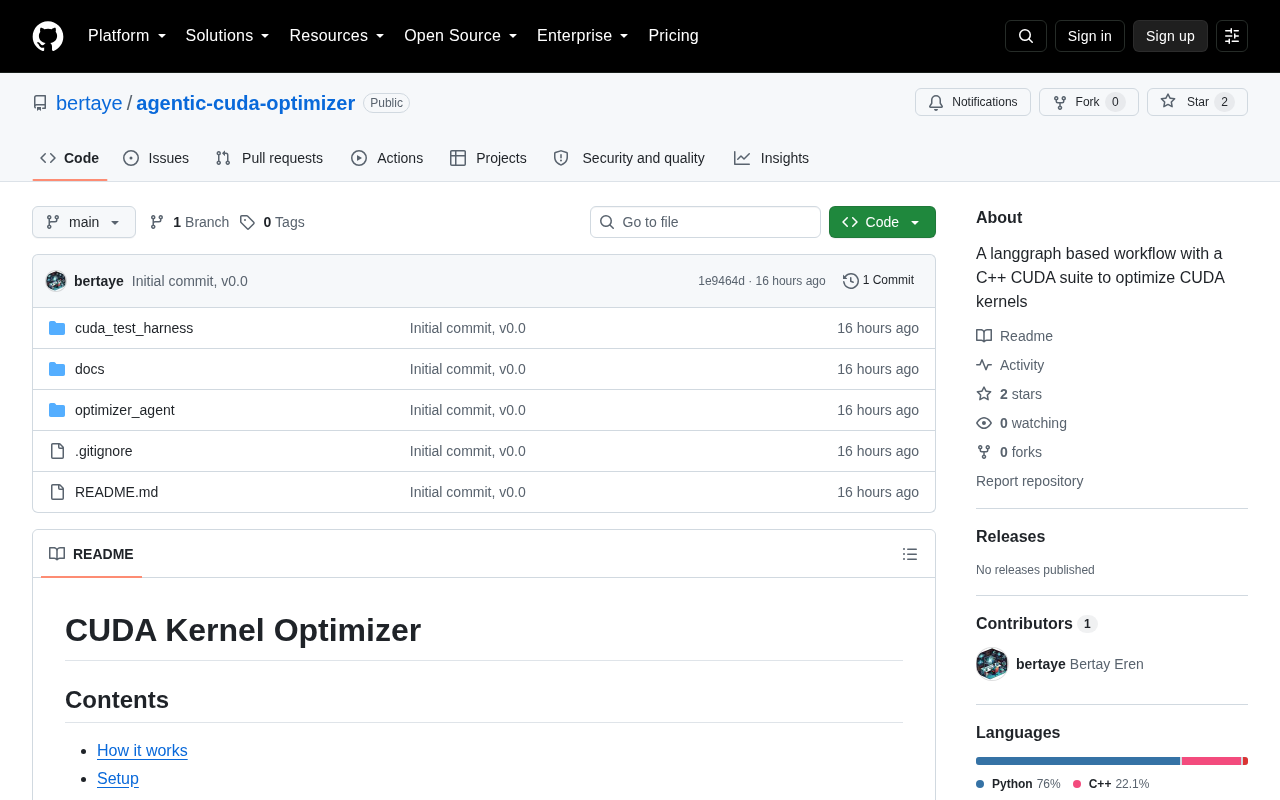
Agentic CUDA Kernel优化器:AI自动调优的新尝试
一款名为Agentic CUDA Kernel Optimizer的工具在Hacker News亮相,尝试用AI智能体自动优化CUDA内核性能。本文解析其技术思路、Agent在Kernel调优中的价值及现状观察。