论文中了但模型权重丢了,重训能行吗?

论文接收后发现权重未保存,社区共识是重训可接受,透明与可复现才是底线。
文章围绕 Reddit 机器学习社区的一个真实提问展开:论文被会议接收后才发现训练好的模型权重没有保存,只能重新训练,这样做是否符合学术规范。讨论形成的共识是,只要模型架构、超参数、数据划分和随机种子与论文描述一致,重训本身不构成学术不端,因为论文承诺的是方法与实验设计的可复现性,而非某一份权重文件。真正的风险在于评审与复现环节:若重训结果与论文报告值差异明显却未说明,才会触及诚信边界。主流会议通常要求可复现的代码或补充材料,很少强制提交权重。文章最后给出投稿前保存实验快照、版本化配置、如实说明随机性等工程建议。
一个让研究员失眠的常见事故
在Reddit的机器学习社区,一位研究者提出了一个很实际的问题:论文被会议接收后,发现训练好的模型权重没有保存,现在只能重新训练。他想知道,这样做在学术规范上是否可接受。
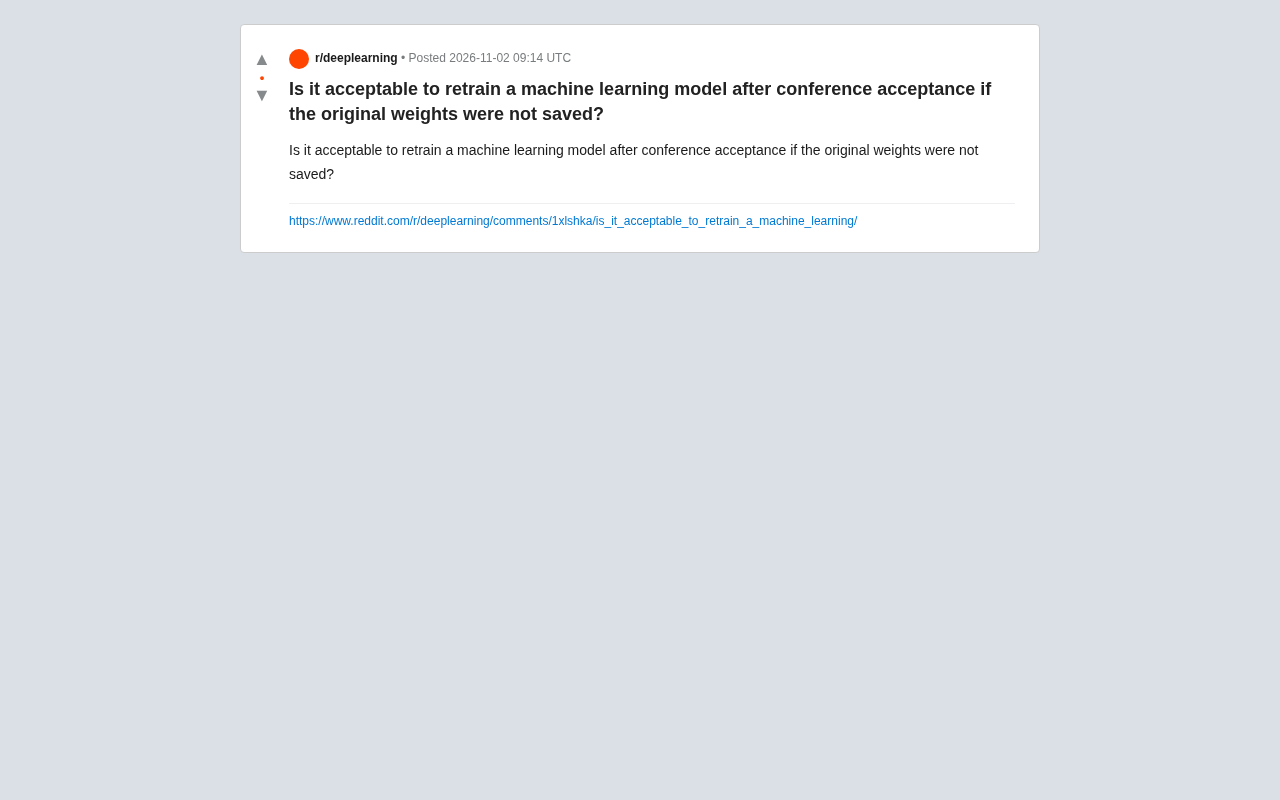
这个问题看似简单,背后却牵扯到可复现性、评审信任和科研工程实践三层问题。讨论中既有研究者分享亲身经历,也有对会议政策的梳理,形成了一个颇具参考价值的共识。
重训本身不是学术不端
多位社区成员的观点高度一致:只要模型架构、超参数、数据划分和随机种子设置与论文描述一致,重新训练本身不构成学术不端。论文真正承诺的是方法和实验设计的可复现性,而不是某一份特定的权重文件。
有回复指出,评审关注的是结论是否由所描述的方法产生,而不是你硬盘上是否恰好保留了那组参数。如果重训后的结果与论文报告的数字在合理误差范围内吻合,那么学术诚信上没有问题。
不过也有用户提醒,如果重训后指标出现明显下降,就不能悄悄替换结果而不说明,这才会触及诚信边界。
随机种子(random seed) 是控制伪随机数生成器初始状态的数值。深度学习训练中的参数初始化、数据打乱顺序、Dropout 掩码等都依赖随机数,固定种子后同一份代码在同一环境下理论上会产生相同的训练轨迹。但即便固定种子,GPU 上的非确定性算子(如某些 cuDNN 卷积算法、原子加法)仍可能引入微小差异,导致结果无法逐位复现。因此在讨论「重训结果是否一致」时,通常关注的是统计意义上的接近(如多次运行后的均值与方差),而非严格的数值相等。这也是社区强调论文应说明随机性来源和运行次数的原因。
评审与复现环节才是风险所在
分歧主要集中在风险应对上。一部分人认为,如果论文附带开源代码或补充材料,审稿人或读者在复现时发现结果对不上,重训就会变成信任危机。另一部分人则强调,深度学习训练本身存在随机性,只要论文中如实说明了随机性来源和多次运行的统计方式,小幅波动是可以解释的。
社区里比较务实的建议是:重训后主动记录新权重对应的结果,如果与论文报告值差异在正常波动范围内,无需特别声明;如果差异较大,应在代码仓库或论文勘误中如实说明。
Artifact 评审(artifact evaluation) 是部分会议(如 NeurIPS、MLSys、EuroSys 等)设立的可选或附加评审流程,由独立的评审委员会检查作者提交的代码、数据、脚本能否按文档运行并复现论文结果。它通常分为「可用(available)」「功能正常(functional)」「可复现(reproduced)」等递进等级。Artifact 评审一般不强制要求提交训练好的权重,而是考察他人能否依据提供的材料自行跑通流程。因此对作者而言,一份清晰的 README、环境依赖锁定文件和一键运行脚本,往往比附带几个 GB 的权重文件更关键。
工程习惯比事后补救更重要
讨论的另一条主线是预防。多位从业者提到,权重文件体积大、容易被误删或覆盖,应该有意识地在训练脚本里加入自动保存检查点、版本化数据集和配置文件的机制。
有用户建议把模型权重、随机种子和完整配置一起归档,并在论文投稿前锁定一份可追溯的实验快照。这样一来,即使会议接收后需要重新打包材料,也能直接取用而不用重训。
检查点(checkpoint) 是训练过程中定期保存的模型状态快照,除权重外通常还包含优化器状态、学习率调度器状态和当前 epoch 数,以便断点续训。与只保存最终权重相比,检查点机制能在训练中断或误覆盖时快速恢复,也便于事后选取验证集表现最好的那一轮。实践中可结合版本化存储(如 DVC、Git LFS 或将权重上传至对象存储并记录哈希)来管理大文件,避免二进制文件与代码版本脱节。配置层面则常用 YAML/Hydra 等工具记录超参数,保证每次实验的完整配置可追溯。
会议政策怎么看
关于会议层面的规定,讨论中的共识是:主流会议通常要求提供可复现的代码或补充材料,但很少强制要求提交权重文件本身。因此重训是否“合规”,更多取决于作者是否如实描述了方法和结果,而不是是否保留了原始二进制文件。
如果论文涉及可复现性声明或 artifact 评审,作者应确保重训流程能被他人按文档执行,这比保留一份权重更有实际意义。
实践建议
综合讨论,可以归纳出几条可操作的做法:投稿前保存一次完整实验快照;在论文中明确说明随机性和多次运行的统计口径;重训后对比结果,差异明显时主动说明;把权重和配置纳入版本管理,避免再次踩坑。
这个问题的答案并不复杂——重训可以接受,但透明和可复现才是底线。
相关推荐

笔记本CPU跑本地大模型:Ollama+千问3给桌宠装大脑
普通笔记本没显卡也能跑本地大模型:B站UP主用Ollama加开源千问3 8B纯CPU运行,为原创桌宠小金娘装上本地大脑,配合DeepSeekHarness完成插件开发与三轮调试,模型0元、断网可用、隐私不出本机。

Mistral Large 4开源权重发布:1万亿参数,激活49亿
Mistral Large 4开源权重发布:约1万亿参数、激活约49亿,支持图文与百万级上下文。解析厂商自测的编码与网络安全数据、修改版宽松许可、数据中心级硬件门槛,以及权重公开后不可回收的安全风险。

AgentScope 2.0实战:Java企业级AI Agent开发指南
AgentScope 2.0是阿里巴巴推出的Java企业级分布式智能体框架。本文解析它为何适合服务端AI应用,对比客户端AI应用在权限、状态管理、并发上的差异,并梳理从环境配置到项目联调的实战学习路线。