M5 Ultra 80核跑GLM-5.3-Flash实测:内存充裕但GPU成瓶颈
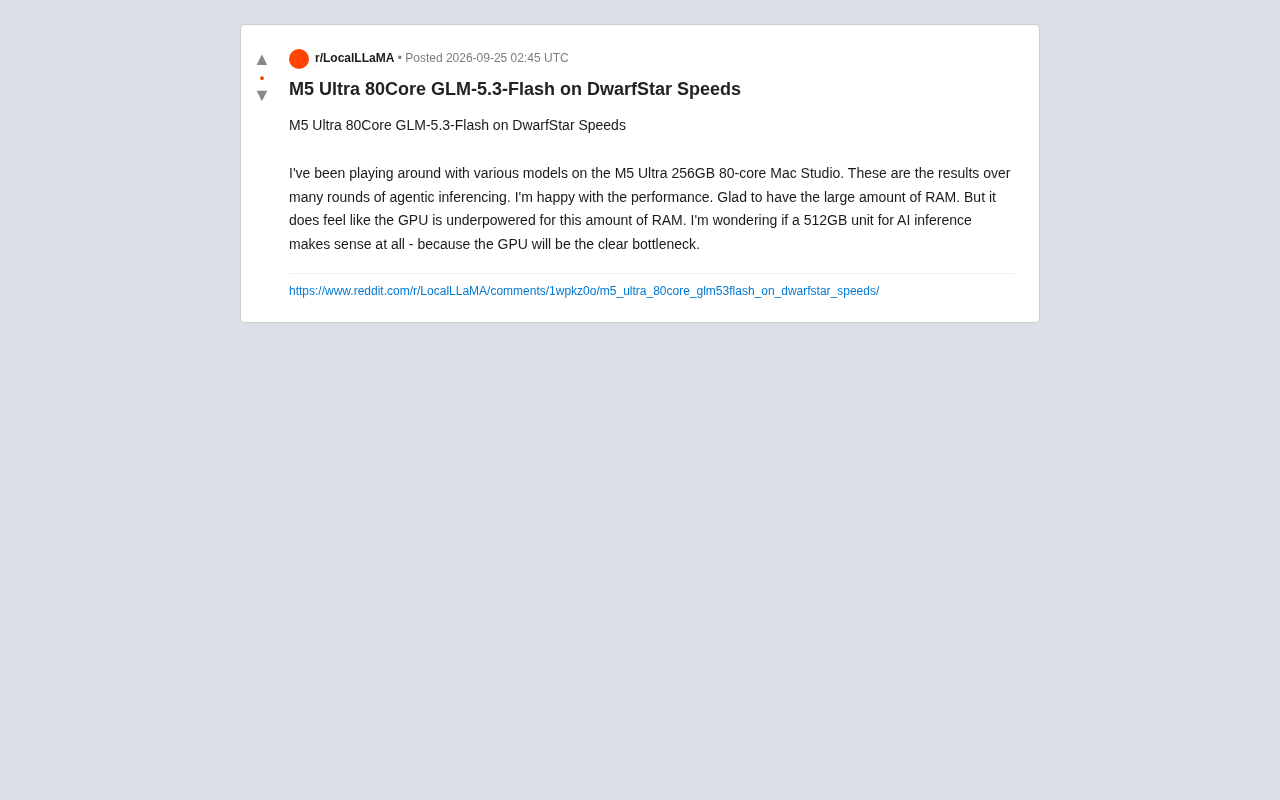
M5 Ultra 256GB实测:统一内存装得下大模型,但GPU算力成为推理速度的真正瓶颈。
一位用户在M5 Ultra 256GB Mac Studio上进行本地大模型agentic推理测试后发现,Apple Silicon统一内存架构虽能轻松加载消费级独立显卡无法企及的超大模型,但相对于庞大的内存容量,80核GPU的算力明显不足,成为推理速度的决定性瓶颈。由此引发的核心问题是:将内存升级至512GB是否值得?由于GPU算力不随内存翻倍增长,更大的模型反而可能跑得更慢,性价比存疑。文章建议本地推理用户在选购时综合权衡内存容量、GPU核心数与目标模型规模的匹配关系,对于追求响应速度的agentic应用,跑得快的中等模型往往比跑得慢的超大模型更实用。
M5 Ultra 本地大模型实测:内存不是问题,GPU 才是
一位 Reddit 用户分享了在 M5 Ultra 256GB 80核 Mac Studio 上运行 GLM-5.3-Flash 等多个模型的实测体验。经过多轮 agentic(智能体)推理测试后,他对整体性能表示满意,同时也提出了一个值得所有本地大模型爱好者思考的问题:当内存不再是瓶颈时,GPU 算力是否会成为新的短板?
这条实测反馈虽然简短,却触及了 Apple Silicon 统一内存架构在 AI 推理场景下的一个核心矛盾——大容量内存与相对有限的 GPU 算力之间的失衡。
大内存的价值:装得下才是第一步
对于本地部署大语言模型而言,显存(或统一内存)容量往往是决定“能不能跑”的硬门槛。这位用户特别提到,庆幸自己选择了 256GB 的大内存配置。
在 Apple Silicon 的统一内存架构下,CPU 和 GPU 共享同一块高带宽内存。这意味着 256GB 的配置可以轻松加载参数量较大的模型,甚至同时驻留多个模型或处理超长上下文——这是消费级独立显卡(通常 24GB 显存起步、旗舰卡也难超 48GB)难以企及的优势。对于需要频繁调用工具、维持长会话状态的 agentic 工作流来说,充裕的内存尤为关键。
Apple Silicon 的统一内存架构(Unified Memory Architecture,UMA)与传统 PC 的 CPU+独立 GPU 架构存在本质区别。在传统架构中,CPU 内存与 GPU 显存是物理隔离的两块存储,数据在两者之间传输需要经过 PCIe 总线,既有带宽限制也有延迟开销。Apple Silicon 则将 CPU、GPU、Neural Engine 等所有计算单元集成在同一颗芯片上,共享一块高带宽的低延迟内存,数据无需跨总线复制即可被任意计算单元访问。这对大语言模型推理极为友好,因为 LLM 在推理时需要将模型权重(参数)常驻内存,并在每次生成 token 时反复读取——内存带宽直接决定了推理速度的上限。M5 Ultra 的内存带宽可达数百 GB/s,远超消费级独立显卡的显存带宽,这也是为什么 Apple Silicon 在每 GB 内存的推理效率上往往优于同等容量的独立显卡方案。
新的瓶颈:GPU 算力跟不上内存规模
然而,装得下并不等于跑得快。这位用户敏锐地指出:相对于如此大的内存容量,GPU 显得算力不足(underpowered)。
这是统一内存架构一个容易被忽视的结构性问题。厂商在提升内存容量时相对激进,但 GPU 的浮点算力提升幅度有限。结果就是,当模型规模变大、推理负载变重时,GPU 的计算吞吐成为决定 token 生成速度的关键因素,而不再是内存容量。换句话说,你能加载一个巨大的模型,但它跑起来的速度可能并不理想。
对于 agentic 推理这种需要多轮往返、对延迟敏感的场景,GPU 算力的短板会被进一步放大——每一步推理的等待都会累积成明显的体验差异。
衡量 GPU 推理能力的核心指标有两个:内存带宽(Memory Bandwidth,决定权重读取速度,影响生成每个 token 的延迟)和浮点算力(FLOPS,决定矩阵运算速度,影响 prefill 阶段即处理输入提示词的速度)。对于本地推理场景,尤其是 batch size 为 1 的交互式对话,内存带宽往往比浮点算力更关键——GPU 的瓶颈常常不在于"算得慢",而在于"读权重读得慢"。然而当模型参数量极大(如 700B 级别)时,即便带宽充足,GPU 的并行计算核心数量也会成为限制因素。M5 Ultra 的 80 核 GPU 虽然已是 Apple Silicon 消费级最高配置,但与 NVIDIA H100/H200 等数据中心级 GPU 相比,其浮点算力仍有数量级的差距。这意味着在运行需要密集矩阵乘法的超大模型时,GPU 核心数不足的问题会愈发凸显。
512GB 版本值得买吗?一个关于平衡的思考
基于上述观察,这位用户抛出了一个颇具代表性的疑问:为 AI 推理购买 512GB 的机型,究竟有没有意义?
他的推理逻辑很清晰:如果 256GB 配置下 GPU 就已经是明显的瓶颈,那么把内存翻倍到 512GB 后,GPU 算力并不会随之增长。届时用户虽然能加载更大的模型,但受限于 GPU 吞吐,实际推理速度反而会更慢,性价比未必划算。
这实际上是一个关于硬件配置平衡的经典问题。购买大内存机型做本地推理时,需要问自己几个问题:
- 你的核心需求是“能跑”还是“跑得快”? 如果只是想加载和体验超大模型、对速度不敏感,大内存有意义;如果追求响应速度和高吞吐,GPU 才是决定因素。
- 模型规模与内存是否匹配? 内存远超模型实际需求属于资源浪费,钱花在了用不上的容量上。
- 是否会同时运行多个模型或超长上下文? 这类场景才真正需要极致的内存容量。
给本地大模型玩家的启示
这条来自真实使用者的反馈,为考虑用 Mac Studio 做本地 AI 推理的用户提供了务实的参考:
统一内存的“大”是一把双刃剑。它降低了运行大模型的门槛,但并不能自动带来理想的推理速度。在实际选购时,不应只盯着内存数字,而要综合评估 GPU 核心数、内存带宽与目标模型规模之间的匹配关系。
对于大多数以速度和交互体验为导向的 agentic 应用,与其追求 512GB 的极限内存,不如把预算权衡放在 GPU 算力更强的方案上——毕竟,一个跑得快的中等模型,往往比一个跑得慢的超大模型更实用。
需要说明的是,本文基于单一 Reddit 用户的主观实测体验,具体性能数据未经系统化基准测试验证,仅供参考。不同模型、不同量化方案下的表现可能存在较大差异。
量化(Quantization)是缓解内存与算力失衡问题的重要手段。通过将模型权重从 FP16/BF16 精度压缩为 Q4、Q5、Q8 等低精度格式,可以显著减少模型占用的内存空间——一个原本需要 140GB 的 70B 参数模型,Q4 量化后可能只需约 40GB。这不仅让较小内存的设备也能加载更大的模型,还能因为减少了每次推理需要读取的数据量而间接提升 token 生成速度。在 llama.cpp、Ollama 等主流本地推理框架中,GGUF 格式已成为量化模型的事实标准,提供从 Q2 到 Q8 的多个精度档位供用户根据内存容量和质量需求灵活选择。对于 M5 Ultra 用户而言,合理选择量化精度,使模型在内存占用与推理速度之间取得最佳平衡,往往比单纯追求更大内存容量更有实际意义。
相关推荐
Jev:颠覆ChatGPT架构的超高速AI决策引擎
Jev是ChatGPT联合发明者推出的全新AI决策引擎,采用RLCD架构,速度最高达传统大模型200倍、成本仅400分之一,输出token免费且声称零幻觉。本文解析其定位、优劣势与实时Demo。
意识的神经科学:大脑如何产生主观体验
意识的神经科学入门:从植物状态患者的脑成像研究,到意识的神经关联、简单问题与难题,再到全局工作空间理论、整合信息理论与预测加工三大主流理论,解析大脑如何产生主观体验。
Jev模型实测:快到能实时运行Doom的AI
一位ChatGPT核心贡献者打造的Jev模型号称快到能实时运行Doom,输出token免费、输入仅四美分每百万,性能对标Sonnet 5等旗舰。本文梳理其速度、定价与性能亮点及需验证之处。