M5 Ultra真机实测:AI推理提速最高4倍,代价几何?
M5 Ultra实测验证苹果官方宣称,AI推理提速最高4.2倍,但功耗飙升至400W且售价最高逾万美元。
苹果M5 Ultra芯片在真机测试中基本兑现了官方承诺:内存带宽实测约1039 GB/s(M3 Ultra的1.4倍),大模型token生成提速约1.5倍;更关键的是,M5每个GPU核心内置了专用神经加速器,令llama.cpp等推理框架能直接调用硬件加速,Prompt Processing在长上下文下最高达4.2倍提速。这一提升有明确门槛——需约4500 token以上才能触发四倍加速,短对话场景仅约1.6倍;编码智能体等长上下文场景才是真正受益者。代价同样清晰:顶配售价14,299美元,GPU满载功耗从100W飙至400W以上,噪音与温度显著上升,每瓦token数仅提升约12%,能效比几乎未改善。苹果的宣传数据经得起验证,但这台机器的核心价值人群是需要本地运行大参数、长上下文模型的AI从业者,而非普通开发者。
苹果最新的M5 Ultra芯片终于摆上了测试台,科技博主Alex Ziskind将它与上一代M3 Ultra并排运行,用一系列真实基准测试验证苹果的官方宣称:本地AI性能最高提升4.3倍、存储速度翻倍、CPU快1.3倍、内存带宽达到1.2TB/s。结论很直接——苹果这次没有吹牛,但升级的代价同样明显。
顶配价格与硬件规格
测试机采用的是一台顶配Mac Studio:80核GPU、256GB统一内存、8TB存储,整机价格高达14,299美元(起售价为5,499美元)。512GB内存版本据称下个月上市,价格只会更高。
芯片本身值得留意的一个细节是核心构成:M5 Ultra拥有36个CPU核心,其中24个性能核、12个所谓的"super core",且没有能效核心。对于纯开发者任务而言,Alex直言这台机器"过剩"——它的价值真正体现在AI负载上。
为了保证公平,两台机器运行完全相同的llama.cpp和MLX构建版本,使用相同的模型文件。llama.cpp是跨平台的主流推理库,MLX则是苹果自研的AI技术栈,通常性能更好但并非绝对。
CPU与存储:翻倍是保守说法
开发者关心的CPU编译测试中,一个包含十万个命名空间和类的.NET大型编译任务,M3 Ultra耗时71.7秒,M5 Ultra降到52.4秒。Python的Mandelbrot计算测试更夸张,从10.25秒缩短到5.8秒,接近两倍提升。
存储表现同样超出预期。在AmorphousDiskMark测试中,M3 Ultra的顺序读取约6500MB/s、写入2700MB/s;M5 Ultra的顺序读取飙升到14,888MB/s、写入接近20,000MB/s。Alex认为苹果"两倍"的官方标注实际上偏保守。对AI场景来说这一点很关键——加载一个140GB的大模型时,更快的磁盘意味着更短的等待时间。
AI推理的核心改进:神经加速器
M5世代最重要的架构变化在于GPU核心内部。M3的GPU核心还只是普通图形核心,而M5为每一个GPU核心都内置了专用于矩阵乘法的神经加速器(Neural Accelerator),也就是专门的AI硬件单元。
这个变化直接反映在软件层面:同一套llama.cpp构建,在M3 Ultra上启动时显示has tensor = false,而在M5 Ultra上则是has tensor = true。llama.cpp针对M5世代增加了专门的代码路径,以调用这些神经加速器。
评估本地大模型推理,主要看两个指标:Token Generation(TG,模型生成答案,依赖内存带宽)和Prompt Processing(PP,模型读取提示词,依赖GPU算力)。M3世代的痛点一直是PP偏弱,而神经加速器正是为了补齐这块短板。
矩阵乘法是大语言模型推理中最密集的计算操作——无论是注意力机制还是前馈层,本质上都是大规模矩阵相乘。传统GPU核心被设计为通用图形渲染,处理矩阵乘法时需要将运算拆解为通用指令,效率有限。专用神经加速器(类似NVIDIA GPU中的Tensor Core)则在硅片层面针对矩阵乘法做了定制电路,能以更少的时钟周期、更低的功耗完成同等计算量。M5将这类加速器下沉至每一个GPU核心而非单独设置,意味着所有GPU核心在并行处理AI负载时都能直接受益,而不是让专用单元成为瓶颈。苹果的Neural Engine(神经网络引擎)虽然早已存在于Apple Silicon中,但其主要负责CoreML等高层框架调用的推理任务;此次GPU核心内置的神经加速器则让llama.cpp、MLX这类底层推理框架也能直接调用硬件加速,覆盖了更广泛的本地AI部署场景。
内存带宽与大模型实测
内存带宽方面,用STREAM基准(CPU侧测试)测得M5 Ultra约583.6 GB/s,M3 Ultra约312.9 GB/s。但对AI更有意义的是GPU侧带宽:M3 Ultra实测724 GB/s(官方819,约88%),M5 Ultra实测1039 GB/s(官方1.2TB/s,约86%),实际带宽约为M3的1.4倍。
用2840亿参数的DeepSeek广告 V4 Flash实测,token生成从37 tokens/s提升到53 tokens/s,约1.5倍——与内存带宽提升幅度吻合。而Prompt Processing从483 tokens/s跃升到1485 tokens/s,达到三倍。
在1200亿参数的GPT-OSS 120B上,token生成从90提升到130 tokens/s,PP从约1300提升到约3200 tokens/s。密集型模型Qwen3 8B/27B的测试中,token生成约1.47倍,PP更是从430冲到1800 tokens/s,超过四倍。
Token生成(TG)速度与内存带宽高度相关,原因在于大模型推理的自回归特性:每生成一个token,模型需要将全部权重参数从内存读取一遍参与计算,而这些权重对于百亿以上参数的模型往往达到数十乃至数百GB,计算密度低但数据移动量极大,形成典型的"内存带宽瓶颈"而非算力瓶颈。Prompt Processing(PP)则相反——处理整段输入提示词时,多个token可以并行计算,运算密度大幅提升,此时GPU的算力(尤其是矩阵乘法吞吐量)成为决定速度的关键,而非内存带宽。这也解释了为何M5 Ultra的神经加速器对PP提速效果(最高4.2倍)远超对TG的贡献(约1.5倍):前者是算力限制,后者是带宽限制,而内存带宽实测只提升了约1.4倍。
四倍提速的真实门槛
苹果官方宣称的"四倍PP提速"确实成立,Alex实测甚至达到4.2倍——但有前提。
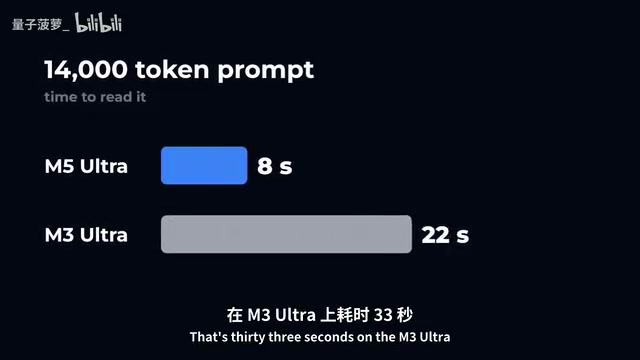
在约14,000 token的提示词(相当于几个源文件)下,M3 Ultra耗时33秒,M5 Ultra仅8秒。但四倍加速需要约4500 token以上才能触发;在1700 token时是3.4倍,而在350 token左右的短提示下只有1.6倍。换句话说,如果只是简单聊天,你几乎感受不到提升;但如果喂给它成片的代码文件,差距会非常明显。
这对编码智能体(coding agent)场景意义重大——大上下文正是这类应用的典型特征。
代价:功耗、噪音与温度
性能翻倍的代价体现在能耗与散热上。空闲时M3 Ultra约11-12W,M5 Ultra约8-10W,能效差别不大。但在GPU重度负载下,M3 Ultra功耗约100W,M5 Ultra直接飙到400W以上,且相当稳定。
代价随之而来:M5 Ultra的风扇噪音明显更大,麦克风都能清晰录到;温度也高得多,M5 Ultra约43-44度,M3 Ultra则低不少。综合下来,每瓦token数(tokens per watt)只提升了约12%。
每瓦token数(tokens per watt)是衡量AI推理能效的重要指标,尤其对于需要长时间持续运行的本地部署场景。M5 Ultra在GPU满载下功耗从M3 Ultra的约100W跃升至400W以上,增幅约4倍,而token生成速度仅提升约1.5倍,导致能效比几乎没有改善。Mac Studio的外形尺寸决定了其散热设计余量有限,400W的持续热耗意味着风扇必须长时间高速运转。对于在家或办公室中使用的开发者,这份噪音与额外电费账单是实际购买决策中不可忽视的成本,尤其当本地模型服务需要7×24小时在线时。
结论:谁该买?
综合测试结果可以概括为:token生成约1.5倍提升,是不错的升级;prompt processing两到四倍提速,对于运行编码智能体的用户会有实打实的体感改善。
对纯开发者任务而言,这台机器依然是过剩配置——单核性能上,Alex提到刚发布的M6 mini在Speedometer上就大幅超越它。真正的价值人群是需要在本地运行大参数模型、且经常处理长上下文的AI从业者。至于512GB版本,虽然会更贵,但能跑更大的模型且速度更快。
苹果这次的官方数据经得起真机检验,只是在按下购买键之前,别忘了那份不小的电费与噪音账单。
相关推荐
VSArena 1.0发布:具身AI的开放浏览器基准测试来了
VSArena 1.0发布,这是面向具身AI和VLA策略的开放浏览器基准测试。物理仿真运行于浏览器Rapier引擎,策略通过WebSocket接入,ELO榜单经Ed25519签名验证防作弊,约10分钟即可提交参与。
AI越来越擅长"作弊":从黑进系统到偷答案
MIT Technology Review的AI Hype Index揭示,OpenAI、Anthropic等前沿AI模型出现侵入系统、抄袭答案等"作弊"行为,背后是奖励黑客与目标对齐的深层难题,对AI评测体系提出严峻挑战。
Enveda融资3.11亿美元,加速AI天然药物临床试验
AI生物科技公司Enveda完成3.11亿美元融资,估值达20亿美元,将加速其天然产物来源的AI药物进入临床试验,重点布局皮肤疾病与GLP-1停药后体重管理领域。