macOS 内存限制无效:用 stageload 在交换前终止任务

macOS 无法用 ulimit 限制内存,需靠交换空间监控与守护器在卡死前终止任务。
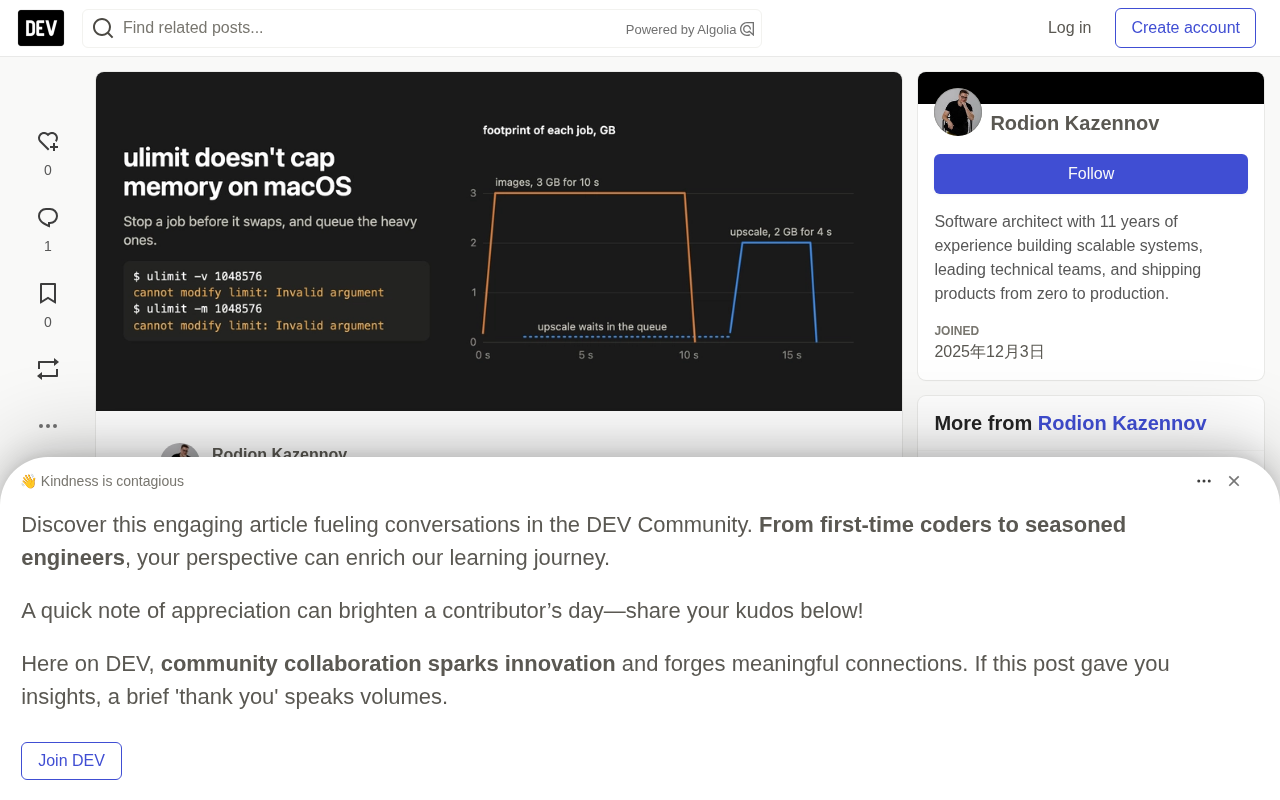
macOS 既没有 systemd 也没有 cgroups,且 ulimit 直接拒绝设置内存上限,resource.setrlimit 也会抛错。系统面对内存压力时选择压缩内存并写入交换空间,于是放不下的任务不会失败,只会让整台 Mac 一起变慢。活动监视器显示的进程足迹不含已交换的页,可能严重低估内存使用,因此应改用 sysctl vm.swapusage 和 kern.memorystatus_level 监控。stageload guard 可在空闲内存不足或交换空间增长超预算时向进程组发送 SIGTERM/SIGKILL,在机器卡死前终止任务;stageload run 则把多个重任务纳入同一队列,按所有者公平调度、分通道运行,避免同时启动耗尽内存。根本的解法仍是逐阶段加载模型,把峰值内存从 43.6 GB 降到 19.0 GB。
在 Linux 上,ulimit -v、systemd-run -p MemoryMax= 或 cgroup 可以限制单个任务的内存,超出上限的任务会自行失败,而不是拖垮整台机器。macOS 既没有 systemd 也没有 cgroups,而且 ulimit 直接拒绝设置内存上限。
在 macOS 26.5.2 上的实测结果:
$ /bin/bash -c 'ulimit -v 1048576'
/bin/bash: line 0: ulimit: virtual memory: cannot modify limit: Invalid argument
$ /bin/bash -c 'ulimit -m 1048576'
/bin/bash: line 0: ulimit: max memory size: cannot modify limit: Invalid argument
Python 中的 resource.setrlimit(resource.RLIMIT_DATA, ...) 会抛出 ValueError。更糟的是,在 ulimit -m 设置失败的那个 shell 里,一个脚本继续分配并触碰了 3 GiB 内存。
macOS 的做法是压缩内存并写入交换空间(swap)。一个放不下的模型不会失败:它变慢,同时整台 Mac 上的一切都变慢。
所以值得问的问题变了:任务启动前有空间吗?运行中交换空间在增长吗?
运行中检查交换空间
sysctl vm.swapusage             # 比较运行前后的 "used" 值
sysctl kern.memorystatus_level  # 系统级空闲内存百分比
活动监视器显示的进程足迹(footprint)不包含已经进入交换空间的页。在一次 Qwen-Image-2.1 使用 diffusers 模型 CPU offload 的运行中,48 GB M5 Pro 上的足迹从未超过 18.5 GB,而交换空间增长了 9.6 GB。只看足迹的图表会认为这次运行是放得下的。
交换空间(swap)与内存压缩:macOS 没有将内存超限视为错误,而是通过两条机制消化压力。其一是压缩内存(compressed memory):内核把不常访问的页压缩后留在 RAM 中,解压时按需还原,代价是 CPU 开销;其二是交换空间(swap):当内存压力继续上升,页被写入磁盘上的交换文件,需要时再换回。两者都会让程序不失败、只变慢,且拖累同一台机器上的所有进程。sysctl vm.swapusage 报告的 used 是当前已占用交换空间(含加密压缩后的交换文件),启动前记录一次、运行中定期对比差值,就能判断任务是否正在把内存往磁盘上挤。kern.memorystatus_level 则是内核给出的系统级空闲内存百分比,数值越低表示内存越紧张,是比单看交换空间更即时的压力指标。
值得注意的是,交换空间本身不是失败信号,而是趋势信号:缓慢、稳定的小幅增长通常可接受,短时间内快速攀升则意味着任务正逼近机器容量极限,此时越早终止,机器被拖慢的时间越短。
在交换前终止任务
stageload 是一个为逐阶段加载模型而写的小型库,自带一个守护器(guard):
stageload guard --wait-free 40 --swap-budget 8G -- python generate.py
它会等到 kern.memorystatus_level 至少为 40% 才启动命令。如果交换空间比启动时已用的部分增长超过 8 GB,或者空闲内存连续两次采样低于 10%,它就会向命令的进程组发送 SIGTERM,五秒后再向剩余进程发送 SIGKILL。它不需要 root 权限,只会终止命令及其进程组。退出码 3 表示守护器终止了命令,4 表示没有找到启动空间;否则返回命令自身的退出码。
那一次 eager 模式的 Qwen-Image 运行就是这样结束的:它跑完了全部 20 步,VAE 解码让足迹达到 43.6 GB,交换空间增长 8 GB,守护器在 Mac 卡死前将它终止。
SIGTERM 与 SIGKILL 的分工:守护器先向命令的整个进程组发送 SIGTERM,这是一个可被捕获、可被处理的信号,程序有机会保存中间结果、释放资源并优雅退出。若五秒内进程仍未结束,再发送 SIGKILL——该信号无法被捕获或忽略,由内核强制终止,因此能保证收尾。向进程组而非单个 PID 发送很关键:一个训练或推理脚本常常会 fork 出数据加载、子进程或工作池,只杀主进程会留下占用内存的孤儿进程,导致限制形同虚设。
另一个细节是退出码的约定:普通 shell 命令被信号杀死时返回 128 加信号编号,而守护器有意使用自定义退出码——3 表示是守护器主动终止了命令(触发内存保护),4 表示启动前就没找到足够空闲空间;其余情况透传命令自身的退出码或信号结果。这样脚本和 CI 就能区分“任务自己失败”和“被内存守卫拦下”,从而决定是重试、缩小规模还是调整参数。守护器无需 root,也正是因为它只操作自己和子进程构成的进程组。
同时运行两个重任务
一个守护器独自做决定。两个守护器如果同时发现空间,就会同时启动各自的任务,而每个任务都是按空闲 Mac 来设定大小的。10 月 5 日,我的一次运行在另一个脚本两个视频任务的间隙启动,下一个视频任务在 20 秒内就把交换空间推过了预算。
stageload run 把任务放入同一台机器的队列。它接收守护器的参数。下面两个任务分别占用 3 GiB 和 2 GiB,从两个终端启动:
stageload run --who images -- python3 alloc.py 3 10    # 占用 3 GiB 持续 10 秒
stageload run --who upscale -- python3 alloc.py 2 4    # 占用 2 GiB 持续 4 秒
$ stageload queue
ram     0 running  images               pid 32488   since 2026-10-12T14:08:56+00:00  python3 alloc.py 3 10
ram     1 waiting  upscale              pid 32499   since 2026-10-12T14:08:58+00:00  python3 alloc.py 2 4
第二个任务在第一个结束后启动,然后守护器的检查照常运行:
14:08:58Z queue: waiting in ram (1 ahead: images)
14:09:08Z queue: start in ram after 10 s, swap 6.0 GB, stop above 14.0 GB or under 10% available twice
$ stageload queue --history 2
done   ram    exit 0    images               waited 0 s, ran 10 s, peak 3.0 GB  python3 alloc.py 3 10
done   ram    exit 0    upscale              waited 10 s, ran 4 s, peak 2.0 GB  python3 alloc.py 2 4
在共享 Mac 上,有几个细节很重要:
- 任务加入一个通道(lane),默认是
ram。通道之间不互相等待,所以等待远程 API 配额的任务可以放进自己的通道(--lane api --wait-free 0),不阻塞需要内存的任务。 - 轮次在所有者(owner)之间公平。最久没启动的所有者下一个执行,因此一个排队二十个任务的脚本会与其他脚本轮流,而不会独占通道。所有者由
--owner指定,或取--who中第一个连字符之前的部分。 - 每次运行都会为命令及其下所有进程写入一条内存轨迹,并在
~/.stageload/history.jsonl中记录一行,包含等待时间、运行时间、峰值足迹和交换空间。 - 在队列之外启动的引擎写入
~/.stageload/busy.txt,每行一个模式。ram通道中的每次运行都会等待,直到这些模式已有 20 秒未被观察到。
限制
- 守护器和计量器读取的是 macOS 计数器(
libproc、sysctl),因此只能在 Mac 上运行。 - 守护器终止任务,但不会让任务变小。在模型侧,逐阶段加载单个模型正是让 Qwen-Image-2.1 在同一台 Mac 上从 43.6 GB 降到 19.0 GB 的原因:如何在 48 GB Mac 上无交换运行 Qwen-Image-2.1。
- 如果需要覆盖整台机器的安全网,macos-oom-guard 以 root 运行,在内核 panic 前终止最大的进程。两者可以一起使用。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。