MAGIC归因方法可靠性受质疑:短窗口内精准,全局失效
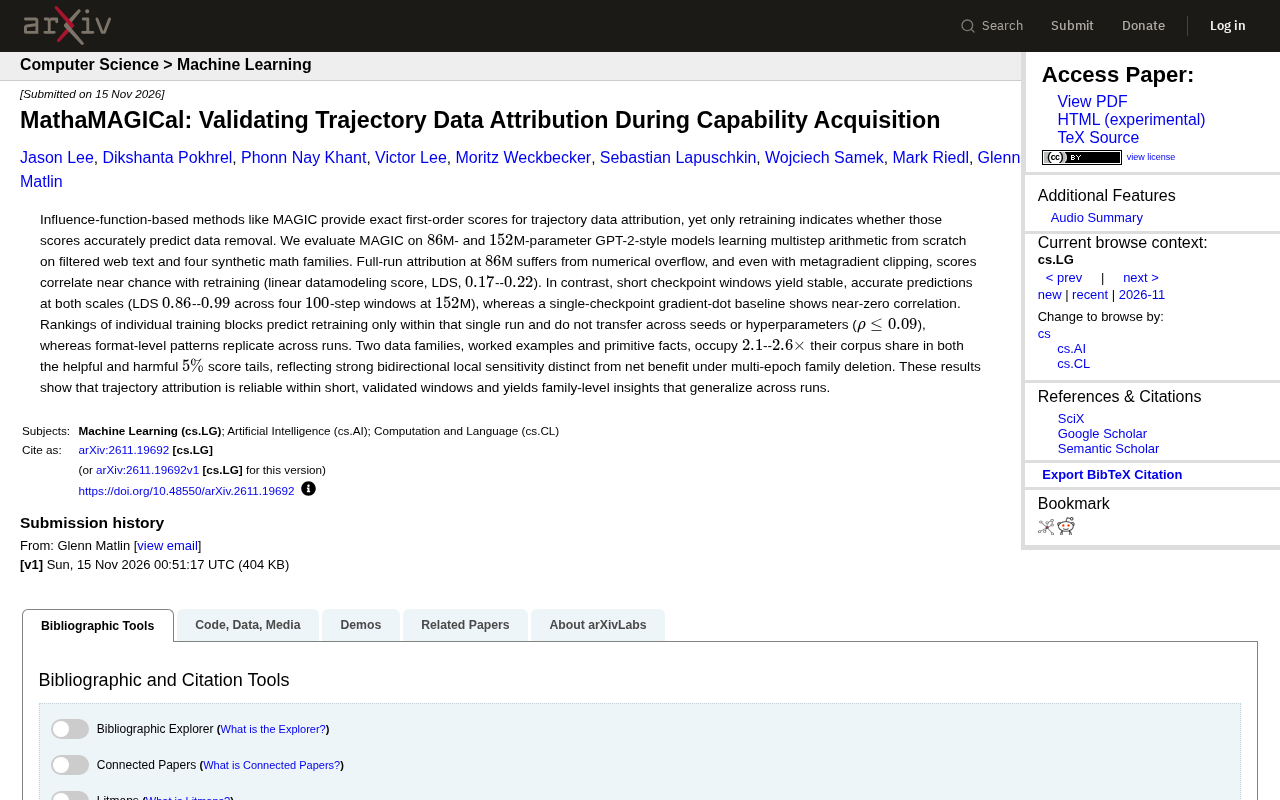
MAGIC归因在短窗口内可靠,但全局归因因数值溢出和低相关性而失效。
本文系统检验了影响函数方法MAGIC在语言模型学习多步算术时的可靠性。在86M模型上,全长轨迹的归因出现数值溢出,即使元梯度裁剪后与重新训练的相关性也仅0.17–0.22,接近随机水平。相反,在152M模型的100步短检查点窗口内,LDS达到0.86–0.99,预测精度高,而单检查点梯度点积基线相关性接近零。个体训练块的归因排名无法跨随机种子或超参数迁移(ρ≤0.09),但格式级别的模式可复现。worked examples和primitive facts两个数据家族在有益和有害尾部均过度代表,显示双向局部敏感性。研究建议将归因限制在短窗口并关注家族级别模式。
引言
在训练大语言模型时,我们常常想知道:哪些训练数据对模型学会某项能力贡献最大?影响函数(influence function)方法,如MAGIC,承诺给出精确的一阶归因分数。然而,这些分数是否真的能预测移除数据后的效果?一篇题为《MathaMAGICal: Validating Trajectory Data Attribution During Capability Acquisition》的研究,通过严格的重新训练实验,对MAGIC的可靠性进行了系统检验。
影响函数(influence function)源于稳健统计,用于估计移除或扰动单个训练样本对模型参数或损失的一阶近似影响。在深度学习中,常用的计算方式包括基于梯度点积的TracIn、基于Hessian逆向量积的Koh & Liang方法,以及MAGIC(Model-Agnostic Gradient-based Influence Calculation)这类面向长训练轨迹的元梯度方法。MAGIC通过沿训练轨迹累积梯度信息来归因,理论上能捕捉样本在多个检查点上的累积效应。然而,影响函数本质上是局部线性近似,当训练轨迹很长、参数变化剧烈时,高阶项和数值不稳定性可能导致归因分数偏离真实的重新训练效果。因此,验证影响函数时通常需要与“留一重训练”或“数据删除后重新训练”的基准进行相关性比较,常用线性数据建模分数(LDS)或Spearman秩相关作为度量。
实验设置:从零学习多步算术
研究团队在86M和152M参数的GPT-2风格模型上评估MAGIC。训练数据包括过滤后的网络文本和四个合成数学家族,任务是从零开始学习多步算术。这种设置模拟了模型获得数学推理能力的过程,为归因方法提供了可控的测试环境。
全局归因的数值困境与低相关性
在86M模型上运行完整归因时,出现了数值溢出问题。即使采用元梯度裁剪(metagradient clipping),归因分数与重新训练结果的相关性仍然接近随机水平——线性数据建模分数(LDS)仅为0.17–0.22。这意味着,在长轨迹上计算的归因分数几乎无法预测数据移除的真实影响。
元梯度裁剪(metagradient clipping)是一种用于稳定影响函数计算的工程手段。在MAGIC等方法中,归因分数通过对训练轨迹上的元梯度进行累积得到,而元梯度本身涉及对验证损失关于训练样本的混合偏导。长轨迹累积容易产生梯度爆炸或数值溢出,表现为分数出现NaN或极大值。裁剪操作将每个元梯度向量的范数限制在阈值以内,或对累积分数做截断,以缓解溢出。但裁剪会引入偏差:它改变了原始梯度的方向或尺度,可能使归因分数系统性偏离真实影响。此外,长轨迹上不同检查点的梯度方向可能相互抵消,导致最终分数信噪比降低,这解释了为何即使裁剪后相关性仍接近随机水平。
短窗口内的高精度预测
与全局归因的糟糕表现形成鲜明对比,短检查点窗口展现出稳定且准确的预测能力。在152M模型上,四个100步的窗口内,LDS达到0.86–0.99。这表明,在短时间窗口内,MAGIC分数能可靠地反映数据移除效果。而单检查点梯度点积基线(gradient-dot baseline)则表现出接近零的相关性,进一步凸显了窗口方法的优势。
线性数据建模分数(LDS,Linear Datamodeling Score)是评估数据归因质量的标准指标。其做法是:随机采样若干数据子集,对每个子集重新训练模型并记录目标指标(如验证损失),同时用归因分数线性预测该子集上的指标变化;然后计算预测值与实际值之间的相关系数(通常为Pearson或Spearman)。LDS越高,说明归因分数越能线性地解释数据子集移除后的效果。LDS接近1表示归因几乎完美预测重新训练结果,接近0则与随机猜测无异。该指标的优势在于直接以“重新训练”为金标准,避免了仅比较归因分数之间相关性的循环论证。本文中短窗口LDS达0.86–0.99,意味着在100步窗口内归因分数对数据移除效果具有高度预测力。
个体排名不可迁移,格式模式可泛化
研究还考察了归因分数的可迁移性。对单个训练块(training block)的排名,只能在该次运行内预测重新训练效果,无法跨随机种子或超参数迁移(Spearman相关系数ρ≤0.09)。然而,格式级别(format-level)的模式却能在不同运行间复现。这说明,细粒度的个体归因高度依赖具体运行条件,而粗粒度的数据类别模式则具有跨运行的稳定性。
Spearman秩相关系数(ρ)用于衡量两组排名之间的一致性,取值在-1到1之间,0表示无关。在归因可迁移性评估中,研究者通常对同一数据块在不同随机种子或超参数下的归因分数排名与重新训练效果排名分别计算ρ。若ρ很低(如≤0.09),说明某次运行中“哪个训练块最重要”的排序几乎不能推广到另一次运行,即个体归因高度依赖具体的初始化、数据顺序和优化轨迹。相比之下,格式级别(如“逐步解答示例”对比“基本事实”)的聚合模式在不同运行间保持一致,因为这类粗粒度类别反映了数据分布中的稳定统计规律,而非特定运行中的偶然梯度交互。这一区分对实践者至关重要:个体排名不可迁移,但类别级洞察可以跨运行复用。
双向局部敏感性与净收益的区分
一个有趣的发现是,两个数据家族——worked examples(逐步解答示例)和primitive facts(基本事实)——在有益和有害的5%分数尾部中,都占据了其语料份额的2.1–2.6倍。这反映出强烈的双向局部敏感性:这些数据既可能被归因为高度有益,也可能被归因为高度有害,具体取决于上下文。这种敏感性与多轮次家族删除下的净收益(net benefit)是不同的概念,提醒我们在解释归因分数时需谨慎。
启示与局限
这项研究传递出明确的信息:轨迹归因方法在短小且经过验证的窗口内是可靠的,并能提供可跨运行泛化的家族级别洞察。但若将其用于全长训练轨迹的全局归因,则可能因数值问题和相关性低下而失效。对于实践者而言,这意味着应当将归因分析限制在短窗口内,并关注数据家族级别的模式,而非个体样本的排名。
需要注意的是,该研究仅针对GPT-2风格模型和合成数学任务,结论是否能推广到更大模型、更复杂任务还有待验证。此外,MAGIC的数值溢出问题也提示,影响函数方法在实际部署前仍需解决稳定性挑战。
结论
MAGIC等影响函数方法并非万能钥匙。它们能在短窗口内提供准确的归因信号,但全局归因的可靠性存疑。研究者应充分利用短窗口验证和家族级别分析,同时警惕个体排名跨运行迁移的局限性。这项研究为数据归因的严谨评估树立了标杆,也指出了未来改进的方向。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。