ManyAgents: 在一个Mac窗口指挥AI编程代理团队

ManyAgents将Claude Code等代理编成团队,用编排器统一调度并内置评审。
ManyAgents 是一款面向专业开发者的 Mac 端生产力工具,核心思路是将 Claude Code、Codex 等 AI 编程代理组织成一支可统一调度的团队。它通过编排器拆分开发任务,让每个代理在独立的 git worktree 中并行工作,避免代码冲突和上下文污染。产品内置评审代理对产出进行质量检查,并提供浏览器环境让代理直接测试自己生成的 Web 应用,形成编写-测试-修正的闭环。所有代理的疑问和反馈集中呈现,减少窗口切换。该产品使用用户已有的 plans,无需额外购买 API 额度,目前提供 14 天免费试用。它在 Product Hunt 获得 80 票、排名当日第 11 位,反映出一定关注度但尚未爆发。文章认为其代表了 AI 编程工具从单一助手向多代理编排演进的方向,但稳定性和实际效率仍需真实场景验证。
在AI编程助手遍地开花的今天,如何高效管理多个代理协同工作成为新的痛点。ManyAgents 试图给出一个优雅的答案:它将 Claude Code 和 Codex 等编程代理组织成一支团队,让你从一个Mac窗口统一调度。
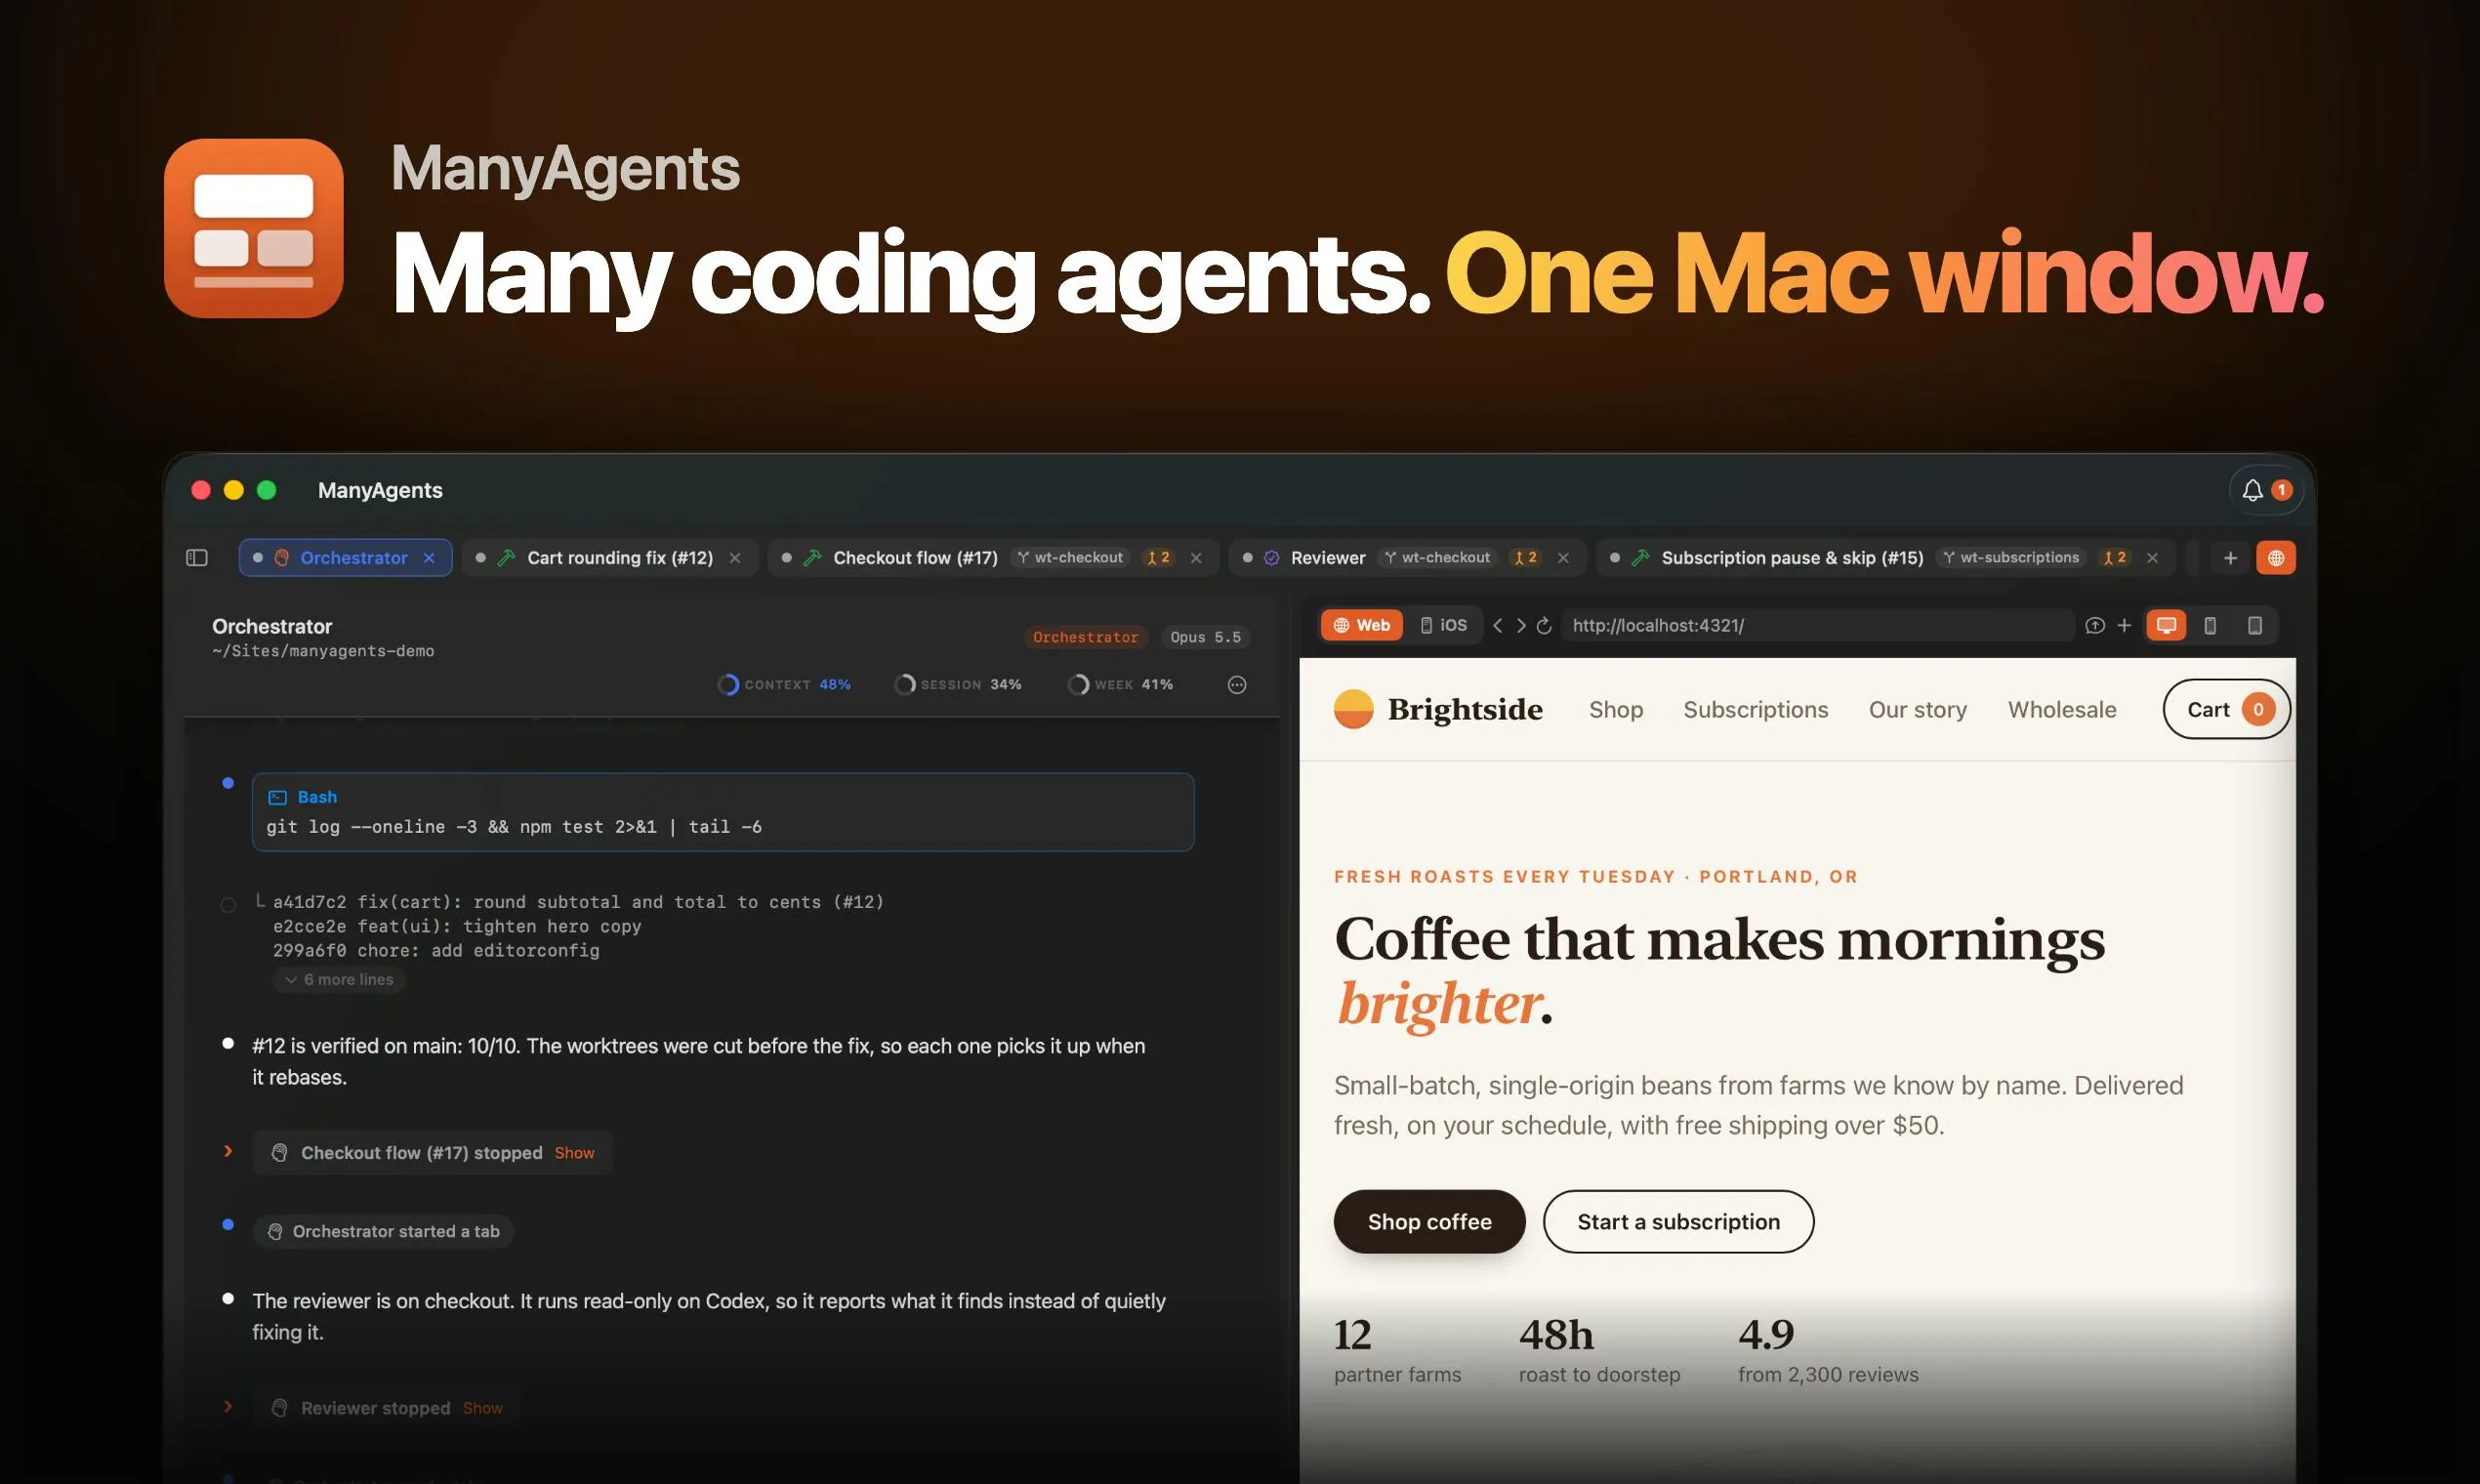
多代理协作的核心机制
ManyAgents 的核心是一个编排器(orchestrator),它负责将你的开发任务拆分并分配给多个AI编程代理。每个代理运行在独立的 git worktree 中,这意味着它们可以在互不干扰的环境里并行工作,避免代码冲突和上下文污染。
这种设计直接回应了当前AI编程工具的一个关键局限:单个代理往往难以同时处理复杂任务的不同部分,而手动切换多个工具又极其低效。ManyAgents 通过隔离的 worktree 结构,让并行开发变得可行。
此外,每个代理都使用你已有的计划(plans),无需额外购买或配置新的API额度,降低了使用门槛。
git worktree 是 Git 从 2.5 版本引入的机制,允许在同一个仓库上检出多个工作树(working tree),每个工作树对应不同的分支或提交,但共享同一份 .git 对象数据库。与传统的多次 git clone 相比,worktree 不会重复存储历史对象,磁盘占用小,且分支之间切换和隔离更轻量。其典型用途包括:同时维护多个发布分支、在修复紧急 bug 时不打断当前开发任务,以及在没有额外克隆成本的前提下并行实验不同特性。在多代理协作场景中,每个代理的改动都被限制在自己的工作树中,因此代码冲突、未提交更改互相覆盖、以及上下文被意外污染的风险被大幅降低。不过,worktree 只解决文件系统层面的隔离,分支合并、依赖共享和运行端口分配仍需上层编排逻辑处理。
orchestrator(编排器) 是分布式系统和自动化工具中的常见模式,负责协调多个执行单元的任务拆分、调度、结果聚合与失败重试,本身通常不直接执行业务逻辑。在多代理 AI 编程系统中,编排器需要解决几个关键问题:如何把用户的高层需求分解为粒度合适的子任务;如何判断一个代理完成的工作是否满足依赖关系,从而触发下游代理;以及当某个代理失败或产出被评审拒绝时,如何回滚或重新分配任务。与简单的“多开几个对话窗口”相比,编排器的价值在于显式管理任务状态和依赖图,使并行结果能够被可靠地汇聚。其设计难点在于任务分解的粒度和错误传播的控制——过度拆分会增加协调开销,而拆分不足则退化为单代理模式。
内置评审与浏览器测试
代码生成只是第一步,质量保障同样重要。ManyAgents 配备了评审代理(reviewer),负责检查其他代理产出的结果。这相当于在自动化流程中嵌入了一道质量关卡,减少人工逐行审查的负担。
更实用的是内置浏览器。代理可以直接在浏览器中测试自己生成的Web应用,形成“编写-测试-修正”的闭环。对于前端开发任务,这一功能尤为关键,因为它让代理能够自我验证,而不是依赖开发者手动跑一遍。
所有代理产生的疑问和反馈都会集中到一个地方,方便你统一处理,避免在多个窗口和工具之间来回切换。
评审代理(reviewer agent) 属于“多代理互检”或“生成-验证”范式的一种实现。它通常不直接修改代码,而是依据预设标准(如代码规范、测试是否通过、需求覆盖度)对另一个代理的输出给出判断或修改意见。这种做法借鉴了软件工程中的代码评审流程,也接近学术上的 actor-critic 结构:actor 负责生成,critic 负责评估。其有效性取决于评审标准是否可操作、以及评审代理能否获得足够的上下文(例如原始需求、测试结果、diff 范围)。局限在于,评审代理与生成代理可能共享相似的模型偏差,导致“互相确认错误”而非真正发现问题;因此,关键的最终判断仍需人工介入,评审代理更适合作为减少低级错误的第一道过滤层。
定位与体验
从产品定位看,ManyAgents 瞄准的是专业开发者和团队,属于生产力工具范畴。它目前提供14天免费试用,具体定价尚未在素材中披露。
在 Product Hunt 上,该产品获得了80票和6条评论,排名当日第11位,说明它引起了一定关注,但尚未形成爆发式传播。创作者 Stu Green 将产品官网链接放在 Product Hunt 页面,感兴趣的用户可以进一步了解。
值得关注的信号
ManyAgents 代表了AI编程工具演进的一个方向:从单一助手走向多代理编排。当 Claude Code、Codex 等代理能力越来越强时,如何让它们协同工作、互相审查,可能比单个代理的模型能力更重要。这个产品的思路值得开发者关注,尤其是那些已经在日常工作中使用多种AI编程工具的团队。
不过,多代理系统的稳定性和实际效率提升仍需真实场景验证,内置浏览器测试的覆盖范围也值得进一步观察。
相关推荐
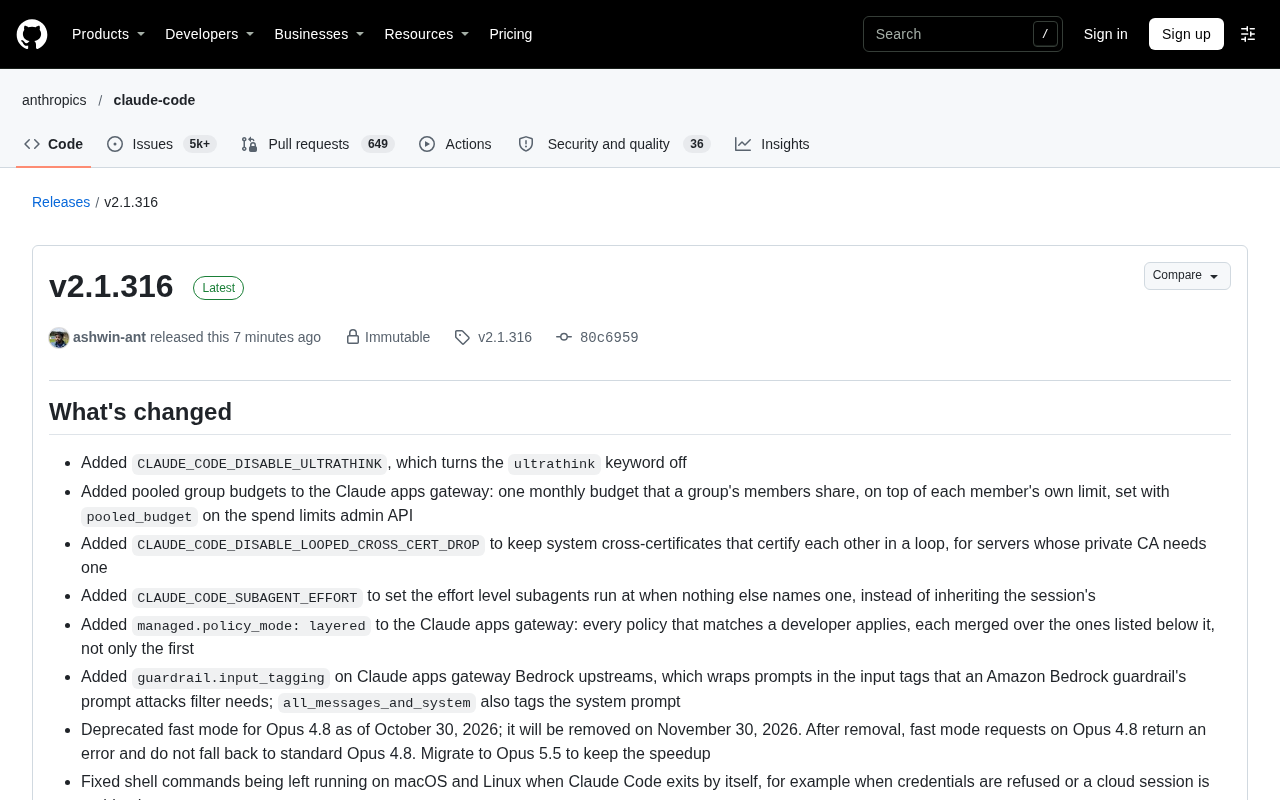
Claude Code v2.1.316 更新解析:企业级网关与多项稳定性修复
Claude Code v2.1.316 发布:新增企业网关池化组预算、分层策略模式、子智能体 effort 控制,修复 Shell、网络与会话恢复等数十项问题,并弃用 Opus 4.8 fast 模式。
17世纪英国洪水与末日恐慌:天气史新解
基于Hacker News讨论的'17世纪英国洪水与不祥预感',解读极端天气如何被赋予神意与政治预兆意义,并探讨天气史对当代气候传播与灾害舆情的启示。

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。