MAPLE:多轴参数化知识提取评估框架解析

MAPLE框架从表面、概率和超越采样三层拆解KEE技术对知识提取的双向效应。
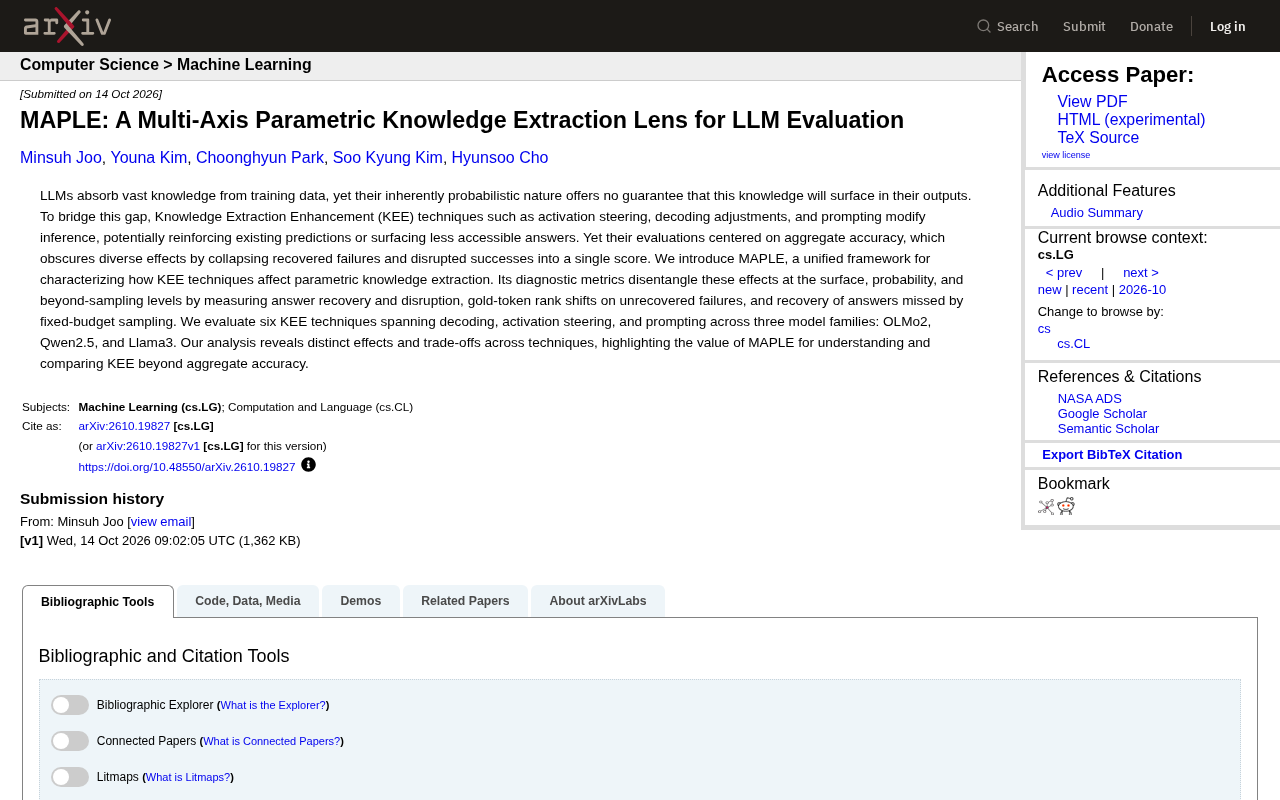
MAPLE是一个用于诊断知识提取增强(KEE)技术实际效果的统一分析框架,针对现有评估过度依赖聚合准确率、掩盖恢复与破坏双向效应的盲区。该框架从三个层级拆解效应:表面层级分别统计答案恢复与破坏,概率层级测量未恢复失败案例中金标token的排名变化,超越采样层级考察固定预算采样遗漏的答案能否被重新恢复。研究在OLMo2、Qwen2.5和Llama3三个模型家族上评估了六种覆盖解码、激活引导和提示的KEE技术,揭示了不同技术在恢复能力与破坏率之间的显著权衡。MAPLE不提出新技术,而是提供分析透镜,帮助研究者和工程师看清准确率变化背后的真实构成,做出更精准的技术选型与改进决策。
聚合准确率掩盖了什么?
大语言模型从训练数据中吸收了海量知识,但其固有的概率性质并不能保证这些知识一定会在输出中浮现。为了弥合这一差距,知识提取增强(Knowledge Extraction Enhancement,KEE)技术——如激活引导、解码调整和提示工程——会修改推理过程,可能强化已有预测,也可能让一些不易触达的答案浮现出来。
问题在于,目前对这些技术的评估大多集中在聚合准确率上。这种单一维度的打分方式会把"被恢复的失败案例"和"被破坏的成功案例"折叠进同一个数字里,从而掩盖了技术带来的多样化效应。换句话说,准确率涨了,你并不知道是真正解决了多少问题,还是同时制造了多少新问题。
参数化知识(Parametric Knowledge) 指模型在预训练阶段通过海量文本学到的、以权重形式存储的知识,区别于推理时通过检索或上下文临时获得的外部知识。KEE 技术所针对的正是这类知识:它虽然存在于模型参数中,却不一定能被稳定地调用出来。
激活引导(Activation Steering) 是一种在推理时干预模型内部隐藏层表示的技术。代表性方法有对比激活添加(CAA, Contrastive Activation Addition) 和推理时干预(ITI, Inference-Time Intervention),它们通过对比正负样本对,找出与目标行为(如真实性、安全性)相关的方向向量,再将该向量沿特定方向加回模型的激活空间,从而在无需微调的情况下改变输出倾向。
解码调整(Decoding Adjustment) 与激活引导不同,它不触碰模型权重或内部表示,而是在生成阶段修改 token 选择策略。典型的对比解码(Contrastive Decoding) 会同时运行强模型和弱模型,取两者对数概率之差作为下一 token 的评分,以抑制强模型常见的敷衍性输出;DoLa(Decoding by Contrasting Layers) 则在单模型内部对比不同层的输出分布,放大高置信度层所携带的事实知识,压低低层可能产生的泛化性错误。
MAPLE的核心设计:三个层级的诊断指标
针对上述盲区,研究者提出了MAPLE——一个用于刻画KEE技术如何影响参数化知识提取的统一框架。它的诊断指标从三个层级对效应进行拆解:
表面层级:答案恢复与破坏
最直接的一层是测量答案的恢复(recovery)和破坏(disruption)。恢复指的是原本答错的题目在KEE干预后答对了;破坏则是原本答对的题目反而答错了。将这两个方向分开统计,就能避免聚合准确率"一锅炖"的问题。
概率层级:未恢复失败中的金标排名变化
第二层深入概率分布,测量那些未被恢复的失败案例中,正确 token(金标 token)的排名是否发生了偏移。即便答案最终没有被纠正,如果正确 token 的排名显著上升,说明该技术确实在"接近"正确答案——这种潜在改善在聚合准确率中完全不可见。
金标 token(Gold Token) 在此语境下指标准答案对应的词元。模型在每一步生成时都会对整个词表计算概率分布,即所谓的 logits 分布。金标排名就是正确 token 在该分布中的位置:排名为 1 意味着模型将其排在首位,排名靠后则说明模型虽未正确输出,但内部概率质量已向正确答案倾斜。
这一指标的价值在于,它提供了一种连续信号,而恢复/破坏是离散的二元结果。一个 KEE 技术可能未能让任何一道题从错误变为正确,但如果大量失败案例中金标排名从几百名跃升到前十名,就意味着该技术确实在推动模型逼近正确答案。研究者可以据此判断该技术是否只是被最终采样步骤所埋没,换一个解码温度或增大采样预算就有可能转化为实际恢复。
超越采样层级 则进一步追问:在固定采样预算(如 3 次或 5 次回答)下,有些失败并不是因为模型不知道答案,而是因为在有限随机采样中恰好没有抽到正确回答。MAPLE 在这一层检测 KEE 技术是否能将这类被采样遗漏的答案重新拉回可及范围,从而区分知识缺失与采样运气两种截然不同的失败根源。
超越采样层级:固定预算采样遗漏的答案恢复
第三层关注固定预算采样所遗漏的答案能否被恢复。这涉及到模型在有限采样次数下未能生成正确答案的情况,KEE技术是否能帮助这些答案浮出水面。
六种技术、三个模型家族的交叉评测
研究团队在三个模型家族上评估了六种KEE技术,覆盖解码、激活引导和提示三大类别:
- 模型家族:OLMo2、Qwen2.5、Llama3
- 技术类别:解码调整、激活引导、提示工程
这种跨模型家族的评测设计,使得不同技术在不同架构上的表现差异得以暴露。分析揭示了各技术之间截然不同的效应和权衡——有些技术在恢复失败案例上表现突出但破坏率也高,有些则相对温和但恢复能力有限。
为什么MAPLE值得关注
MAPLE的价值不在于提出某种新的KEE技术,而在于提供了一套理解与比较现有技术的分析透镜。对于研究者和工程师而言,这意味着:
- 选择KEE技术时,不再只看准确率涨了多少,而是能看到"净收益"的构成
- 可以针对具体场景做取舍——如果应用场景对错误零容忍,那么高破坏率的技术就不合适
- 金标排名变化等细粒度指标,为技术改进提供了更精准的优化信号
从方法论角度看,MAPLE提示我们:在大模型评估日益同质化的今天,拆解评估维度本身就可能带来新的发现。当大家都在追求更高的聚合分数时,问一句"这个分数背后发生了什么",或许比刷榜更有意义。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。