MarineSparkLM-4B:轻量级海洋工程语言模型的LoRA实践

MarineSparkLM-4B 用两次 LoRA 微调在单台工作站上完成海洋工程领域适配,指令微调大幅提升评分但绝对准确性仍有限。
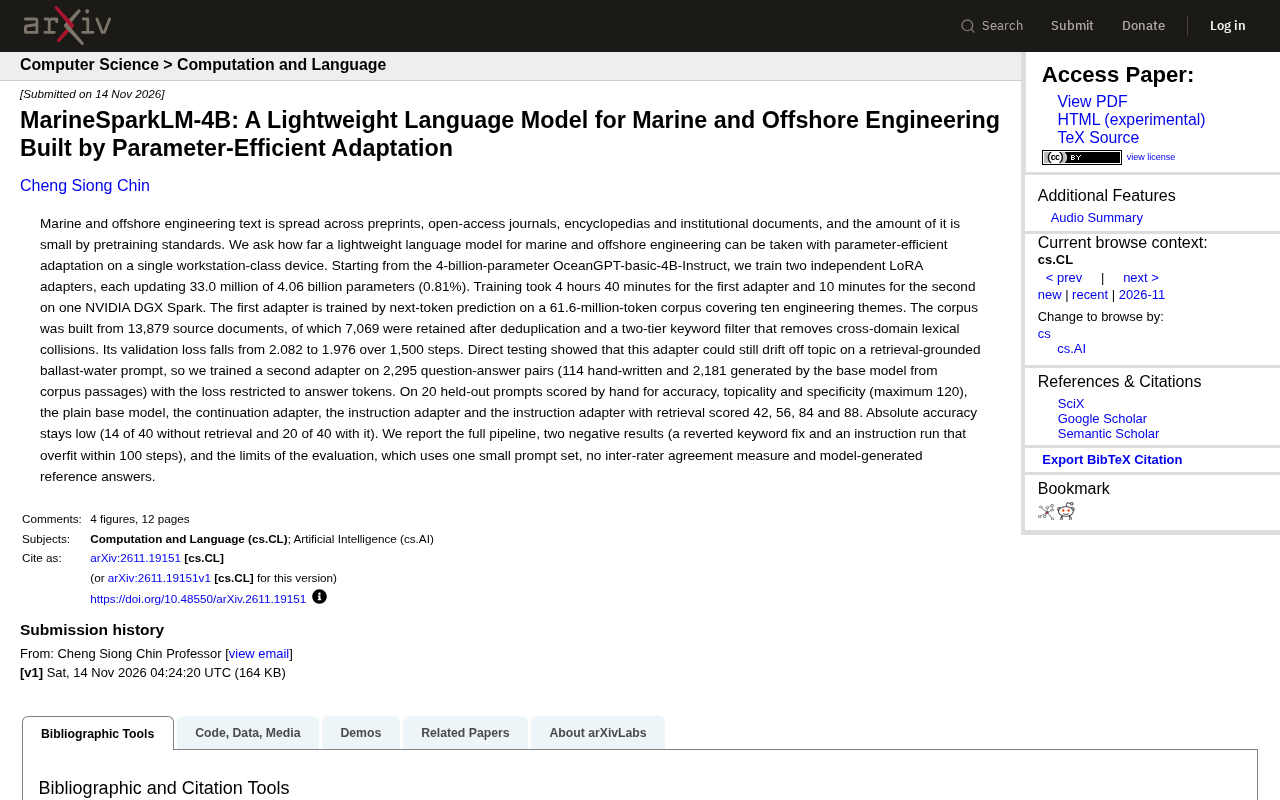
MarineSparkLM-4B 以 40 亿参数的 OceanGPT-basic-4B-Instruct 为基座,在单台 NVIDIA DGX Spark 上训练两个 LoRA 适配器,每个仅更新 0.81% 的参数。第一个适配器在 6160 万 token 的海洋工程语料上做下一词预测,验证损失从 2.082 降至 1.976,但模型仍会跑题;第二个适配器在 2295 个问答对上做指令微调,损失仅计算答案 token,显著改善了指令遵循能力。20 个留出提示的人工评分显示:基座 42 分、续写适配器 56 分、指令适配器 84 分、加检索 88 分,但绝对正确数仅 14/40 与 20/40。作者还报告了两个负面结果和评测局限,强调该模型适合作为辅助工具而非权威知识源。
海洋与近海工程领域的文本分散在预印本、开放获取期刊、百科全书和机构文档中,总量远达不到大规模预训练的标准。如何在单台工作站级设备上,通过参数高效微调打造一个可用的领域语言模型?MarineSparkLM-4B 给出了一个务实的答案。
从 OceanGPT 出发:两次 LoRA 微调的策略
研究团队以 40 亿参数的 OceanGPT-basic-4B-Instruct 为基座,训练了两个独立的 LoRA 适配器。每个适配器仅更新 4.06 亿参数中的 3300 万,占比 0.81%,却要承担起领域知识注入与指令遵循的双重任务。在单台 NVIDIA DGX Spark 上,第一个适配器训练耗时 4 小时 40 分钟,第二个仅需 10 分钟,硬件门槛被压到了工作站级别。
第一个适配器:领域语料继续预训练
第一个适配器采用下一词预测任务,训练语料覆盖十个工程主题,总量 6160 万 token。语料构建自 13,879 份源文档,经过去重和两级关键词过滤(用于剔除跨领域词汇碰撞)后保留 7,069 份。在 1,500 步训练中,验证损失从 2.082 降至 1.976。不过,直接测试暴露了问题:面对检索增强的压载水提示,模型仍会偏离主题。
下一词预测(Next-Token Prediction) 是自回归语言模型的标准预训练目标:给定前文 token 序列,模型输出词表上的概率分布,通过交叉熵损失最大化真实下一个 token 的似然。在领域继续预训练中,这一目标使模型学习领域文本的词汇搭配、句法模式和篇章结构,从而将通用语言能力“迁移”到海洋工程语境。本文第一个适配器即采用该任务,在 6160 万 token 的领域语料上训练 1500 步,验证损失从 2.082 降至 1.976。损失下降幅度有限,说明模型已较快适应语料分布,但也意味着单纯续写预训练难以教会模型“按指令回答”,这正是需要第二阶段指令微调的原因。
第二个适配器:指令微调纠偏
为解决跑题问题,团队在 2,295 个问答对上训练了第二个适配器,其中 114 个为手写、2,181 个由基座模型从语料段落生成,损失仅计算答案 token。这一设计让模型学会在给定上下文中聚焦回答,而非自由续写。
LoRA(Low-Rank Adaptation) 是一种参数高效微调技术。其核心思想是冻结预训练模型的所有原始权重,在每一层(通常是注意力模块的线性投影层)旁路注入一对低秩矩阵 A 和 B,将权重更新量 ΔW 分解为 BA 的乘积,其中 A 的维度为 r×d、B 的维度为 d×r,秩 r 远小于原始维度 d。训练时只更新 A 和 B,可训练参数量因此大幅缩减。以本文 40 亿参数基座为例,单个适配器仅需训练约 3300 万参数,占比 0.81%。推理时可将 BA 合并回原权重,不引入额外延迟;也可保留独立适配器,按需切换。LoRA 的优势在于显存占用低、训练快、易于多任务并存,特别适合在单台工作站上做领域适配。
指令微调(Instruction Tuning) 是在预训练模型上用“指令-回答”配对数据做监督微调,使模型学会理解任务描述并生成符合预期的回复,而非自由续写。关键在于损失只计算答案部分的 token(即对指令部分做掩码),迫使模型专注于学习“给定上下文后如何作答”。本文使用 2295 个问答对(114 个手写、2181 个由基座模型从语料段落生成),在 LoRA 适配器上训练。这一阶段显著提升了主题相关性和指令遵循能力,人工评分从续写适配器的 56 分跃升至 84 分。但小规模问答数据也带来过拟合风险,作者报告的“100 步内过拟合”即为佐证。
评测结果:指令微调带来大幅提升
在 20 个留出提示上,由人工从准确性、主题相关性和具体性三个维度打分(满分 120),四个配置的结果分别为:纯基座模型 42 分、续写适配器 56 分、指令适配器 84 分、指令适配器加检索 88 分。指令微调带来的跃升最为明显,检索增强则提供了额外但有限的增益。
绝对准确性仍然偏低:无检索时 40 题中答对 14 题,有检索时答对 20 题。这说明轻量级领域模型在事实性问答上仍有明显短板,更适合作为辅助工具而非权威知识源。
检索增强生成(RAG,Retrieval-Augmented Generation) 是指在模型生成答案前,先从外部知识库检索与问题相关的文档片段,将其拼入提示上下文,让模型基于检索到的证据作答。RAG 可缓解模型参数中事实知识不足的问题,并提高答案的可追溯性。本文的“指令适配器加检索”配置即在提示中注入检索到的压载水相关段落,使评分从 84 分升至 88 分,答题正确数从 14/40 提升到 20/40。但增益有限,说明检索只能提供上下文线索,模型自身的推理与事实核验能力仍是瓶颈;若检索质量不佳或模型忽略证据,RAG 的效果会打折扣。
两个负面结果与评测局限
作者如实报告了两个负面结果:一次被回退的关键词过滤修复,以及一次在 100 步内就过拟合的指令训练。后者提示小规模问答数据下需要更谨慎的早停策略。
评测本身也存在局限:仅使用一个小规模提示集,未测量评分者间一致性,且参考答案由模型生成。这些因素都可能影响分数的可靠性,读者在解读 84 分与 88 分的差距时应保持审慎。
对轻量级领域模型的启示
MarineSparkLM-4B 的价值不在于刷榜,而在于展示了一条可复现的路径:用极低比例的参数更新,在单台工作站上完成领域适配。对于海洋工程这类文本稀缺、标注昂贵的垂直领域,两阶段策略——先领域续写、再指令对齐——比单一微调更有效。同时,检索增强虽能提升主题相关性,却无法根本解决准确性不足的问题,未来可能需要结合更高质量的领域问答数据或检索验证机制。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。