Matt Pocock Skills 全解析:把 AI 编程从聊天变成工程
Matt Pocock 的 AI 编程 Skills 将开发流程工程化:需求讨论→技术文档→拆任务→TDD 逐个实现,告别「一句话让 AI 写代码」的失控体验。
本文介绍了 Matt Pocock 设计的一套 AI 辅助软件开发方法论(Skills),旨在解决「Vibe Coding」中需求模糊、反复出 bug、AI 没 get 到意图的痛点。其核心是把 AI 开发最佳实践写成 Agent 可执行的工作流:先通过专项 Skill 与 AI 充分讨论需求(AI 会连续追问十几个细节),生成技术规格文档(SPEC)并发布到 GitHub Issue;再将需求拆分为多个小任务,每个任务在独立的上下文窗口中以 TDD 方式实现,完成后立即 code review、提交并关闭 Issue。整个流程通过 AGENTS.md 文件统一控制 AI 行为边界,通过 ADR 沉淀架构决策,把不可控的对话式生成变成可审查、可回溯的工程化开发。
从「对话式编程」到「工程化编程」
很多人对 Vibe Coding(用 AI 写代码)的印象大概是这样的:直接告诉 AI「帮我加一个支付功能」,等上两三分钟,AI 要么直接甩出一堆代码说写好了,要么压根没 get 到需求。你打开一看,效果没实现,代码在糊弄,最后还得自己回去返工。这种沟通不顺畅、反复出 bug 的体验,几乎是每个用 AI 写代码的人都踩过的坑。
Matt Pocock 的这套 Skills 试图解决的正是这个问题。它的本质是把「如何用 AI 开发软件的最佳实践」写成了 Agent 可执行的工作流——说白了,就是一组预先准备好的提示词文件,我们直接调用即可。核心方法论并不复杂:先和 AI 一起讨论需求生成技术文档,再把文档拆成一个个小任务,然后让 AI 用 TDD(测试驱动开发)逐个实现,最后通过代码审查完成提交。
这一整套流程的关键词是工程化。它不再把 AI 当成一个「一步到位」的黑盒,而是把软件开发拆解成可控、可审查、可回溯的工程步骤。
TDD(测试驱动开发,Test-Driven Development)是这套方法论的重要支柱。其核心思路是「先写测试,再写实现」:在编写业务代码之前,先定义好该功能应满足的测试用例,让测试先失败(Red),再编写最小可用的实现让测试通过(Green),最后重构代码(Refactor)——这个循环通常被称为 Red-Green-Refactor。对 AI 辅助编程而言,TDD 有额外的价值:测试用例本身就是对需求的精确描述,AI 在实现时有明确的「完成标准」可以对照,从而大幅减少「功能写完了但行为不对」的情况。每个小任务完成后运行测试,测试通过即视为该任务完成,这也让代码审查环节有了客观依据,而不只依赖人工主观判断。
安装与项目初始化
安装方式本质上就是把 Skill 文件夹放到固定位置。通过 npx 命令即可完成安装(前提是装好 Node 环境),安装时会让你选择放到项目级还是全局通用位置。如果希望所有 IDE Agent 都能用,建议放到全局。安装过程中会有一堆 Skill 供选择,可以全选,也可以按需勾选。
安装完成后第一件事是执行初始化命令,对项目进行初始化。演示中作者新建了一个极简项目——只实现读(Get)和写(Set)两个接口,用来演示整个流程。初始化过程中会涉及一个重要选择:要不要把项目推到 GitHub。
这里有个实用的省时技巧:Git 的 init 和 push 操作可以自己手工完成,然后直接告诉 AI「已完成 git init 和 git push」,避免让 AI 重复做这些机械操作浪费 token 和时间。
初始化还会让你确认任务标签体系,默认是英文的五个标签(准备中、准备给 Agent、准备给人类、需要完成等),可以让 AI 换成中文标签。这些标签用于给每个任务打上分层信息,标注哪些交给 Agent 处理、哪些需要人工介入。
初始化完成后,项目根目录会生成一系列文件:一个 AGENTS.md 类型的说明文件(这个命名比 CLAUDE.md 更通用,Codex、Cursor 等各类 Agent IDE 都支持),以及 context 目录和 ADR(架构决策记录)等技术文档。这些文件的作用在于,AI 下次工作时会读取它们,从而更好地理解项目背景和你的要求。
ADR(Architecture Decision Record,架构决策记录)是软件工程中用于记录重要技术决策的文档格式,由 Michael Nygard 在 2011 年提出并广泛采用。每份 ADR 通常包含:决策背景(为什么要做这个决定)、被考虑的备选方案、最终选择及其理由,以及预期的后果。在 AI 辅助开发的场景下,ADR 的意义尤为突出:AI 模型本身没有项目记忆,每次开启新会话都是「失忆」状态。把关键技术决策沉淀为 ADR 文件,AI 读取后就能理解「为什么用 TOML 而不是 YAML」「为什么选 Gin 而不是标准库」,避免在后续任务中给出与已有架构相矛盾的建议。这也是为什么初始化后生成的这些文件,是整套工程化方法论能够持续运转的基础设施。
需求讨论:让 AI 把细节全部问一遍
真正开始干活的第一步不是写代码,而是讨论需求。这里用到的 Skill 叫 glow-with-document。
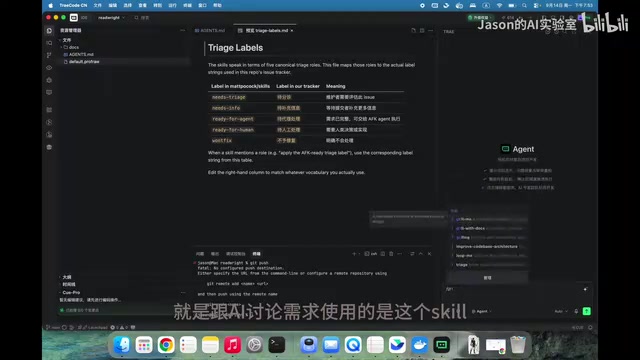
作者只提了一句极简需求:「实现读和写两个 API,写过的能读到,同时保存到 Redis,重复写入就覆盖。」但 AI 随后开始了一轮又一轮的「拷问」,从 Q1 一路问到了 Q13:
- 是单 key 还是多 key?(答:多 key,key 为任意正整数,value 为字符串)
- HTTP 框架用标准库还是 Gin?(答:Gin,功能更多)
- Redis 客户端选哪个?(答:go-redis)
- 配置文件格式?(答:TOML)
- 写接口用 POST 还是 PUT?状态码怎么处理?要不要加鉴权、加前缀?值永不过期还是设 TTL?
这个过程的价值在于,它把所有实现细节都提前过了一遍。作者坦言演示项目很简单,但真实项目往往复杂得多,把需求明确清楚这一步就更加重要。需求越明确,AI 越有底,你也越有底,后面才不会出现「AI 没 get 到需求」的尴尬。这一步之后会生成技术需求文档(SPEC),并发布到 GitHub Issue 上。
拆任务与小步快跑实现
需求文档确认后,用 to-tickets 类的 Skill 把 SPEC 拆成多个小任务,并创建成 GitHub Issue。
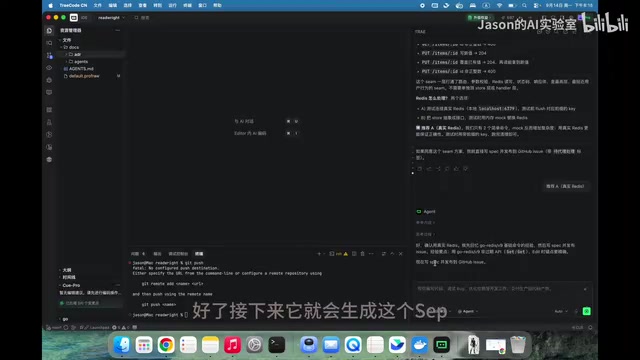
演示中把项目拆成了四个任务:先搭脚手架,再写 PUT 接口,再写 GET 接口,最后做验证。拆完之后 AI 会确认颗粒度是否合适。把任务拆到 GitHub Issue 上的好处是可以像做正式开发一样管理进度。
接下来是整套方法论的精髓——小步快跑。每个 Issue 单独实现,实现完就审查、提交、关闭。这里作者反复强调一个关键实践:每实现一个任务就新建一个上下文窗口。原因有二:一是避免上文污染,前面的需求讨论上下文不需要带到实现阶段;二是省钱省时,因为每条对话都要把历史记录重新请求一遍,长文本会消耗大量 token。
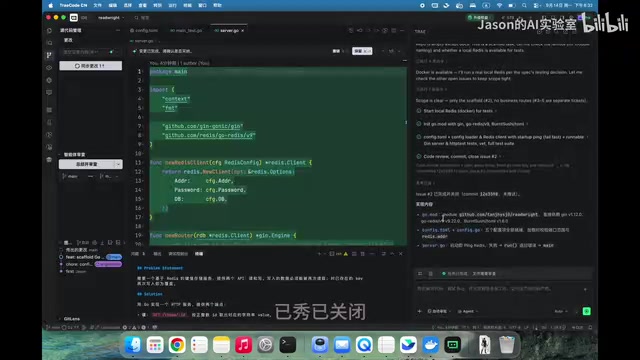
实现过程中 AI 会自动做 code review、提交代码、关闭 Issue。但作者也给出了一个重要的控制技巧:如果你不希望 AI 自动提交、自动关闭 Issue,可以把要求明确写进 AGENTS.md 文件——比如「git commit 之前需向我确认,我确认之后方可提交和关闭 Issue」。经作者实测,写明后 AI 确实不会擅自执行这些操作。这个文件几乎每次开启会话时都会被读取,AI 会理解并遵守你的要求。
「上下文窗口污染」是大语言模型在长对话场景中的常见问题。模型在生成回复时,会将当前会话的全部历史记录作为输入,这意味着越早期的内容(比如需求讨论中的发散性问答)会持续占用 token 配额,并可能干扰模型对当前任务的判断——例如将已被否决的方案误当成仍有效的约束。每个任务新开上下文窗口,相当于给 AI 一张「干净的工作台」,只放入当前任务的 Issue 描述和必要的技术文档(SPEC、AGENTS.md 等),既减少了无效 token 消耗,也让 AI 的注意力更集中。这与人类工程师「一次只专注一张票」的工作习惯在认知逻辑上是一致的。
测试验证与方法论小结
四个任务全部完成后,Redis(示例用 Docker 启动)和接口代码都已就绪。测试环节,作者直接让 AI 给出 curl 命令来测试两个接口:写入一个值再读出来,验证读写逻辑正确。对于 Web 类项目,也可以直接打开地址点点看;API 类则可以用 Postman 或 curl 验证。
值得一提的是,这个极简项目结构写得很扁平,没有分文件夹,因为 AI 判断没这个必要。如果想要更规范的结构,可以通过增加任务的方式让 AI 完成。
回顾整套方法论,核心链条清晰可复用:
- 讨论需求 → 让 AI 把所有细节问清楚
- 写成技术文档(SPEC)
- 拆成小任务(Tickets / Issues)
- 逐个实现 → 每个任务新开上下文,TDD + code review + 提交
Matt 之所以格外重视这套流程,一个核心原因是 AI「不会自动携带上下文」——如果不把需求和决策沉淀成文档,AI 每次都在瞎猜。这套 Skills 里还有一些辅助工具,比如 ask-matt,当你不知道该用哪个 Skill 时,它会告诉你该调用哪个来完成当前任务。
对于习惯了「一句话让 AI 写代码」的开发者来说,这套流程初看会觉得繁琐,但它真正的价值在于:把不可控的对话式生成,变成了可审查、可回溯、可协作的工程化流程。当项目规模变大时,这种前期的「麻烦」恰恰是避免后期返工的保障。
相关推荐
西伯利亚冰雪公主与斯基泰世界的考古之谜
西伯利亚冰雪公主是阿尔泰乌科克高原冰封墓葬中出土的斯基泰女性木乃伊,其纹身、丝绸与随葬品揭示了古代游牧文明的艺术、社会结构与跨区域交流。本文梳理其考古价值与相关争议。
SQL 行模式匹配:用 MATCH_RECOGNIZE 实现"行级正则"
MATCH_RECOGNIZE 让 SQL 拥有"行级正则"能力,用类正则语法匹配连续行序列,轻松检测暴力破解、交易异常、用户行为路径等顺序模式,告别繁琐的自连接与窗口函数。
黑客攻入Flock监控摄像头,暴露车牌识别系统内幕
黑客成功入侵Flock Safety的车牌识别监控摄像头,暴露了ALPR系统的内部运作机制。本文解析事件经过、系统工作原理及其引发的隐私与数据安全争议。