Maya a1选项顺序敏感度研究:非自回归模型的隐藏偏见

Laya非自回归模型对选项顺序高度敏感,25.8%的问题答案会翻转。
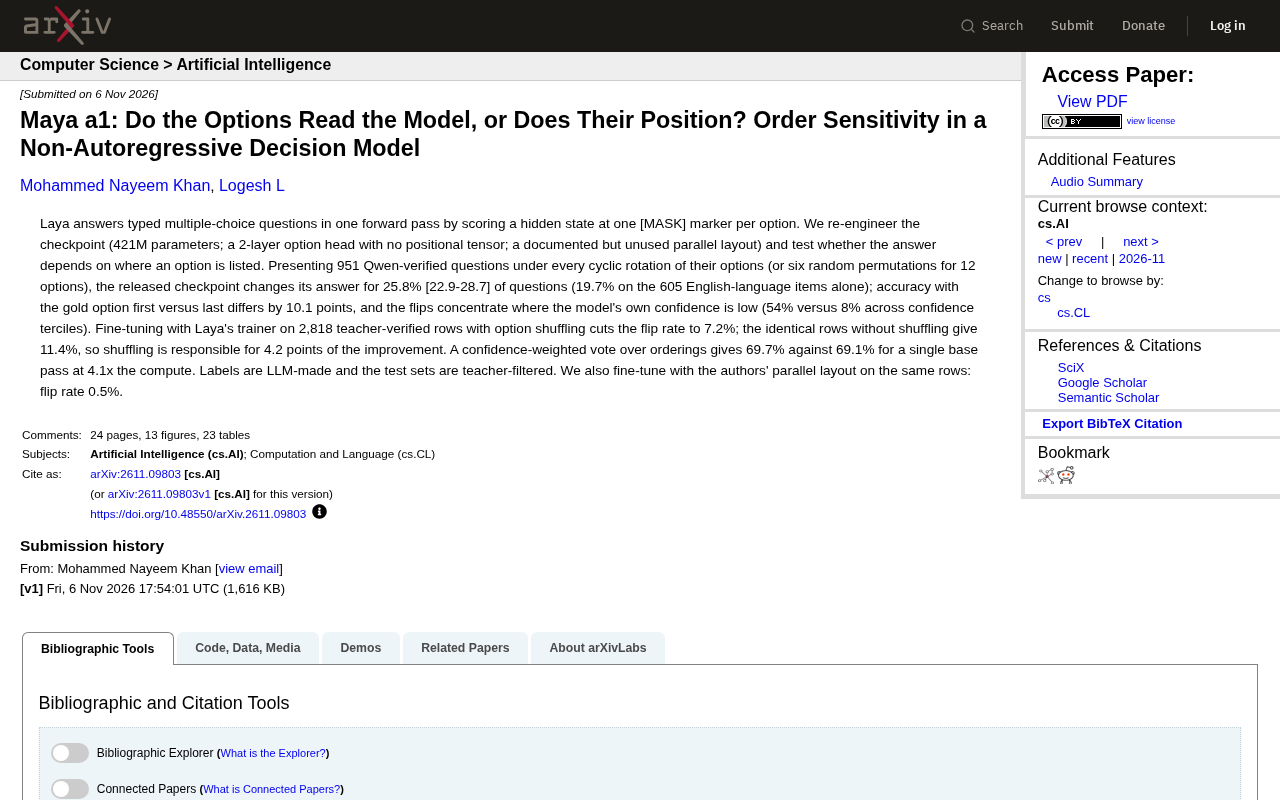
一项针对Laya非自回归决策模型(文中称Maya a1)的研究发现,模型对选项顺序异常敏感:在25.8%的问题上答案会因选项排列而改变,英语问题翻转率为19.7%。正确选项位于首位与末位时准确率相差10.1个百分点,翻转集中发生在低置信度区域(最低三分位翻转率54%,最高仅8%)。微调中加入选项洗牌可将翻转率从11.4%降至7.2%,洗牌贡献4.2个百分点;使用并行布局微调后翻转率进一步降至0.5%。置信度加权投票提升有限(69.7% vs 69.1%),计算量增加4.1倍。研究提示非自回归模型仍存在隐蔽的位置偏差,架构选择对鲁棒性影响显著。
非自回归模型能否真正理解选项含义?一项针对Laya模型(文中称为Maya a1)的新研究给出了令人警惕的答案:模型对选项顺序的敏感度远超预期,答案会因选项排列而改变。
研究背景:非自回归决策模型
Laya模型采用非自回归架构,每个选项对应一个[MASK]标记,模型在一次前向传播中为每个选项打分并选择最高分。研究团队重新设计了检查点(421M参数,2层选项头,无位置张量,存在并行布局但未使用),以测试选项位置是否影响答案。
这种设计原本旨在消除自回归模型从左到右的偏见,但实验显示,位置信息可能以更隐蔽的方式渗入决策。
非自回归模型与自回归模型的对比
自回归模型(如GPT系列)按从左到右的顺序逐个生成token,每个token的生成都依赖于之前已生成的token,这种顺序性天然引入了位置偏见:模型可能更关注靠前的选项或信息。非自回归模型则并行地一次性生成所有输出位置,不依赖生成顺序,理论上能消除从左到右的偏见。Laya模型即采用这种架构,为每个选项分配一个[MASK]标记,通过一次前向传播同时为所有选项打分,然后选择最高分对应的选项。这种设计旨在提升推理效率并避免顺序偏差,但本研究揭示,位置信息仍可能通过其他机制(如选项头的参数或训练数据中的隐含模式)影响决策。
实验设计:循环旋转与随机排列
研究使用了951个经Qwen验证的问题,对每个问题的选项进行所有循环旋转(12选项时使用6个随机排列)。结果显示,发布检查点在25.8%的问题上会改变答案(置信区间22.9-28.7%),在605个英语问题上翻转率为19.7%。
当正确选项位于首位与末位时,准确率相差10.1个百分点。翻转集中发生在模型自身置信度较低的区域:置信度最低的三分位翻转率达54%,而最高三分位仅8%。
循环旋转与排列测试
循环旋转是一种系统性的选项重排方法:对于N个选项,通过将选项列表循环移动1位、2位……直到N-1位,生成N-1种不同的排列(原始顺序保留为基准)。例如,选项[A,B,C]的循环旋转包括[B,C,A]和[C,A,B]。这种方法能有效检测模型是否对选项的绝对位置敏感,同时控制选项间的相对顺序变化。当选项数量较多(如12个)时,全排列数量巨大,因此研究采用随机抽样(如6个随机排列)来近似评估。通过比较模型在不同排列下的答案一致性,可以量化顺序敏感度。
微调能缓解顺序敏感度
研究团队使用Laya训练器在2,818行教师验证数据上微调,并加入选项洗牌。洗牌后翻转率降至7.2%,而不洗牌时为11.4%,说明洗牌贡献了4.2个百分点的改进。
对顺序进行置信度加权投票得到69.7%的准确率,而单次基础通过为69.1%,计算量增加4.1倍,提升有限。
研究还使用作者的并行布局微调同一数据,翻转率降至0.5%,显示架构选择对顺序敏感性有显著影响。
置信度加权投票
置信度加权投票是一种集成策略:对同一问题的多个选项排列分别进行预测,并根据模型对每个预测的置信度(如softmax概率)进行加权投票,最终选择加权得分最高的选项。理论上,如果模型对某些排列的预测置信度较高,这些预测应在投票中占更大权重,从而提升整体准确性。但本研究中,该方法仅将准确率从69.1%提升至69.7%,而计算量增加4.1倍,表明模型置信度与预测正确性之间的校准并不理想,简单加权投票收益有限。
多源验证与局限
该研究由独立团队进行,与作者原始报告形成交叉验证。标签由LLM生成,测试集经过教师过滤,可能存在偏差。
顺序敏感度问题在非自回归模型中普遍存在,这项研究为模型鲁棒性评估提供了新视角。
LLM生成标签与教师过滤的偏差风险
本研究使用大型语言模型(LLM)生成问题标签,并经过“教师”模型(可能为更强大的LLM或人工规则)过滤测试集。这种流程虽然能快速构建大规模评估数据,但存在固有偏差:LLM生成的标签可能反映其自身的知识偏差或幻觉,而教师过滤可能引入选择偏差(如只保留教师模型认为正确的样本),导致测试集不能完全代表真实分布。此外,独立团队交叉验证虽能提高可信度,但若双方使用相似的LLM生成标签,偏差可能仍然存在。因此,结论的泛化性需谨慎对待。
相关推荐
GPT-6.2 Astra与Sol发布:双模型架构与社区热议
OpenAI 发布 GPT-6.2,包含 Astra 与 Sol 两个模型。本文梳理官方公告与 Hacker News 社区讨论,分析双模型架构对开发者的潜在影响与选型建议。

Gmod TTT 埃及主题地图:太空资本主义与法老对决
探索Gmod TTT埃及主题地图的趣味玩法:玩家选择法老等角色,通过立方体传送到太空,展开资本主义与共产主义的幽默对决,并体验道具战斗的混乱乐趣。

GraphRAG:超越搜索,实现全局知识发现
GraphRAG 是微软研究院推出的知识图谱增强检索技术,超越传统 RAG 的局部搜索,实现全局性知识发现。本文介绍其核心理念、代际演进及医疗领域应用案例。