MCP 调用失败排查指南:握手、鉴权、超时与返回异常
MCP 将软件能力封装为大模型可调用的工具,故障应按握手、鉴权、超时、返回四层排查。
文章从 MCP(Model Context Protocol)的价值定位出发,指出传统接口面向程序设计,大模型无法直接理解方法名、参数与返回结构,而 MCP 通过将已有软件能力包装成带名称、功能描述和 schema 定义的工具,使大模型能在需要时主动调用并基于真实数据生成答案。在此基础上,文章提出一套从外到内的分层排查顺序:先确认初始化握手完成、协议版本与能力声明正常、工具列表可枚举;再验证鉴权,区分认证失败与授权失败;然后对超时分段计时,重点排查工具执行阶段的下游依赖而非盲目调大阈值;最后核对返回结构是否符合工具声明、错误是否被正确标记。文章强调返回异常比显式失败更危险,建立分层排查习惯比记住具体报错更有长期价值。
MCP(Model Context Protocol)正在成为 AI Agent 开发中连接大模型与外部工具的关键协议。但在实际调试中,调用失败往往比想象中更隐蔽——握手失败、鉴权被拒、超时无响应、返回数据格式异常,每一层都可能出问题。本文基于一次系统性讲解,梳理 MCP 的价值定位与一套可落地的故障排查顺序。
为什么需要 MCP:从“给程序用的接口”到“给大模型用的工具”
在传统开发模式中,我们沉淀了大量软件系统——电商、库存、商品查询,每个系统背后都有成百上千个接口。这些接口的设计对象是程序:Java 的 service 层、PHP 的方法调用,参数是什么、返回值是什么,程序员一看就懂。
但大模型不是程序员。你无法直接对 DeepSeek广告 说“帮我调一下那个 search 方法”,它不知道这个方法存在,也不知道参数怎么传、什么场景下用、返回什么结构。正如讲解中所说,大模型面对传统接口“就跟非科班的人一样,看不懂这句代码”。
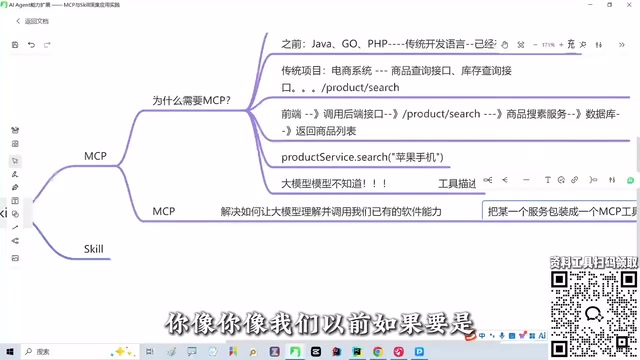
MCP 解决的正是这个问题:把已有的软件能力包装成大模型能理解并调用的“工具”——告诉它工具叫什么名字、功能是什么、参数和返回值如何定义。这样当用户问“帮我推荐一台适合开发的电脑”时,大模型发现自己训练数据里的信息不够,就会主动调用你封装好的 MCP 工具,工具再去请求公司内部接口、查询数据库,拿到真实库存和价格后返回,大模型再基于真实数据生成答案。
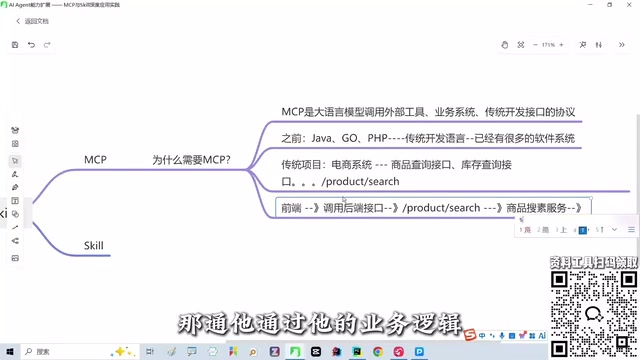
理解了这条链路,排查就有了地图:一次 MCP 调用涉及协议握手、身份鉴权、网络传输、工具执行和结果返回多个环节,任何一环断裂都会表现为“调用失败”。
Model Context Protocol(MCP) 是由 Anthropic 于 2024 年底提出的开放协议,采用客户端-服务端架构:MCP 客户端(通常内嵌于 AI 应用或 IDE)与 MCP 服务端(封装具体工具能力)通过标准化消息进行交互。协议基于 JSON-RPC 2.0 定义请求、响应与通知三类消息,并在初始化阶段协商协议版本与双方支持的能力(capabilities),例如工具、资源、提示模板等。正是这套标准化的能力声明与工具描述机制,使得大模型无需硬编码即可发现并调用外部系统。理解 MCP 的协议分层——传输层(如 stdio、Streamable HTTP)、消息层(JSON-RPC)与能力层(tools/resources/prompts)——是后续按层排查故障的基础。
排查第一步:确认握手是否完成
MCP 调用失败时,最先要确认的不是工具逻辑,而是会话是否真正建立。握手阶段负责协商协议版本、交换能力声明,如果这一步没有完成,后续所有工具调用都无从谈起。
实践中常见的握手问题包括:客户端与服务端协议版本不匹配、能力声明缺失导致工具列表为空、传输层连接未就绪就发起了调用。排查时应先确认初始化响应是否正常返回,再看工具列表能否被正确枚举。如果工具列表为空,问题大概率不在业务代码,而在握手与能力协商环节。
MCP 的初始化握手(initialize) 是一个明确的三步流程:客户端发送 initialize 请求,携带自身支持的协议版本与能力;服务端返回其协议版本与能力声明;客户端再发送 initialized 通知,会话才正式进入可用状态。若协议版本不匹配,服务端应返回错误而非静默降级;若任一方的能力声明中未包含 tools,则工具列表自然为空。此外,握手必须发生在传输层连接建立之后——使用 stdio 传输时进程需已启动,使用 HTTP 传输时连接需已就绪。排查时可直接观察 initialize 响应中的 protocolVersion 与 capabilities 字段,这是判断握手是否真正完成的最直接依据。
排查第二步:鉴权是否通过
握手成功后,下一个卡点是鉴权。MCP 服务端通常需要验证调用方身份,凭证缺失、过期或权限范围不足都会导致请求被拒。
这一层的排查要点是区分“认证失败”与“授权失败”:前者是身份不被认可,后者是身份合法但没有访问该工具的权限。两者返回的错误信息往往不同,混为一谈会浪费大量时间。建议在排查时单独用最小请求验证凭证有效性,再逐步检查具体工具的权限配置。
排查第三步:超时问题如何定位
超时是 MCP 调用中最容易被误判的一类故障——表面看是“没反应”,实际可能发生在链路的不同位置。
定位超时需要分段计时:连接建立耗时、请求发送到服务端接收的耗时、工具实际执行耗时、结果回传耗时。如果工具内部要查询数据库或调用下游接口,执行阶段往往是超时高发区。此时应优先确认下游依赖的响应情况,而不是盲目调大超时阈值——阈值调大只是掩盖问题,不是解决问题。
MCP 调用中的超时可能来自多个独立的超时配置叠加:传输层连接超时、JSON-RPC 请求的整体超时、服务端内部调用下游依赖(数据库、第三方 API)的超时,以及客户端等待响应的超时。这些阈值往往由不同组件分别设置,任一层先触发都会表现为“调用无响应”。因此分段计时的关键在于区分“请求是否已到达服务端”与“服务端是否已开始执行工具”:前者可通过服务端访问日志确认,后者可通过工具内部埋点或下游依赖的调用日志确认。只有定位到具体是哪一段耗时异常,调大对应阈值才有意义;否则单纯放宽客户端超时只会延长等待,无法解决根因。
排查第四步:返回异常与数据格式问题
即使请求成功抵达并执行完毕,返回结果仍可能出问题。常见情形包括:返回结构不符合工具声明的 schema、字段缺失或类型不符、错误信息被包装成正常返回导致大模型误判。
这一类问题的特点是“调用看似成功,但大模型用不了结果”。排查时应核对工具定义中的返回结构与实际返回是否一致,并检查错误分支是否被正确标记。对 Agent 开发而言,返回异常比显式失败更危险,因为它会让大模型基于错误数据继续推理。
一套可复用的排查顺序
把上述环节串起来,MCP 调用失败的排查应遵循从外到内的顺序:先确认握手与会话建立,再验证鉴权与权限,然后分段定位超时,最后检查返回结构与错误标记。这个顺序的价值在于每一层都能排除一批可能性,避免在业务逻辑里盲目打转。
MCP 的本质是让大模型理解并调用已有软件能力,链路越长,故障点越多。建立分层排查习惯,比记住某个具体报错更有长期价值。
相关推荐
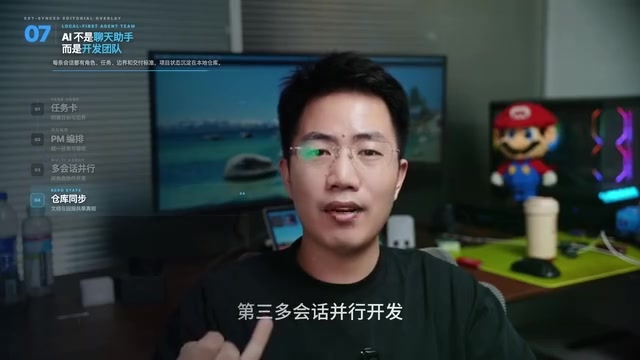
多Agent协作开发:任务卡驱动的中大型AI项目实践
一条对话搞不定中大型项目?B站UP主分享任务卡驱动、PM编排、多Agent并行开发、本地仓库共享状态的AI协作开发模式,让任何Agent工具随时接手项目。
Cursor vs Copilot vs Claude Code:Laravel开发者怎么选
对比Cursor、GitHub Copilot与Claude Code三款AI编程工具在Laravel开发中的定位差异:Cursor是AI优先编辑器,Copilot是现有编辑器的插件,Claude Code在终端处理多文件任务与测试,并给出按工作流选型的建议。
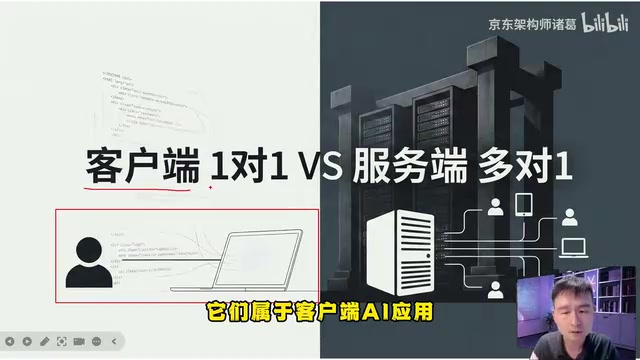
AgentScope Java版:企业级Agent框架实战指南
深入解析阿里巴巴AgentScope Java企业级智能体框架:对比客户端AI与服务端AI的本质差异,阐述Java在高并发、分布式状态管理等场景的天然优势,梳理从核心原理到多智能体协作的完整学习路径。