MCP vs Skill vs 本地工具:分层架构讲清三者边界

MCP 把多模型对接多工具的适配量从乘法变加法,但需算清三笔成本。
文章澄清了 MCP、Skill 与本地函数并非三选一,而是分属不同架构层的搭配关系:Skill 写业务流程,MCP 对接跨方复用的通用工具,本地函数处理应用内轻量逻辑。MCP 通过 JSON-RPC 2.0 统一消息格式,STDIO 与 Streamable HTTP 只是传输链路不同,服务端以工具、资源、提示词三类能力对外,其中工具层的 Input/Output Schema 保证了入参与返回的一致性,权限规则也全部收敛在服务端。其核心价值是把 N 个模型对接 M 个工具的工作量从 N×M 压成 N+M。但 MCP 并非免费午餐,多一跳链路带来延迟、独立服务端增加运维负担、链路变长推高排错难度。只有当工具需要跨模型跨团队复用或具备独立权限边界时才值得上,单应用少量工具用本地函数更省事。
很多团队在接入大模型工具时,都面临一个看似是「选型」、实则是「分层」的问题:到底该用 MCP、Skill,还是本地函数?B站的这期视频用一个真实的生产场景把这层窗户纸捅破了——三家不同厂商的模型、17 套私有 Skills、23 个本地脚本工具,却要让所有模型统一调用三个核心能力。如果逐个适配,工作量是乘法;而 MCP 把它变成了加法。
MCP 到底解决了什么问题
MCP 全称是模型上下文协议(Model Context Protocol)。它要解决的问题很朴素:一个大模型应用想调用外部工具,中间这一层该怎么连、怎么发请求、怎么收返回。以前每家各写一套协议,现在用同一套格式来写。
MCP 里有两个核心角色:客户端(通常是你的 Agent 应用)和服务端(真正执行能力的程序)。两边通过 JSON-RPC 2.0 通信,收发的都是结构化请求和响应。
连接方式有两种:本机进程之间走标准输入输出,叫 STDIO 模式;远程服务之间走 HTTP,叫 Streamable HTTP 模式。所以本地和远程在 MCP 里并非两套体系,只是换了条传输链路,消息格式完全一致。
服务端对外提供三类能力:工具、资源、提示词。工具是可执行的动作,资源是可读取的上下文数据,提示词是可复用的指令模板。其中工具层最关键:客户端发 list 指令,服务端返回一张工具清单,每个工具带有名称、功能说明和输入参数的 JSON Schema(Input Schema)。模型就是看着这张清单和参数说明,自主决定调用哪个工具、传什么参数。真正调用时发 call 指令,带上工具名和参数,返回结果可以是文本、图片,也可以是结构化 JSON,对应 output schema 与结构化内容规范。
JSON-RPC 2.0 是一种轻量级的远程过程调用协议,用 JSON 格式封装请求和响应。它将调用分为请求(带 id、method、params)和通知(不带 id,无需响应)两类,响应则包含 result 或 error 字段。MCP 选择它作为通信底座,是因为它足够简单、跨语言支持广泛,且天然支持双向通信——服务端也能主动向客户端发送通知(例如工具清单变更)。相比 REST,JSON-RPC 不绑定 HTTP 语义,STDIO 和 Streamable HTTP 两种传输可以复用完全相同的消息体,这正是 MCP 能做到“换链路不换格式”的前提。
Input Schema 本质上是一份 JSON Schema,用来描述工具入参的类型、必填项、取值范围和嵌套结构。它的价值在于把“参数该长什么样”变成机器可读的契约:模型侧依据它生成符合格式的调用参数,服务端依据同一份 schema 做校验,两边不会各说各话。Output Schema 则约束返回结果的结构,配合结构化内容规范,让客户端拿到的是可预测的 JSON 字段,而非需要再解析的自由文本。没有这层 schema,模型容易编造参数名或漏传必填字段,错误只能等到服务端执行时才暴露;有了 schema,很多问题在调用发起前就能被拦截。
Skill 与本地工具的真实定位
Skill 本质上是一份能力说明书:一个目录里放一个 skill.md,写清楚这个能力做什么、什么时候用、怎么用,需要的话再挂载几个脚本和参考资料,宿主程序按需加载。视频里特意纠正了一个常见误解——Skill 格式本身是开放的,所有宿主都能读取,谈不上私有绑定。它真正的问题是只解决「这件事该怎么做」,是一份作业指导书,并不定义工具该怎么被统一调用。
本地工具(也就是常说的本地函数)直接写在业务代码里,能力常住在应用内部,换个应用就带不走了。
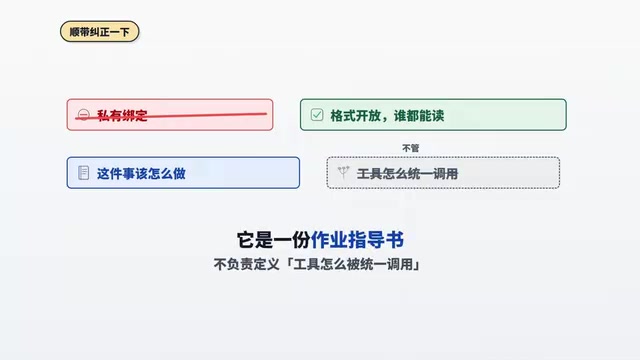
所以三者根本不是三选一的关系。实际落地时,通常是 Skill 写业务流程,MCP 对接通用工具,本地函数处理那些只在本应用内使用、不值得单独部署的轻量逻辑。三层各管一件事,比硬要二选一合理得多。
乘法变加法:一致性与权限的归属
回到开头的场景。三家厂商的模型、三个核心能力,如果按 Skill 或本地工具的思路走,就是三家模型乘以三个能力,一共九套适配工作,每套要对其参数、返回格式和权限规则,每新增一个能力适配量还要再乘一轮。换成 MCP,就是三个工具服务端加一套通用客户端实现,工作量从相乘变成相加。
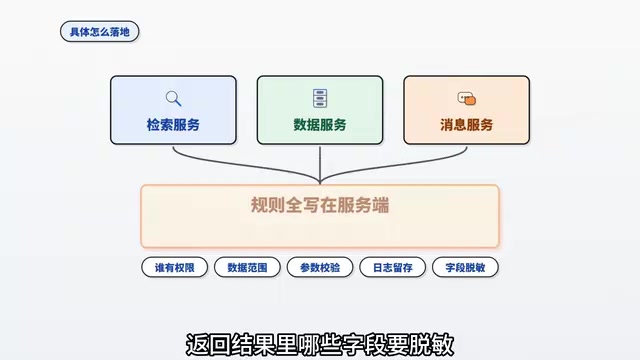
具体落地时,三个核心能力各做一个独立服务端。每个服务端自己管好自己的事:谁有权限调用、能调用多大数据范围、参数怎么校验、日志留存多久、返回结果里哪些字段要脱敏。所有规则都写在服务端,所有模型共用同一套规则。
一致性从哪来?两个层面。版本升级方面,MCP 连接有生命周期,建立连接时先握手协商双方支持的协议版本和能力范围;如果服务端声明工具清单支持动态变更,更新时可主动推送通知,客户端收到后重新拉取工具清单即可。能力迭代只改服务端,客户端下次刷新就能拿到最新版本,不用人工去 17 套 Skill 里逐个改。如果协商不到兼容的协议版本,连接会直接断开,不会静默跑错逻辑。
入参与返回的一致,则靠 input schema 统一约束:模型侧按同一份 schema 生成参数,服务端按同一份 schema 做校验;返回结果靠 output schema 加结构化内容规范,客户端拿到的是有固定结构的 JSON 而非自由文本。权限也在服务端统一健全,HTTP 链路用令牌或密钥拿凭证,权限范围的判断也全部收敛在服务端,不用每个模型侧各写一套。
MCP 连接的生命周期从初始化握手开始:客户端发送自己支持的协议版本与能力,服务端返回选定版本及自身能力声明,双方确认兼容后才进入正常收发阶段。如果版本无法协商一致,连接会直接终止,避免用不匹配的语义继续通信。进入正常阶段后,双方通过能力声明约定各自支持哪些特性,例如服务端是否支持工具清单动态变更、是否支持资源订阅。当服务端声明支持清单变更时,可在工具增删改后主动推送通知,客户端收到后重新拉取清单即可完成热更新,无需重启或人工干预。这套机制是“只改服务端、客户端自动跟进”的技术基础。
MCP 不是免费午餐:三笔成本要算清
第一,多了一跳链路。远程服务会多一次网络往返,对延迟特别敏感的工具要慎重,能放本地走 STDIO 就尽量放本地。
第二,增加了运维成本。服务端独立部署,得有人管版本、证书、鉴权和限流。以前写个本地函数就完事,现在多了一个需要长期维护的独立服务。
第三,排错难度变高。调用链路变长,出错可能在模型、客户端或服务端任意一环,得打通全链路日志才能排查。
要不要上 MCP,判断标准很直接:如果是单应用单模型、工具也就两三个,写本地函数最省事。只有当工具需要在多个模型、多个团队之间复用,或者工具本身有独立的权限和数据边界时,才值得上 MCP。为了「统一」两个字给三个内部小工具硬搭一套服务端,纯属过度设计。
一致性要可验证,而不是靠口头保证
验证一致性有三步:用同一批测试用例对着所有接入的客户端跑一遍,核对入参与返回结构是否完全一致;给每个服务端做 schema 校验测试,故意传错参数类型、漏传必填字段,看能否返回明确错误提示;权限要做负向验证,用无权限账号调用必须被拦截拒绝。升级先灰度,单台服务端盯着对应模型的调用错误率和超时率,指标稳定后再全量铺开。
MCP 的核心价值,就是把 N 个模型对接 M 个工具的适配工作量,从 N×M 压成 N+M。要不要上,就看你手里的工具是不是真的需要跨多方复用。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。