MCP从0到1:搭建生产级MCP服务器实战全攻略
从USB-C类比出发,系统讲解如何将MCP Server从本地脚本升级为可弹性扩展的Kubernetes生产集群。
本文以「AI时代的USB-C接口」为切入点,介绍了模型上下文协议(MCP)的三角色架构(Host/Client/Server),并以Server的生产化改造为主线,逐层拆解企业级部署的完整路径。文章指出,Stdio模式虽开箱即用,但因与进程生命周期绑定而无法横向扩展,生产环境必须转向无状态的Streamable HTTP。在此基础上,文章提炼出企业级架构的四大支柱:无状态设计、环境变量注入、健康检查探针与全链路追踪,并进一步演示了如何通过Docker HEALTHCHECK与Nginx实现容器健康管控和负载均衡,最终以Kubernetes的双探针机制(Liveness/Readiness)和kube-proxy路由收尾,构建出具备自愈能力的弹性云端集群。
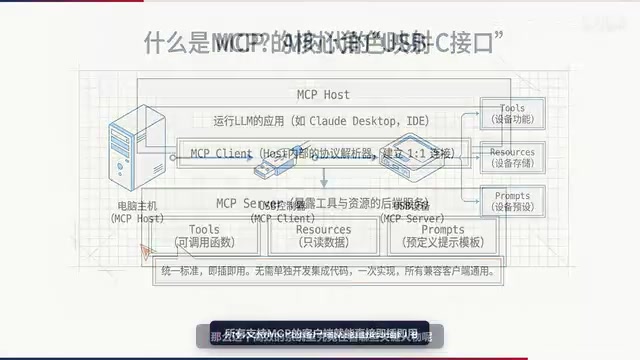
MCP是什么:AI时代的USB-C接口
在模型上下文协议(MCP,Model Context Protocol)出现之前,把各种数据源和本地工具接入大模型几乎是一场架构灾难。开发者不得不为每一个不同的模型反复编写缺乏复用性的「胶水代码」,维护成本居高不下。
MCP的意义,正如B站UP主在视频中的比喻——它是「AI时代的USB-C接口」。现在谁出门还愿意带一堆转接头和专用充电线?AI开发同样如此。MCP提供了一套统一标准,只需实现一次后端,所有支持MCP的客户端就能即插即用。
这个系统由三个核心角色构成:
- Host(宿主):运行大模型的环境,比如你的IDE或Claude Desktop;
- Client(客户端):寄生在Host内部,负责解析协议、建立连接;
- Server(服务器):默默干活的一方,负责把底层的工具、资源和提示词暴露给大模型。
本文的全部重点都在Server上——目标是把它从一个简陋的本地脚本,打造成能扛住海量请求的工业级服务。
传输协议对比:从Stdio到Streamable HTTP
三个角色在代码世界里如何通信?关键在于传输协议的选择。
Stdio(标准输入输出) 是给新手准备的「辅助轮」。它免网络配置、开箱即用,但致命缺陷是与进程的生命周期死死绑定。它适合本地测试,却无法走向真正的云端生产环境。
Streamable HTTP 才是面向生产的选择。它支持HTTP POST加SSE(Server-Sent Events),是一个无状态的传输方式,也是构建高可用集群的绝对基石。
在Stdio模式下写一个Hello World其实非常简单:Server端几行代码暴露工具,Client端一个异步调用即可完成。但这种模式就像一个人对着镜子自言自语——安全简单,却无法把声音传给整个体育场。它根本无法水平扩展。

这正是从玩具走向生产的分水岭。
SSE(Server-Sent Events)是一种基于HTTP的单向实时推送技术:服务器可以在一个持久连接上持续向客户端推送数据,而无需客户端反复轮询。与WebSocket不同,SSE是单向的(服务器→客户端),但正因如此,它天然兼容HTTP基础设施(如反向代理、负载均衡器),也更容易穿越企业防火墙。在MCP的Streamable HTTP模式中,客户端通过POST发送请求,服务器则通过SSE流式返回工具调用结果。这种组合既保留了HTTP的无状态特性,又能承载大模型生成时逐字输出的流式响应,是当前MCP生产部署的主流选择。
企业级架构的四大支柱
离开localhost的舒适区后,要应对企业级真实场景,有四条「承重墙」没有任何妥协余地。
无状态设计
保证每个请求相互独立,不依赖服务器内存中的会话状态。这是横向扩展的底线——只有无状态,才能随意克隆实例来分摊负载。
环境变量注入
让程序与外部环境彻底解耦。端口、密钥、连接地址都应从环境变量动态获取,而非硬编码。这也是容器化部署的前提。
独立健康检查探针
好比给服务器接上心电图,随时向集群汇报自己的死活状态。后续Docker和Kubernetes都要靠它来「查岗」。
全链路追踪
给每个请求打上UUID。在分布式流量的海洋里,只有这样才能精准定位每一次调用。
落实到代码上,几个关键变化值得注意:端口改为从环境变量动态获取;将 stateless_http 设为 True,一刀剪断「会话绑定」,让服务彻底无状态;并专门手写一个 /health 路由,应对Docker和K8s的健康检查。
全链路追踪(Distributed Tracing)中为每个请求生成的UUID通常被称为Trace ID或Request ID。在微服务或分布式MCP集群中,一次客户端调用可能经过Nginx、多个MCP Server实例、乃至下游数据库等多个节点。如果所有节点的日志都携带同一个Trace ID,运维人员就能在海量日志中将整条调用链串联起来,精准定位延迟瓶颈或异常节点。这一机制与OpenTelemetry等标准化可观测性框架高度兼容,是企业级AI服务排障效率的核心保障。
容器化与负载均衡
企业级代码需要标准化的打包方式,Docker就是那个终极「集装箱」。
在Dockerfile中,除了常规的 EXPOSE 暴露端口,最能体现生产级素养的是 HEALTHCHECK机制。可以把它想象成一位严格的值班医生,每隔30秒就去探测一次 /health 接口,摸一摸容器的脉搏。只有确认返回200 OK(有心跳),容器才会被标记为Healthy,系统才敢把真实流量放进来。

当流量猛增、克隆出几十个健康容器时,就需要一位聪明的「交警」来指挥交通——这就是Nginx。通过配置 upstream 模块,Nginx会截获海量客户端请求,均匀公平地轮询分发给后端健康的MCP Server。只要有一台倒下,流量瞬间被切走,确保单点故障不会拖垮整个AI服务。
终极Boss:Kubernetes弹性集群部署
在Kubernetes的世界里,管理成百上千的容器靠的是「冷酷无情」的探针系统。
Liveness(存活探针) 像个脾气暴躁的保安,一旦发现进程假死,二话不说直接把它踢出去强制重启。
Readiness(就绪探针) 则温和一些。如果 /health 接口没响应,它不会杀掉Pod,但会「冷酷地让你去墙角蹲着」——绝不分配流量,直到彻底恢复。
这套双探针机制,正是K8s保障滚动更新「绝不中断」的底层逻辑。
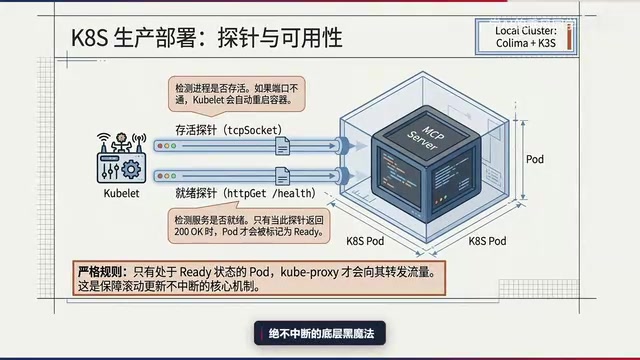
当所有Pod都在保安管理下进入Ready状态,流量贯通的高潮时刻就来了:外部请求先打到节点的Node Port上,紧接着K8s内置的kube-proxy瞬间接管,通过底层规则把流量无缝路由到正确的Target Pod。整个过程丝般顺滑,这正是生产级弹性集群的魅力所在。
kube-proxy是Kubernetes每个节点上运行的网络代理组件,负责维护节点上的网络规则(通常基于iptables或IPVS)。当外部请求通过NodePort抵达节点时,kube-proxy将其转发到对应Service后端健康的Pod上,并在多个Pod之间实现负载均衡。滚动更新(Rolling Update)是K8s的默认更新策略:它会逐步用新版本Pod替换旧版本Pod,而非一次性全部替换。在此过程中,Readiness探针至关重要——只有新Pod通过就绪检查后,旧Pod才会被销毁,从而确保在整个更新窗口内始终有健康实例在线处理请求,实现真正的零停机发布。
核心要点回顾
这趟从0到1的架构之旅可以浓缩为几个关键节点:
- MCP是统一AI连接的「USB-C标准」,一次实现、处处即插即用;
- 本地测试用极简的Stdio模式,但生产环境必须拥抱Streamable HTTP与无状态设计;
- 企业级架构的四大支柱——无状态、环境变量注入、健康探针、全链路追踪——缺一不可;
- Docker的HEALTHCHECK加Nginx负载均衡,解决了打包与流量分发;
- K8s的双探针机制与kube-proxy路由,最终构建出一个具备自愈能力、坚不可摧的弹性云端集群。
当你的AI大脑拥有了标准统一的接口和坚若磐石的服务器,下一步就是给它插上更炫酷的「装备」——无论是连接海量数据的数据库,还是能操控现实世界的自动化执行器。生产级MCP节点,值得你亲手构建。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。