MCPJam:面向 MCP 服务器的测试与评估平台
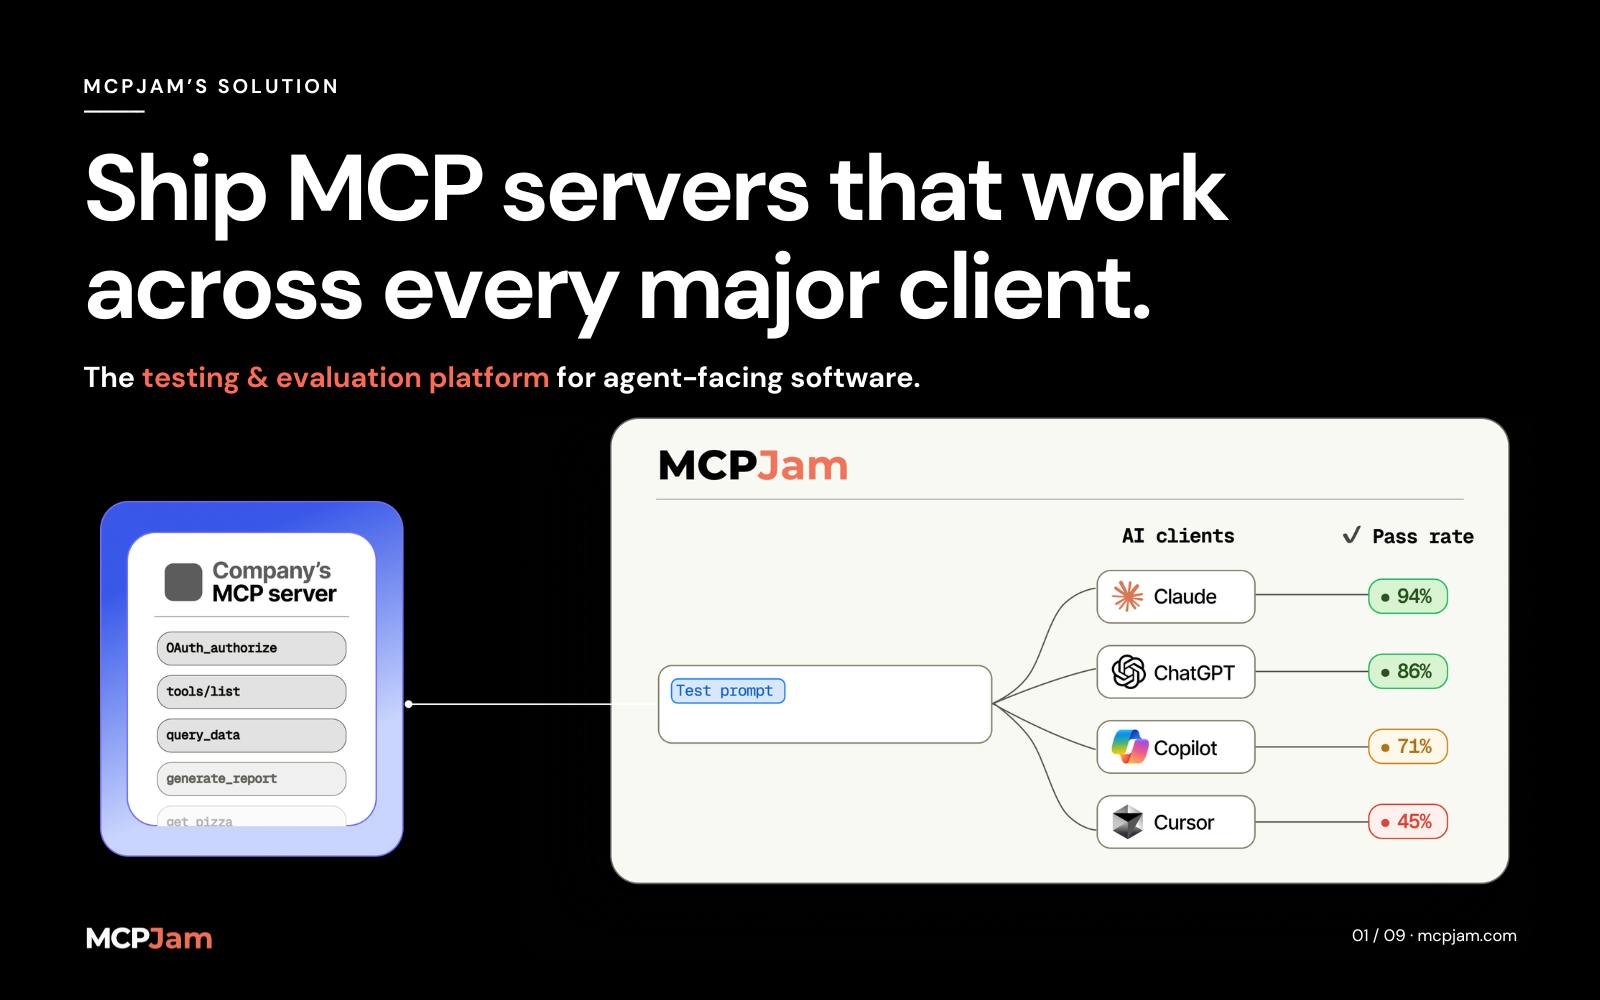
MCPJam 是专为 MCP 服务器设计的开源测试与评估平台,将 AI 工具调用的可靠性纳入工程化质量管控。
MCPJam 是一款面向 MCP(Model Context Protocol)服务器开发者的开源测试与评估平台,旨在解决 MCP 生态特有的质量验证难题——传统 API 测试只能验证接口的确定性行为,而 MCP 服务器的「消费者」是概率性的语言模型,需要评估模型在真实对话中能否正确调用工具、完成任务。产品提供 User Testing、Swarms 集群测试、Evals 量化评估和 CI/CD Gates 四类核心能力,支持桌面应用、CLI 和 SDK 三种接入方式,并可直接测试本地开发环境中的服务器。其核心价值在于将「模型真的能用好这个工具吗」这一主观判断转化为可量化、可自动化的工程指标,让 MCP 服务器的迭代具备与常规软件工程一致的质量保障机制。该产品在 Product Hunt 上线首日获 89 票、登榜第 7 名。
随着 Model Context Protocol(MCP)逐渐成为连接大模型与外部工具的标准接口,围绕它的工程化配套开始加速成型。MCPJam 正是其中一款瞄准痛点的工具——它把「测试」和「评估」这两件在传统软件开发里天经地义的事,带进了 MCP 服务器的开发流程。
这款产品在 Product Hunt 上获得 89 个投票、14 条评论,登上当日榜单第 7 名,并被归类于 Open Source、Developer Tools、Artificial Intelligence 等标签之下。
MCPJam 解决的是什么问题
MCP 服务器的作用,是把工具、数据源和能力暴露给 ChatGPT、Claude、Copilot 这类支持该协议的 AI 客户端。问题在于:开发者写完一个 MCP 服务器后,很难确认「模型真的能用好它」。
一个工具的接口定义清晰、返回结果正确,并不代表大模型在实际对话里会正确地调用它。模型可能误解参数含义、跳过必要步骤,或在多轮交互中丢失上下文。MCPJam 的官方描述直指这一点——它要验证的是「用户是否真的能在 ChatGPT、Claude 和 Copilot 里成功完成任务」,而不仅仅是接口层面的通不通。
这是 MCP 生态特有的测试难题:传统 API 测试关注请求与响应的确定性,而 MCP 服务器的「消费者」是概率性的语言模型,评估维度从「接口对不对」扩展到了「模型用得好不好」。
Model Context Protocol(MCP)是由 Anthropic 于 2024 年末提出的开放标准,旨在用统一的协议规范 AI 模型与外部工具、数据源之间的通信方式。类比 USB 接口的作用——在此之前,每家 AI 应用都需要为每个工具单独编写集成代码,MCP 则提供了一套标准化的「插槽」。MCP 服务器本质上是一个中间层进程,它把文件系统、数据库查询、API 调用等能力封装成标准工具(Tool),由支持 MCP 的客户端(如 Claude Desktop、Cursor 等)动态发现并调用。模型在对话中判断何时调用哪个工具、传入什么参数,完全依赖其自身的推理能力,这正是与传统确定性 API 调用的本质区别所在。
四种能力:从测试到 CI/CD 闭环
根据产品介绍,MCPJam 提供了四类核心能力,覆盖 MCP 服务器从开发到上线的完整链路。
User Testing 与 Swarms
User Testing 模拟真实用户在 AI 客户端中的使用场景,观察任务能否被顺利完成。Swarms(集群测试)则暗示了批量、并发的测试方式——可以理解为用大量模拟交互去覆盖更多边界情况,暴露单次测试难以发现的问题。
Evals(评估)
Evals 是 LLM 应用工程化中越来越关键的一环。对 MCP 服务器而言,评估意味着量化模型调用工具的成功率、准确性和稳定性,把「感觉能用」变成可衡量的指标。这类评估能力是判断一个 MCP 服务器是否达到生产标准的重要依据。
Evals(模型评估)这一概念源自 OpenAI 等机构在训练和对齐大模型时使用的系统性测试框架,后来逐渐演变为 LLM 应用开发中的工程实践。其核心思路是:用一批带有标准答案或评判标准的测试用例,批量运行模型并统计通过率、准确率等量化指标,而非依赖人工逐条抽查。在 MCP 场景下,Evals 需要解决的是「工具调用链」的评估难题——一次任务可能涉及多步工具调用,每步的参数选择和结果解读都可能出错,最终需要判断的是整条链路的成功率。与模型本身的 Evals 不同,MCP 服务器的评估还受到工具接口设计质量的影响,因此评估结果既能反映模型能力,也能反馈接口的可用性问题。
CI/CD Gates
把评估结果接入 CI/CD 流水线,是 MCPJam 相对成熟的一步。CI/CD gates 意味着团队可以设置质量门槛——当 MCP 服务器的测试或评估未达标时,阻止代码合并或部署。这让 MCP 服务器的迭代具备了和常规软件工程一致的质量保障机制。
CI/CD(持续集成/持续交付)是现代软件工程的基础实践:开发者每次提交代码时,自动化流水线会运行测试套件,只有通过全部检查(即「Gate」质量门)的代码才被允许合并或部署。将这一机制引入 MCP 服务器开发,意味着对工具调用准确率、响应稳定性等指标设置最低阈值——例如「核心任务完成率不得低于 95%」——一旦某次代码变更导致指标下滑,流水线会自动拦截并通知开发者。这对 MCP 服务器尤为重要,因为底层 API 变更或提示词调整都可能在不改变接口定义的情况下悄然降低模型的实际调用效果,而传统接口测试对此类退化毫无感知能力。
灵活的接入方式
MCPJam 支持三种接入形态,覆盖不同的使用习惯:
- 桌面应用(Desktop App):适合本地开发时的可视化测试,可直接测试本地运行的 MCP 服务器;
- CLI 命令行工具:便于集成到脚本和自动化流程中;
- SDK:让开发者以代码方式定义和运行测试,融入现有工程体系。
特别值得关注的是它明确支持测试本地服务器(local servers)。在开发阶段,能够在不部署到线上的情况下就完成验证,对缩短反馈循环有实际价值。
为什么这类工具正当其时
MCP 从提出到被主流 AI 客户端采纳的速度相当快,但生态的成熟度仍处在早期。协议本身解决了「怎么连」的问题,而「连得好不好、用得对不对」这类质量问题才刚刚浮现。MCPJam 选择切入测试与评估这个环节,本质上是在补齐 MCP 工程化的中间层。
作为一款开源工具,它的定位也更容易被开发者社区接受。对于正在构建 MCP 服务器的团队而言,一套标准化的测试评估流程,可能会像单元测试和 CI 之于传统软件那样,逐渐成为默认配置。
当然,作为一款新发布的产品,MCPJam 的实际评估效果、对不同模型的兼容程度,以及评估指标的科学性,都还需要在真实项目中检验。它所指向的方向——把 AI 应用的可靠性问题工程化——是清晰且有价值的。
相关推荐
WAN 2.1 物理动效 LoRA 横评:11 款实测排名与方法论
一位 Reddit 用户用光流分析对 WAN 2.1 上 11 款物理动效 LoRA 做了控制变量横评,仅 3 款真正有效,4 款效果低于对照组。本文解析测评方法、量化数据与冠军 LoRA 的物理正确性。
Lucid与Bolt达成合作,剑指欧洲Robotaxi市场
Lucid Motors宣布与欧洲移动出行平台Bolt达成合作意向,共同探索欧洲Robotaxi市场,但目前尚未落地车辆订单。本文解析这一合作的背景、模式与行业意义。
谷歌英伟达联手Emerald AI:破解数据中心电网困局
谷歌、英伟达、Anthropic 联合 Emerald AI 组建新联盟,计划为数据中心寻找 100 GW 电网容量,破解 AI 算力扩张下的电力瓶颈。本文解析联盟构成与技术路径。