MCP协议解析:让AI智能体拥有工具与记忆
MCP通过连接工具、添加记忆、定义目标三步循环,让AI智能体摆脱失忆与重复搬运。
文章围绕MCP(Model Context Protocol)展开,指出当前大模型被困在对话窗口内,无法直接访问邮件、日历、云盘等工具,且缺乏持久记忆,导致用户反复搬运数据和交代背景。MCP作为开放标准,被类比为“AI世界的USB-C”,让智能体以统一方式连接Gmail、Drive、Slack等外部工具并获取持久上下文。其核心流程为三步循环:连接工具实现可读可写、从文档注入记忆避免重复提问、定义目标后让智能体行动与优化。与传统插件和函数调用相比,MCP将鉴权和上下文传递抽象到协议层,大幅降低集成成本。文章同时强调MCP不承诺全自动,最终结果仍需人工确认,其价值在于提供能力底座。
你的AI每次对话都像失忆——因为它没有持久记忆。你每天在Gmail和Sheets之间复制粘贴,重复劳动,工具无法被AI直接调用。MCP(Model Context Protocol)正是为解决这两个痛点而生:它让任何AI智能体安全地使用你的工具,并记住上下文。
据YouTube创作者Aria Verma的演示,MCP的核心逻辑可拆解为"连接工具、添加记忆、定义目标"三步循环。她强调自己只测试能落地的AI工作流,让创始人交付系统而非炒作。本文基于该视频内容,结合协议本身的设计思路,解析MCP为何被视为智能体基础设施的关键拼图。
为什么你的AI需要MCP
当前大模型的能力边界很清晰:它能推理、能生成,但被隔离在对话窗口里。你的邮件、日历、云盘、项目管理工具,对模型而言都是不可见的孤岛。每次任务开始,你都要手动搬运数据——把线索列表贴进聊天框,再把模型输出复制回表格。
这种模式下,AI不是"智能体",只是一个高级输入法。更麻烦的是记忆缺失:模型不记得上周你定的筛选标准,不记得客户的偏好,每次都要重新交代背景。MCP要解决的就是这两件事——工具接入与上下文持久化。
MCP到底是什么:一个开放标准
MCP是一个开放协议,定义了AI应用如何与外部工具、数据源建立安全连接。你可以把它理解为"AI世界的USB-C":不管背后是Gmail、Drive还是Slack,只要按MCP规范暴露接口,智能体就能以统一方式读取数据、执行操作。
这与传统的插件或函数调用不同。插件往往绑定单一平台,函数调用需要开发者自己处理鉴权和上下文传递。MCP把这些抽象成标准层:连接一次,复用多处;权限由协议层管理,而非散落在每个集成里。对开发者而言,接入成本从"每个工具写一套适配"降到"实现一次协议"。
函数调用(Function Calling) 是大模型平台提供的一种能力:开发者用JSON Schema描述可用函数,模型在对话中判断何时调用、传入什么参数,平台再把调用结果回传给模型。它解决的是“模型如何触发外部动作”,但鉴权、连接管理、多工具编排仍需开发者自行实现,且各平台接口不统一。MCP则在此之上定义了标准化的服务器端暴露方式与客户端连接方式,把工具发现、调用、权限声明纳入协议,因此可以跨模型、跨应用复用同一套工具实现。
第一步:连接工具,让智能体可读可写
MCP的第一步是把工具接进来。视频中的描述很直白:将Gmail、Drive、Slack等工具通过MCP连接一次,智能体就能即时读取并采取行动。
这里的关键词是"行动"。不只是读取邮件内容,还包括起草回复、创建文档、更新表格状态。以一个典型场景为例:输入"筛选50条线索",MCP智能体会自动丰富信息、打分、起草跟进邮件,最终把更新后的表格留给你。整个过程在后台完成,你第二天看到的是结果,而不是一堆待办。
这种能力的价值在于消除"人肉中间层"。过去你需要在多个界面间切换、判断、搬运;现在智能体在协议层完成工具编排,人只负责定义目标和验收结果。
第二步:添加记忆,让AI不再重复提问
MCP的第二步是记忆。协议让智能体从文档中获取持久上下文,从而记住既有信息,而不是反复追问。
这一点常被低估。工具接入解决的是"能不能做",记忆解决的是"做得对不对、快不快"。没有记忆,智能体每次都要重新了解你的业务规则、客户画像、历史决策;有了记忆,它能在连续任务中保持一致性,减少重复沟通成本。
从工程角度看,MCP的记忆并非模型参数层面的记忆,而是上下文供给机制:把相关文档、历史记录、结构化数据按需注入,让模型在每次调用时拥有"工作记忆"。这比简单堆砌长上下文更可控,也更贴近实际工作流。
上下文窗口(Context Window) 指模型单次调用能处理的最大token数量,包括系统提示、对话历史、检索到的文档和工具返回结果。把所有资料直接塞进窗口的“长上下文”做法成本高、噪声大,且超出窗口后信息会被截断。MCP的记忆机制更接近检索增强生成(RAG) 的思路:由协议层按任务需要选择相关文档和记录注入上下文,而不是无差别堆叠。这样既控制了token开销,也避免了无关信息干扰模型判断。
第三步:定义目标,让智能体自主循环
工具和记忆就位后,最后一步是定义目标。视频中给出的循环是:连接工具、添加记忆、定义目标,然后让智能体行动、观察、优化。
这个循环本质上是智能体的基本运行范式。你给出目标(例如"把本周线索按优先级排序并起草跟进"),智能体调用工具获取数据、依据记忆中的规则处理、产出结果,再根据反馈调整。人从执行者变成目标设定者和结果审核者。
说个细节,MCP并不承诺全自动。视频演示的场景中,最终表格仍需人工确认。协议提供的是能力底座,工作流的可靠性取决于目标定义是否清晰、权限边界是否合理。
文中描述“行动、观察、优化”的循环,对应智能体领域的ReAct范式(Reasoning + Acting):模型先推理下一步该做什么,再调用工具执行动作,然后观察返回结果并修正计划,如此迭代直到目标达成。MCP在这个循环中扮演工具与上下文供给层的角色,而循环控制本身由智能体应用负责。这也解释了为什么目标定义和权限边界如此重要——循环越自主,错误动作的放大效应越明显。
谁该关注MCP
对开发者,MCP意味着集成工作从N个平台适配收敛到一套协议实现,可以更快构建可复用的智能体能力。对创业者和业务负责人,它意味着AI从"聊天玩具"变成能接入现有系统的生产力工具——不需要重构整个技术栈,而是通过标准接口逐步接入。
Aria Verma在视频结尾强调,她测试的是能落地的实用工作流,目标是让创始人交付系统而非追逐概念。这个定位恰好说明MCP当前的价值阶段:它不是终局,而是让智能体真正进入日常工作的基础设施层。如果你的AI每天还在"失忆",问题可能不在模型,而在缺少这样一层协议。
相关推荐
亚马逊CEO:2200亿美元押注AI基础设施, AWS三年AI营收超250亿
亚马逊CEO Andy Jassy详解2200亿美元AI基础设施投资逻辑:产能售罄至2028年、自研Trainium芯片降本、6人76天重写推理引擎的组织变革,以及数据中心争议与AI安全风险的真实判断。
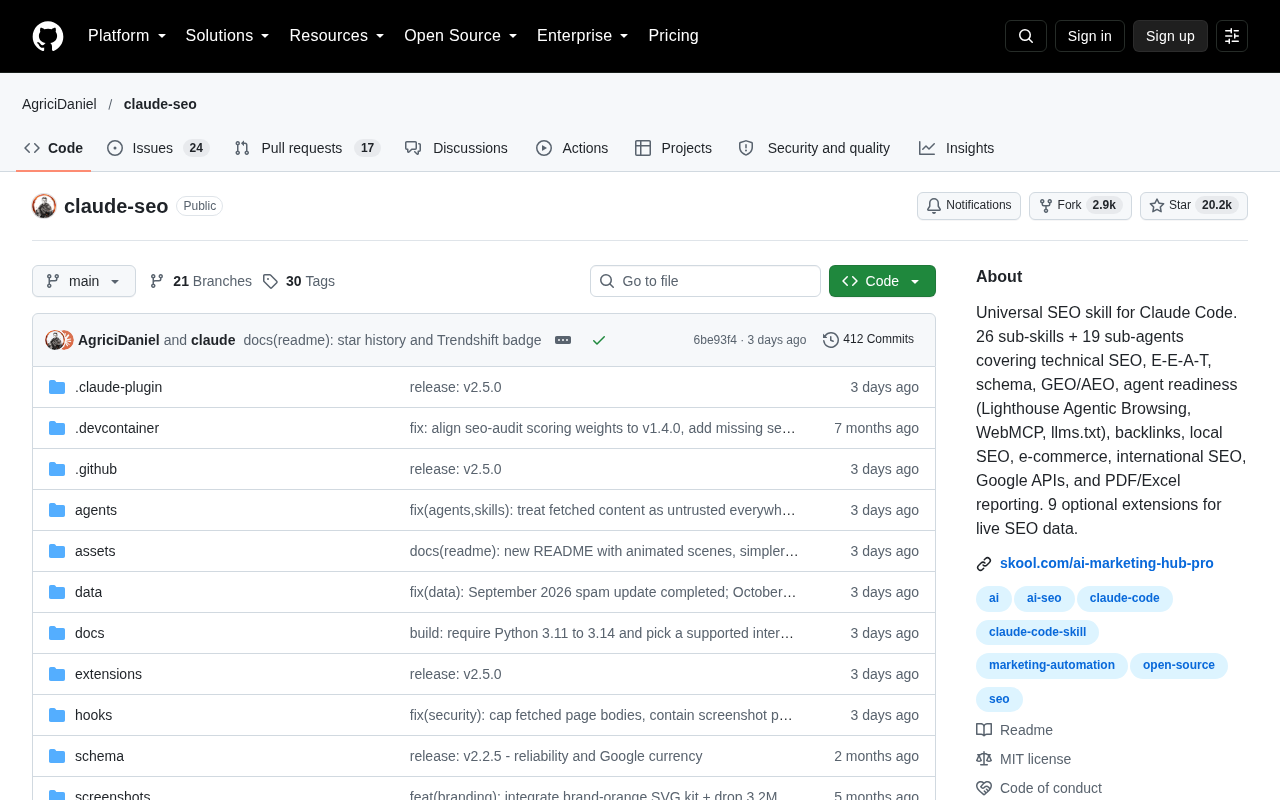
Claude Code 最强 SEO 技能包:26 子技能 + 19 子智能体
GitHub 开源项目 claude-seo 为 Claude Code 提供 26 个 SEO 子技能与 19 个子智能体,覆盖技术 SEO、E-E-A-T、Schema、GEO/AEO、Agent Readiness、外链与本地 SEO,并支持 PDF/Excel 报告与 Google API 集成。
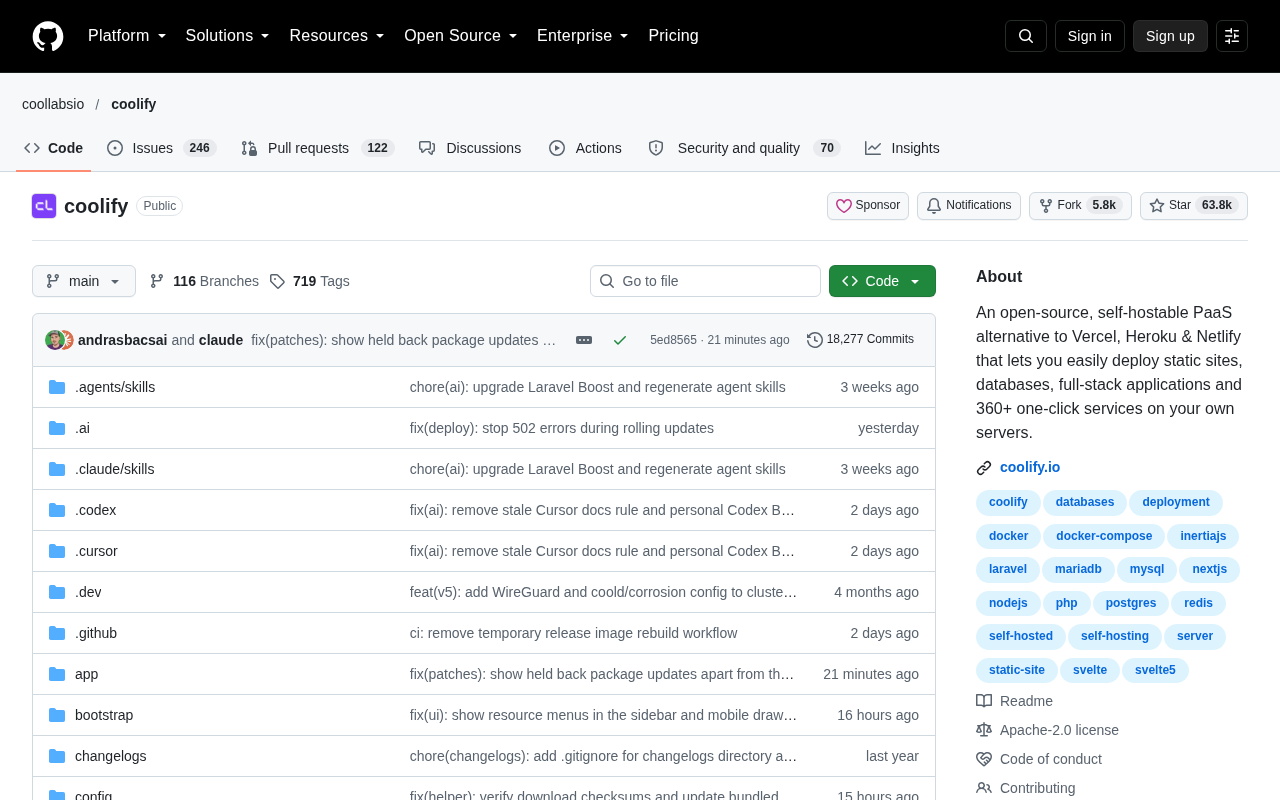
Coolify:自托管PaaS新选择,替代Vercel与Heroku
Coolify 是一个开源可自托管的 PaaS 平台,支持静态站点、数据库、全栈应用及 360+ 一键服务,是 Vercel、Heroku 和 Netlify 的替代方案,GitHub 星标超 63k。