MCP协议漏洞曝光:谷歌、摩根大通等五家机构已修复
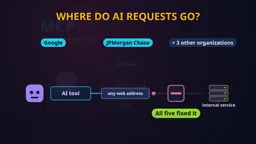
五家顶级机构的MCP服务器存在同一漏洞:抓取URL却不验证去向,可被协议跳转攻击利用。
独立安全研究员Syed Anas Mohi Uddin在谷歌、摩根大通、Weaviate、法国政府数字机构及印尼坦格朗市政府的MCP服务器中发现了同一个高危漏洞:工具可抓取任意网址却不验证该地址的真实去向。攻击者通过"协议跳转"手法,将恶意指令植入工具输出,借助智能体间的默认信任链逐级传递,最终使请求伪装成内部可信来源,绕过外部边界防护。这本质上是一种间接提示注入攻击。五家机构均已确认并修复漏洞,修复核心是对所有具备抓取能力的工具统一部署允许列表,并验证每个请求的真实目标地址。这次事件揭示了MCP生态在安全实践上的系统性盲区,也印证了在多智能体架构中"零信任"原则的必要性。
一个在五家机构同时出现的安全漏洞
你知道AI智能体发出的请求究竟流向了哪里吗?独立安全研究员Syed Anas Mohi Uddin在调查中发现了一个令人警惕的现象:谷歌、摩根大通(JPMorgan Chase)以及另外三家组织的MCP(Model Context Protocol)服务器,都存在同一个安全缺陷——一个会抓取给定网址、却不验证该地址真实指向的工具。
据Ars Technica报道,这五家机构已全部确认并修复了该漏洞。涉及的组织横跨不同领域与国家:除谷歌和摩根大通外,还包括数据库公司Weaviate、法国政府数字机构,以及印度尼西亚的坦格朗(Tangerang)市政府。其中谷歌的漏洞被评定为8分(满分10分),属于高危级别。
值得关注的是,这些服务器出自完全不同的团队之手,却犯了相同的错误。这说明问题并非某个团队的疏忽,而是MCP生态在设计实践中普遍存在的盲区。
MCP(Model Context Protocol,模型上下文协议) 是由Anthropic于2024年底推出的开放协议,旨在为AI模型提供一套标准化的方式来连接外部工具、数据库和服务。开发者可以将能力(如网页抓取、代码执行、数据库查询)封装成"MCP服务器",AI智能体则作为"MCP客户端"按需调用这些服务器。该协议的出现大幅降低了AI工具集成的门槛,迅速被谷歌、各类开源项目及企业内部团队采用。然而,协议本身并未强制要求工具实现对输入参数的安全校验,这使得"实现了功能、却未考虑安全边界"的服务器大量涌现,也是本次多家机构同时出现相同漏洞的结构性原因。
漏洞如何被利用:协议跳转(Protocol Pivoting)
Mohi Uddin描述了一种他称之为“协议跳转”(protocol pivoting)的攻击路径,揭示了攻击者如何触达这类有缺陷的工具。
攻击的起点是“被植入的文本”。攻击者在某个工具的输出中埋入恶意文本,这段文本首先抵达第一个AI智能体。随后,第一个智能体通过另一种智能体协议,把它当作一项正常任务传递给第二个智能体。
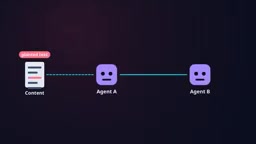
关键问题出在信任链上:第二个智能体因为信任发送方,便执行了这项任务。如果第二个智能体恰好持有那个有缺陷的、不验证网址去向的工具,那么这个请求此刻就变成了“来自网络内部”的请求——它绕过了外部边界的防护。
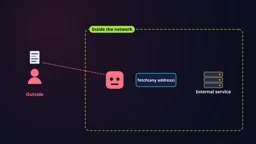
另一位研究员向Ars Technica指出,这本质上是一种“间接提示注入”(indirect prompt injection)。安全公司Rapid7上月也修复了一个相关的低危漏洞,印证了这类问题的普遍性。
间接提示注入(Indirect Prompt Injection) 是这类攻击的底层机制。与"直接提示注入"(攻击者直接向模型输入恶意指令)不同,间接提示注入是将恶意指令藏匿于模型会主动读取的外部内容中——例如网页、文档、工具返回值——由模型自身在执行任务时"读入"并执行。在多智能体场景中,这一威胁被进一步放大:一个智能体的工具输出,天然成为下一个智能体的"外部内容",而后者往往因信任上游来源而跳过安全校验。这种攻击路径早在大型语言模型开始被赋予工具调用能力时就已被研究者预警,但在MCP等协议将多智能体协作标准化之后,其可利用性显著提升。
为什么智能体之间的信任是风险源头
这起事件的核心教训在于:当多个AI智能体通过协议相互协作时,彼此之间的默认信任会成为攻击的放大器。单个智能体看似安全,但当恶意指令通过“正常任务”的形式在智能体之间流转时,边界防护就形同虚设。
Rapid7的Douglas McKee给出的建议直截了当:把AI传递给你工具的任何内容,都当作“来自互联网上陌生人的输入”来对待。这意味着无论数据来自哪个内部智能体、经过了多少层传递,都不应被默认信任。
这种“零信任”思路对于当前快速扩张的智能体生态尤为重要。随着MCP等协议让AI工具链条越来越长,每一个环节的输入校验都不能省略。
修复方案:验证每一个请求的真实去向
Mohi Uddin提出的修复方法同样朴素而有效:检查每个请求真正流向了哪里,并对所有会抓取网址的工具使用同一套方法来加固。
具体来说,就是在每一个具备抓取能力的工具上部署统一的允许列表(allow list),只放行明确可信的目标地址,拒绝一切未经验证的跳转。这一做法的优点在于可复制性强——同一套防护逻辑可以覆盖所有存在类似风险的工具,避免逐个修补时出现遗漏。
对于正在构建或使用MCP服务器的开发团队,这起事件提供了清晰的检查清单:
- 审查所有会根据输入抓取外部地址的工具
- 为这些工具统一配置目标地址的允许列表
- 不信任任何由AI智能体传递而来的输入,一律视作外部不可信数据
允许列表(Allow List) 是一种经典的访问控制机制,与"拒绝列表(Block List)"相对:后者列出禁止的目标并放行其余,前者则仅放行显式声明为可信的目标,默认拒绝其他一切。在网络请求场景中,允许列表通常以域名、IP段或URL前缀的形式配置。相比逐一封堵已知恶意地址,允许列表的安全性更强,因为攻击者无法通过注册新域名或使用重定向来绕过防护。在MCP工具的抓取场景中,结合"跟随重定向后验证最终目标地址"的逻辑,才能真正防止协议跳转——仅校验初始URL而不跟踪跳转链,同样会被绕过。
对AI智能体安全的启示
当谷歌、摩根大通这样的顶级技术与金融机构都在同一个问题上栽了跟头,说明智能体安全仍处于早期阶段,许多最佳实践尚未被广泛采纳。MCP协议带来了强大的工具调用能力,但也引入了新的攻击面。
随着越来越多企业把AI智能体接入生产环境、让它们自主调用工具和访问外部资源,输入验证、来源校验和最小权限原则这些传统安全理念,必须被重新引入到智能体架构中。这次由独立研究员发现、多家机构快速响应修复的案例,是一次有价值的集体警醒。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。