每个Token都需要专属老师:多教师自适应自蒸馏新方法

论文提出MTA-OPSD,让每个Token自适应选择多教师池中的教师,数学推理增益最高+5.9。
文章介绍论文《Every Token Needs Its Own Teacher》,指出On-policy Self-distillation(OPSD)现有方法隐含假设教师固定,但同一回答内不同Token对参考信息的依赖并不相同。作者通过教师干预试点研究,利用多数投票和KL散度选择验证了可为每个Token识别更优教师,进而提出MTA-OPSD:构建多教师池,让每个Token在训练中自适应选择偏好教师,将教师监督粒度从训练全程、单个回答下沉到单个Token。实验在Qwen3数学推理任务上进行,MTA-OPSD一致优于现有OPSD方法,相对基座模型平均增益最高达+5.9,代码已开源。文章还讨论了该方法的实践启示与待解问题。
从「一个老师教到底」到「每个Token自选老师」
在大型语言模型的后训练(post-training)中,On-policy Self-distillation(OPSD)已被证明是一种有效手段——它通过构造一个以特权参考(privileged references)为条件的教师模型,来指导学生模型在自身生成的轨迹上学习。然而,现有OPSD方法在教师配置上存在一个共同的隐含假设:教师是固定的。
据论文《Every Token Needs Its Own Teacher: Multi-teacher Adaptive On-policy Self-distillation》指出,这种固定教师的做法存在根本局限。作者提出一个直白的观点:每个Token都需要自己的老师,因为即便在同一个回答内部,教师偏好也可能逐Token变化。
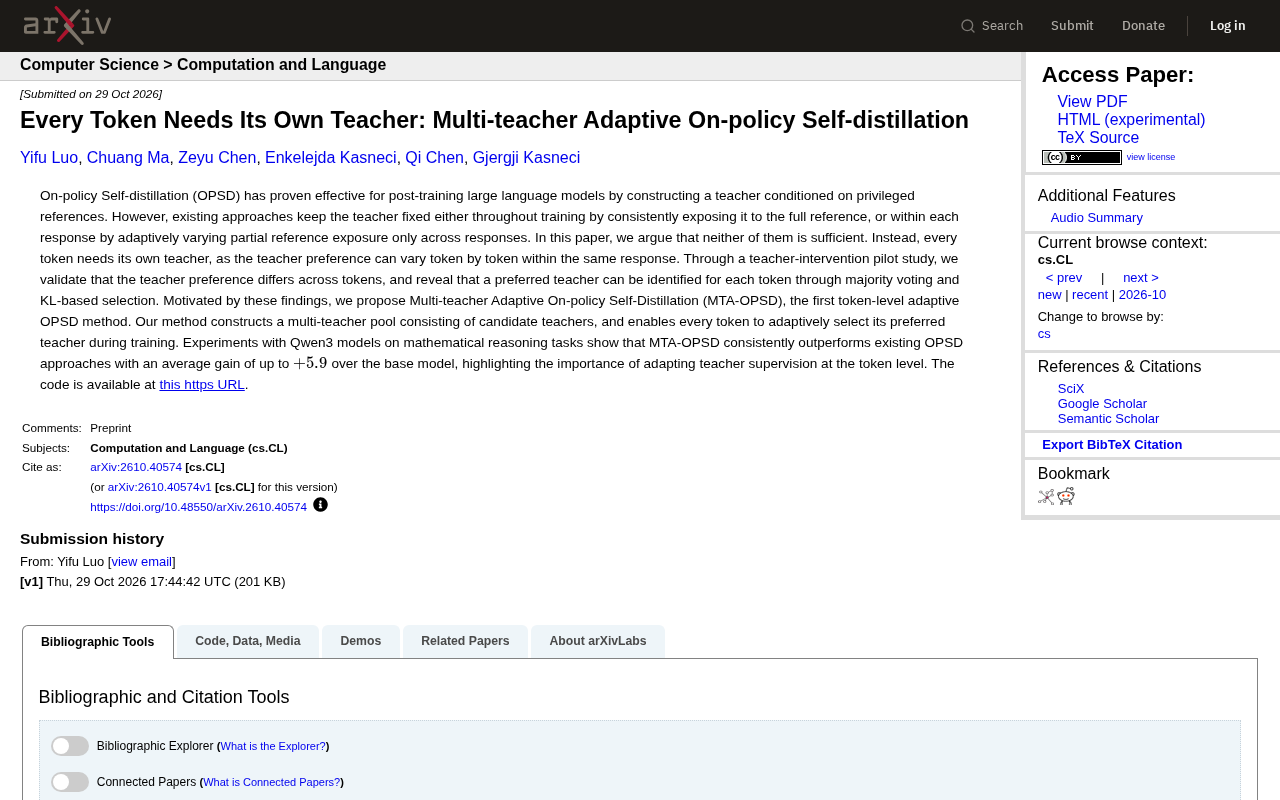
现有OPSD的两条路径及其不足
论文将现有做法归纳为两类。第一类是在整个训练过程中保持教师固定,始终让教师接触完整参考。第二类是在每个回答内部,仅跨回答自适应地变化部分参考的暴露程度,但在单个回答内教师仍然不变。
作者认为这两者都不够。原因在于,同一个回答中的不同位置,对参考信息的依赖程度并不相同:有些Token可能更需要完整参考的引导,有些则可能从部分参考甚至不同参考组合中获益更多。用一个统一教师覆盖所有Token,等于抹平了这种细粒度的监督差异。
特权参考(privileged references) 是OPSD中的一个关键概念:它指仅在训练阶段可用、推理阶段不可见的信息,例如问题的人工标注解题过程、标准答案或检索到的外部文档。教师模型以这些参考为条件,能够给出比学生模型自身更高质量的分布,而学生模型只能看到输入问题本身。这种信息不对称正是蒸馏信号的来源——教师“看到更多”,学生通过模仿来内化这些额外信息。理解这一点有助于把握为何“教师接触多少参考”会成为可调的设计维度:在单个回答内部,不同Token对参考的依赖程度不同,因此参考暴露的粒度直接决定了监督信号的精确性。
教师干预试点:验证Token级偏好差异
为了验证这一直觉,作者设计了一个教师干预试点研究(teacher-intervention pilot study)。结果显示,教师偏好确实在不同Token之间存在差异。
更关键的是,研究进一步揭示:通过多数投票(majority voting)和基于KL散度的选择(KL-based selection),可以为每个Token识别出一个「更优」的教师。这为Token级自适应教师选择提供了可操作的技术路径,而不只是停留在观察层面。
KL散度(Kullback-Leibler divergence) 是衡量两个概率分布差异的非对称指标。在本文语境中,它被用来比较不同教师模型在某个Token位置上给出的预测分布与学生分布(或参考分布)之间的偏离程度。KL值越小,说明该教师在当前位置的预测与目标越接近,因而可被视为该Token的“更优教师”。基于KL的选择本质上是一种逐位置的分布匹配度评分,与多数投票相比,它对概率质量的分布形状更敏感,而多数投票只关注最高概率的类别是否一致。两种方法从不同角度为Token级教师选择提供了可操作的判据。
MTA-OPSD:首个Token级自适应OPSD方法
基于上述发现,论文提出Multi-teacher Adaptive On-policy Self-Distillation(MTA-OPSD),自称是首个Token级自适应的OPSD方法。
其核心设计是构建一个由候选教师组成的多教师池(multi-teacher pool),并让每个Token在训练过程中自适应地选择自己偏好的教师。这样一来,教师监督的粒度从「训练全程」和「单个回答」下沉到了「单个Token」,与试点研究的结论形成呼应。
从方法论角度看,这一思路把自蒸馏中的教师选择问题转化为一个Token级的动态路由问题:教师不再是静态超参数,而是随训练状态和Token上下文变化的变量。
On-policy 蒸馏指训练轨迹由学生模型自身生成,而非使用固定的离线数据集。这使得训练分布与推理分布保持一致,缓解了曝光偏差(exposure bias)问题——即模型在训练时只见过正确前缀、推理时却要面对自身错误累积的困境。在OPSD中,教师对学生的每条生成轨迹逐Token给出监督信号,学生据此更新。由于轨迹是on-policy生成的,教师需要在训练过程中持续介入,这带来了额外的计算开销,也解释了为何多教师池的构建成本是一个值得关注的实践问题。
实验结果:数学推理任务上的稳定增益
作者在Qwen3模型上针对数学推理任务进行了实验。结果显示,MTA-OPSD一致优于现有的OPSD方法,相对基座模型的平均增益最高达到+5.9。
这一结果的意义不止于数字本身。它表明,教师监督在Token级别上的自适应调整,能够带来可测量的性能提升,从而支撑了论文的核心论点:Token级教师自适应是值得的。代码已在GitHub仓库xingzhejun/MTA-OPSD开源。
实践启示与待解问题
对从事LLM后训练的工程团队而言,MTA-OPSD提示了一个可复用的设计原则:当参考信息质量参差或不同片段重要性不一时,与其设计一个「平均最优」的固定教师,不如让监督信号在更细的粒度上动态选择。多教师池加Token级选择的组合,也为其他形式的蒸馏与对齐训练提供了参考范式。
当然,论文目前聚焦于数学推理任务与Qwen3模型,多教师池的构建成本、Token级选择在更长上下文和开放域任务上的表现,仍需更多验证。但「每个Token都需要自己的老师」这一提法,已经把OPSD的粒度问题摆上了台面。
相关推荐

Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。
Mistral Large 4开放权重,AI早报盘点模型与生态新动向
Mistral Large 4开放权重,1万亿参数MoE架构支持MacStudio本地运行;Meta测试生成技术进入生产环境;税务基准测试头名通过率仅10.8%;加拿大政府入股Cohere;豆包工作开放第三方模型调用。本期AI早报盘点模型、生态、资本与政策动向。
Mistral Large 4开源:1T参数欧洲版千问挑战DeepSeek
Mistral Large 4正式开源,1T总参数、52B激活参数,主打编程与网络安全,NVFP4量化版本权重约610G。本文解析其与DeepSeek V4 Flash的对比、API定价、Demo真实性与本地部署价值。