枚举引导训练:打造可靠的神经Hamilton-Jacobi安全证书

枚举引导训练框架通过概率枚举安全约束生成紧凑反例,微调神经证书以提升安全认证并实现零违规部署。
本文针对神经安全证书训练中不安全区域难以精确刻画、对抗攻击反例不够精准的问题,介绍了一种验证引导的训练框架。该框架采用概率枚举策略检测前向不变性违反,生成紧凑且有针对性的反例集合,用于微调预训练的 Hamilton-Jacobi 值函数,从而扩大认证区域并减少认证时间。基于精炼后的证书,作者设计了部署时的安全屏蔽机制,实时监控状态并在预测到违规时切换至安全策略。在 Isaac Sim 仿真和真实自动驾驶赛车实验中,该方法均实现了零安全违规,优于名义控制器和 LQR 备份策略。该工作将形式化验证与深度学习结合,为安全关键系统提供了可证明的安全保证。
为什么神经安全证书难以训练?
Hamilton-Jacobi (HJ) 可达性分析能为控制系统提供形式化的安全保证,但训练出准确的神经证书却充满挑战。核心难点在于:不安全区域往往难以精确刻画,导致学习到的证书在边界附近容易误判。传统的对抗攻击方法虽然能生成反例,但这些反例往往不够精准,无法有效捕捉失败边界。
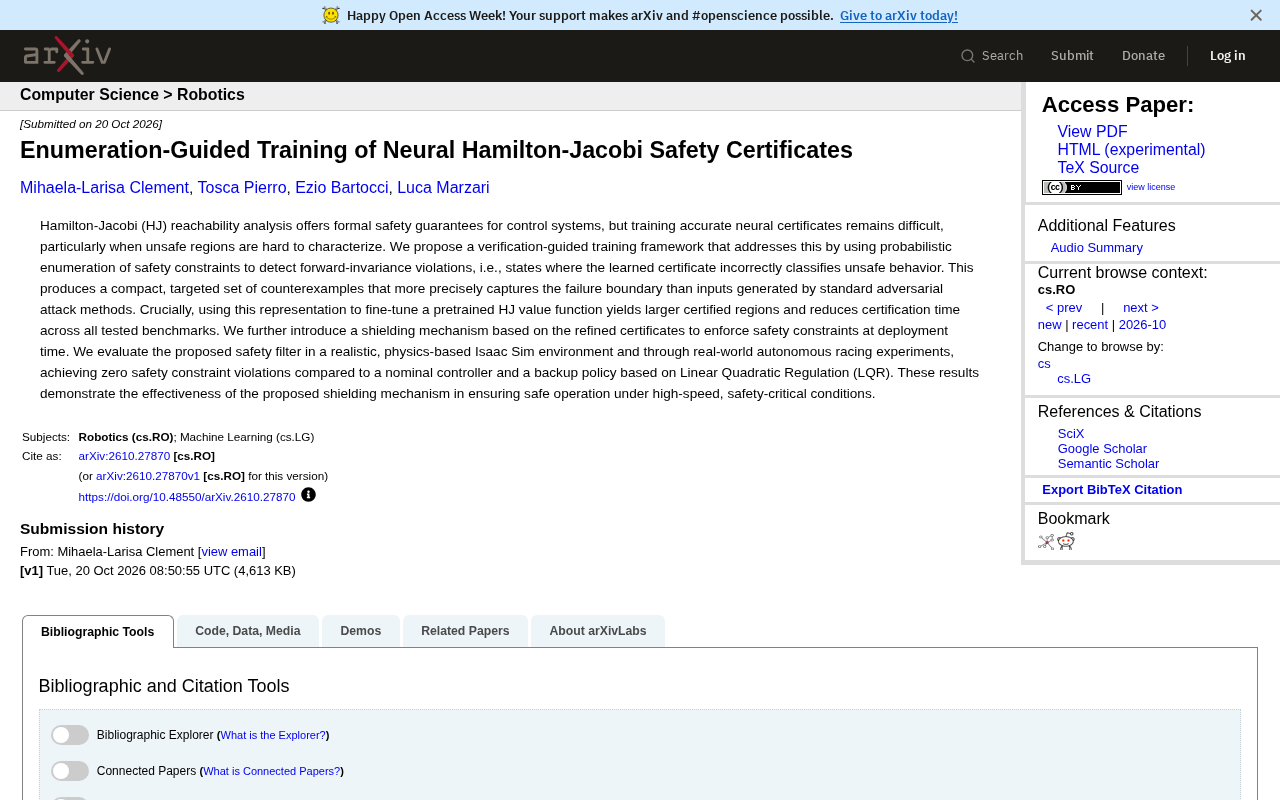
近期一篇论文提出了一种验证引导的训练框架,通过概率枚举安全约束来检测前向不变性违反,从而生成紧凑且有针对性的反例集合。该方法不仅能提升证书的认证区域,还能减少认证时间,并在真实场景中实现了零安全违规。
Hamilton-Jacobi (HJ) 可达性分析是一种基于动态系统最优控制理论的形式化验证方法。其核心思想是求解一个偏微分方程——HJ 方程,该方程的值函数刻画了从给定初始状态出发、在有限时间内能够到达的状态集合(即可达集)。若可达集与不安全状态集合不相交,则系统在该初始状态下是安全的。然而,HJ 方程在一般非线性系统中没有解析解,数值求解面临维数灾难,因此近年来的研究转向用神经网络来近似 HJ 值函数,即所谓“神经证书”。神经证书的训练目标就是让网络输出逼近真实的 HJ 值函数,从而在连续状态空间中提供可证明的安全保证。理解这一点有助于把握文中“证书”“认证区域”等术语的准确含义。
前向不变性是安全控制中的一个基本概念:若系统从某个集合内的任意状态出发,其后续轨迹始终不离开该集合,则该集合称为前向不变集。对于安全证书而言,我们期望证书所定义的安全区域是前向不变的,即一旦进入就永远不会违反安全约束。前向不变性违反(forward invariance violation)就是指存在某个状态,证书判定其安全,但系统从该状态出发的轨迹却进入了不安全区域。文中“概率枚举安全约束来检测前向不变性违反”正是通过采样和枚举来找出这类反例状态,从而暴露证书在边界附近的缺陷。
枚举引导的训练框架如何工作?
该框架的核心是“概率枚举”策略。它不再依赖标准的对抗攻击生成反例,而是通过枚举安全约束来识别那些被证书错误分类的状态——即前向不变性违反。这些状态构成了一个紧凑的反例集合,更精确地描绘了失败边界。
利用这个反例集合对预训练的HJ值函数进行微调,可以显著扩大认证区域,同时减少认证所需的时间。在多个基准测试中,该方法均表现出一致的改进。这种“检测-微调”的闭环,让证书在关键区域更加可靠。
与传统对抗攻击的对比
标准对抗攻击通常生成分散的反例,难以覆盖失败边界的全貌。而枚举引导的方法产生的反例更集中、更具代表性,因此微调后的证书在边界附近的误判率明显降低。论文指出,这种表示方式比标准对抗攻击生成的输入更能精确捕捉失败边界。
对抗攻击在机器学习中通常指对输入施加微小扰动以诱导模型产生错误输出。在神经证书的语境下,对抗攻击被用来寻找证书误判的状态:通过梯度优化在状态空间中搜索使证书值接近安全阈值但实际不安全的点,作为反例来微调证书。然而,标准对抗攻击往往只针对单个样本进行扰动,生成的反例彼此独立且分散,难以系统性地覆盖失败边界。枚举引导的方法则不同,它通过枚举安全约束的组合或对状态空间进行系统采样,能够更全面地刻画证书失效的区域,因此生成的反例集合更紧凑、更具代表性。
部署时的安全屏蔽机制
基于精炼后的证书,作者引入了一种屏蔽机制,在部署时强制执行安全约束。该机制实时监控系统状态,一旦预测到潜在违规,便切换至安全策略。
在Isaac Sim物理仿真环境中,该安全滤波器在高速、安全关键条件下进行了评估。与名义控制器和基于线性二次调节器(LQR)的备份策略相比,该方法实现了零安全约束违反。
真实世界自动驾驶赛车的验证
除了仿真,研究团队还在真实世界的自动驾驶赛车实验中验证了该机制。在高速竞速场景下,安全滤波器成功避免了所有安全违规,而基线方法则出现了违规。这证明了该方法在现实动态环境中的有效性。
**安全屏蔽(safety shielding)**是一种运行时保障技术:在系统部署阶段,一个监控模块持续观察系统状态,当检测到即将发生不安全行为时,屏蔽机制会覆盖名义控制器的输出,切换到一个经过验证的安全后备策略。本文中,屏蔽机制依赖精炼后的神经证书来实时判断当前状态是否安全,若预测到潜在违规便触发切换。与离线验证不同,屏蔽机制提供了在线兜底,即使证书在训练分布外存在少量误差,也能在部署时避免实际违规。Isaac Sim 是 NVIDIA 开发的机器人仿真平台,提供高保真的物理模拟,常用于安全关键算法的闭环测试。
对安全关键系统的意义
这项工作的贡献在于将形式化验证与深度学习相结合,通过枚举引导的训练提升神经证书的可靠性。对于自动驾驶、机器人等安全关键领域,这种能够提供可证明安全保证的方法具有重要价值。
未来,该框架有望扩展到更复杂的系统,并进一步降低认证的计算成本。随着神经证书在工业界的应用增多,此类验证引导的训练方法或将成为标准实践。
相关推荐

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。

REA:无需编码,用AI逆向任意应用
REA是一款爆火GitHub的开源AI逆向工程工具,可让Claude、Codex等AI代理直接分析任意应用并生成功能克隆,无需编码。本文介绍其工作原理、安装方法、实测案例及法律风险。