美联储报告:87%受访者视AI为头号金融风险
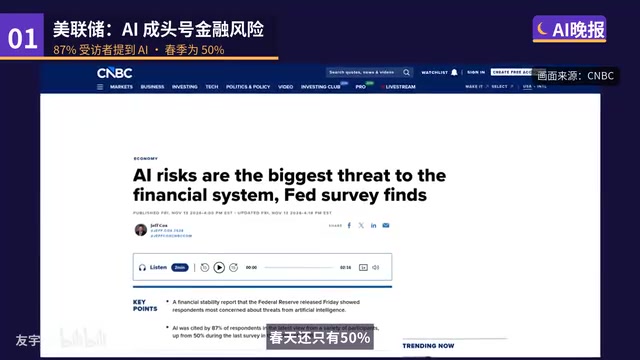
美联储报告显示87%受访者视AI为头号金融风险,与技术加速形成并行张力。
美联储金融稳定报告显示,87%的受访者将AI列为头号金融风险,较几个月前的约50%大幅跃升,算力相关债务发行已达6800亿美元,是2023年全年的5倍。与此同时,英伟达市值跌破4万亿美元,连跌6周创2012年以来最长纪录。技术侧则有多条动态:OpenAI解散独立机器人团队,将人员并入研究与产品部门;Cursor披露合作方Fireworks密钥泄露导致假冒插件事件;谷歌将Gemini以只读方式接入钱包;Thinking Machines公开4比特预训练方法,68小时完成训练;本地推理工具Lauma发布1.0正式版。文章认为,技术加速与金融焦虑互为因果,英伟达首份财报是短期关键验证点。
美联储最新金融稳定报告给出一个颇具反差感的信号:在受访者眼中,AI已经超越通胀、地缘政治等传统议题,成为排名第一的金融风险。话说回来,英伟达股价持续回调、OpenAI调整机器人团队、Cursor披露安全事件、谷歌把Gemini接入钱包——技术进步与金融焦虑在同一条时间线上并行推进。据B站AI晚报梳理,本期共7条值得关注的动态,以下逐条展开分析。
一、87%受访者把AI列为头号风险,算力债务成焦点
据美联储金融稳定报告,87%的受访者把AI列为金融风险,排名第一。这一比例在几个月前的同类调查中还只有50%左右,短期内的跃升幅度相当显著。换句话说,市场对AI的担忧已经从“技术是否可靠”转向“资金链条是否稳固”。
报告同时指出,与算力相关的债务发行规模已达6800亿美元,是2023年全年的5倍。这一数据是理解风险情绪的关键:AI基础设施的扩张越来越依赖债务融资,一旦回报周期不及预期,杠杆压力会沿着算力供应链传导。87%这个数字与其说是对AI技术本身的不信任,不如说是对“AI资本开支—债务—估值”这一循环的警惕。
算力债务指的是AI基础设施(尤其是数据中心、GPU集群和高速网络)建设过程中,企业通过发行债券、贷款等债务工具筹集的资金。与传统科技公司主要依靠经营现金流扩张不同,这一轮AI军备竞赛的资本开支规模极大,单座大型AI数据中心的投资动辄数十亿美元,许多企业选择加杠杆推进。债务融资意味着固定的利息与本金偿付义务,一旦AI业务收入增长慢于预期,偿债压力就会显现,并可能通过供应链(芯片采购、云服务合约)向上下游传导。因此,算力债务规模及其增速常被视为衡量AI泡沫风险的核心指标之一。
二、英伟达市值跌破4万亿,连跌纪录创十余年之最
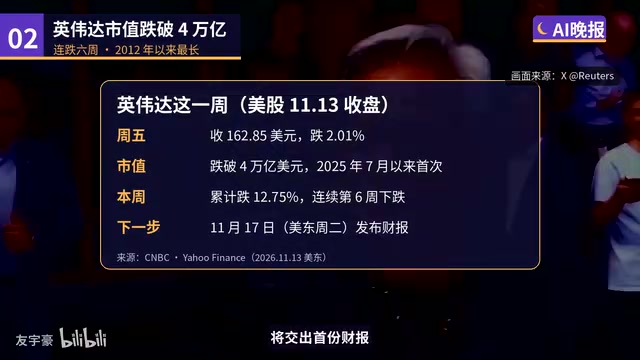
英伟达周五股价再跌2%,市值跌破4万亿美元。本周累计跌幅接近13%,已连续下跌6周,创下2012年以来最长连跌记录。下周二,临时CEO克雷斯将交出首份财报,市场关注度可想而知。
把这条与上一条对照看,逻辑就清晰了:算力债务扩张与英伟达估值高度绑定,金融稳定报告的风险提示与股价的连续回调,指向同一个问题——AI基础设施的定价正在接受重新审视。首份财报将是短期内的关键验证点。
三、OpenAI解散独立机器人团队,人员并入研究与产品
据《财富》独家报道,OpenAI解散了独立的机器人团队,相关人员并入研究和应用部门。OpenAI对此的回应是“为了加速,不是放弃”。
这个表态值得细读。GPT-6 Astra这类通用模型已经能直接用在机器人上,意味着机器人能力可以依托通用模型迭代,而不必维持一支独立团队。从组织设计上看,这是把机器人从“专项项目”降级为“通用模型的下游应用”,短期看是收缩,长期看是把资源集中到模型本体。据B站AI晚报与多家科技媒体的交叉信息,这一调整并非孤立事件,而是通用模型团队吸纳垂直方向的一部分。
通用模型(如文中提到的GPT-6 Astra)直接用于机器人,指的是将大规模预训练模型作为机器人的“大脑”,由其完成感知理解、任务规划和自然语言指令解析,而不再为机器人单独训练专用模型。这种做法的优势在于:通用模型在多模态理解和推理上的能力可以直接迁移,机器人团队无需重复建设底层模型能力,只需聚焦本体控制、运动规划等硬件相关部分。这也解释了为何OpenAI可以将机器人团队并入研究与产品部门——机器人能力逐渐成为通用模型的一个应用出口,而非需要独立组织保障的专项方向。
四、Cursor安全事件:Fireworks泄露密钥与假冒插件
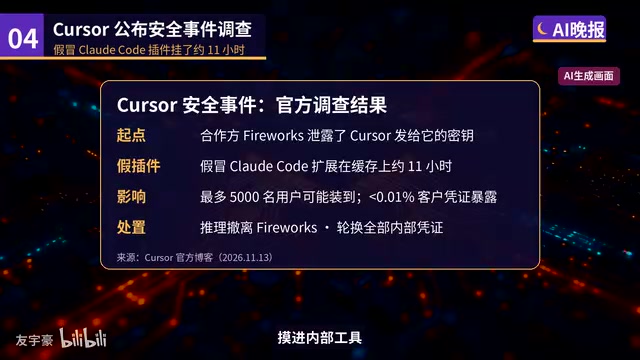
Cursor公布了安全事件调查结果。攻击者利用合作方Fireworks泄露的密钥进入内部工具,还放置了假冒的CloudCode插件,该插件挂载约11小时,最多可能有5000名用户安装。
这起事件的教训不在Cursor本身,而在供应链:第三方合作方的密钥管理一旦出现疏漏,风险会穿透到终端用户。对开发者而言,插件生态的信任边界需要重新评估——安装来源、权限范围、挂载时长都应当成为默认审查项。11小时的暴露窗口和5000名潜在受影响用户,是一个不算大但足够有警示意义的样本。
五、谷歌把Gemini接入Google钱包
谷歌将Gemini接入Google钱包,可以梳理消费图表、找出被遗忘的订阅与涨价项目,还能制定节日预算。官方强调该能力为只读,不能动用用户资金。
“只读”这个限定很关键,它划定了AI助手介入金融场景的边界:分析可以做,执行不行。从产品思路看,这是把大模型作为消费数据的解释层,而不是交易代理层。对普通用户来说,揪出遗忘订阅和隐性涨价是高频痛点,这类功能的实用价值往往高于宏大的金融叙事。
六、Thinking Machines公开Inkling 2 Small训练秘诀
慕拉蒂的Thinking Machines公开了Inkling 2 Small的训练方法:前向计算全程采用4比特预训练,预训练仅用68小时,而几个月前同等规模需要好几周。权重已经开源。
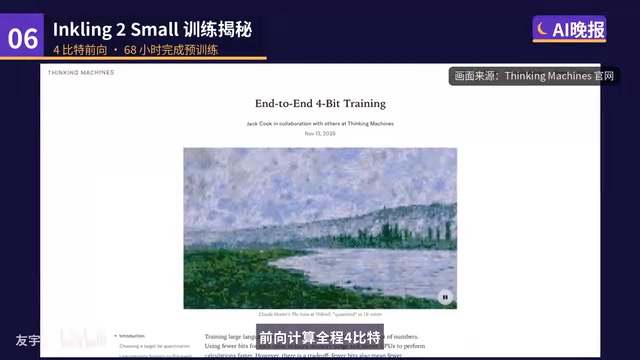
这条信息的技术含义在于,低精度训练正在从实验走向可复现的工程实践。68小时与“好几周”的对比是数量级层面的效率差异,权重开源则让社区可以直接验证。如果4比特全程前向计算能在更多架构上稳定复现,训练成本曲线会被显著改写。
4比特预训练是指在前向计算中使用4位浮点数(而非传统的16位或32位)来表示模型权重和激活值。位宽越低,模型占用的显存和带宽越小,单位算力能处理的吞吐量越高,从而显著缩短训练时间、降低成本。难点在于低精度会带来数值误差累积,可能导致训练不稳定或模型质量下降,因此需要配合特定的量化方案、缩放策略和数值稳定技术。如果4比特全程前向计算能够在不同架构上稳定复现,意味着同等硬件条件下可以训练更大模型或用更少时间完成同等规模训练,对训练成本曲线有直接影响。
七、本地推理工具Lauma发布1.0正式版
本地跑大模型的开源工具Lauma发布1.0正式版,支持150多种模型架构,接口从此按语义化版本管理。DeepSeek广告、通义千问广告和Kimi等模型均已覆盖。
1.0与语义化版本管理意味着这个项目从“能用”进入“可依赖”的阶段。支持150多种架构的广度,使其成为本地部署场景中兼容性较强的一层基础设施。对希望在本地运行开源模型的团队来说,版本管理的规范化比新增功能更有长期价值。
语义化版本管理(Semantic Versioning,简称SemVer)是一种广泛采用的版本号约定,格式为“主版本号.次版本号.修订号”。其规则是:不兼容的API变更时递增主版本号,向下兼容地新增功能时递增次版本号,仅做向下兼容的问题修复时递增修订号。对于本地推理工具而言,采用语义化版本意味着下游开发者和企业用户可以依据版本号判断升级是否安全,从而将这一工具纳入生产环境依赖。这标志着一个开源项目从实验性工具转变为可长期维护的基础设施组件。
一条主线:技术加速与金融焦虑同步升温
把7条动态放在一起,能看到两条并行曲线。一条是技术侧:通用模型吞噬垂直场景(OpenAI机器人团队)、训练效率数量级提升(Inkling 2 Small)、本地推理工具走向成熟(Lauma 1.0)。另一条是金融侧:87%的受访者把AI列为头号风险、算力债务是2023年全年的5倍、英伟达连跌6周。
两条曲线并不矛盾,反而互为因果——正是技术侧的加速扩张,推高了资本开支与债务规模,进而放大了市场对回报兑现的焦虑。短期内的观察窗口是英伟达即将发布的首份财报,而更长期的变量,是通用模型能否把技术优势转化为可持续的商业回报。
相关推荐

Gemini 4 Neon发布:前沿智能与高效任务执行的平衡之作
Google DeepMind 发布 Gemini 4 Neon,主打前沿智能与快速端到端任务执行。本文解析其在编程、企业分析、科学推理与网络安全上的基准表现、四档思考等级、定价与安全对齐数据。

AI是全球断网元凶?NSA、FAA接连宕机背后的信任危机
NSA机密网络五天内第四起重大故障,微软称软件bug、FAA否认新AI系统有关、NSA称例行维护。参议员沃纳提出AI加速漏洞发现导致仓促修复的另一种解释,而39%美国人对AI的负面看法让信任危机浮出水面。

机器人开发者自研B-rep内核,测试达3487项
机器人开发者自研B-rep几何内核并编写3,487项测试,探讨机器人领域为何需要专用CAD工具,以及自研内核的机遇与门槛。